ระบบ Machine Learning พยากรณ์ความผิดปกติของธุรกรรมล่วงหน้า สำหรับองค์กรในภาคการเงินของไทย
ลูกค้า: องค์กรในภาคการเงินของไทย
AIOP System คือระบบ Machine Learning (การเรียนรู้ของเครื่อง) ที่พยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรมในระบบธุรกรรมการเงินขนาดใหญ่ล่วงหน้า 5 และ 10 นาที ทั้งภาพรวม แยกตามเส้นทางรับส่งรายการ และแยกรายธนาคาร เราพัฒนาและติดตั้งระบบนี้บนเซิร์ฟเวอร์ขององค์กรในภาคการเงินของไทย และจัดทำเอกสารปิดโครงการในปี 2565
- อุตสาหกรรม
- การเงิน
- ปี
- 2564–2566
- ขอบเขตงาน
- ออกแบบ พัฒนา และติดตั้งระบบ Machine Learning พยากรณ์ความผิดปกติของธุรกรรมการเงินบนเซิร์ฟเวอร์ Production และ Development ของลูกค้า พร้อมระบบฝึกโมเดลใหม่ ระบบสำรองและกู้คืนข้อมูล การจัดเก็บข้อมูลเก่าอัตโนมัติ Grafana Dashboard เอกสารออกแบบระบบ เอกสารปิดโครงการในปี 2565 และการทดลองเทียบโมเดลอีก 3 แบบในปี 2566
สรุปสั้น
- AIOP System คือระบบ Machine Learning ที่พยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรมในระบบธุรกรรมการเงินขนาดใหญ่ล่วงหน้า 5 และ 10 นาที ทั้งภาพรวม แยกตามเส้นทางรับส่งรายการ และแยกรายธนาคาร
- ระบบติดตั้งบนเซิร์ฟเวอร์ Production และ Development ของลูกค้า แยกจากระบบรับส่งรายการ พร้อมระบบฝึกโมเดลใหม่ (Retrain) ระบบสำรองและกู้คืนข้อมูล และกราฟบน Grafana Dashboard
- เราจัดทำเอกสารปิดโครงการในปี 2565 แล้วโครงการเข้าสู่ช่วงบำรุงรักษาตามสัญญา ส่วนระบบทำงานต่อเนื่องเมื่อเครื่องหนึ่งขัดข้อง (HA) ยังอยู่ระหว่างทดสอบ ณ ช่วงปิดโครงการ
- ปี 2566 เราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นอีก 3 แบบ (CNN-LSTM, Random Forest และ XGBoost) เพื่อเทียบความแม่นยำในแต่ละช่วงเวลาพยากรณ์
- ระบบให้ค่าพยากรณ์และกราฟ ส่วนการตัดสินใจรับมือเป็นของทีมดูแลระบบ
โจทย์หน้างาน
ลูกค้าดูแลระบบงานและอุปกรณ์ไอทีในศูนย์คอมพิวเตอร์หลายแห่ง และต้องการรู้ล่วงหน้าเมื่อปริมาณรายการหรือเวลาตอบสนองของธุรกรรมเริ่มผิดไปจากปกติ แทนการรู้ตัวเมื่อปัญหาเกิดขึ้นแล้ว ระบบใหม่ต้องทำงานร่วมกับระบบเดิมโดยไม่กระทบการให้บริการ
สิ่งที่เราทำ
เราพัฒนาระบบ AIOP ที่ใช้โมเดล LSTM (โครงข่ายประสาทเทียมสำหรับข้อมูลที่เรียงตามเวลา) พยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรม (Response Time) ล่วงหน้า 5 และ 10 นาที และแสดงค่าจริงเทียบค่าพยากรณ์บน Grafana Dashboard (หน้าจอแสดงกราฟ) ระบบติดตั้งบนเซิร์ฟเวอร์ใช้งานจริง (Production) และเซิร์ฟเวอร์พัฒนาและทดสอบ (Development) ของลูกค้า แยกจากระบบรับส่งรายการ พร้อมระบบฝึกโมเดลใหม่ (Retrain) และระบบสำรองและกู้คืนข้อมูล
ผลลัพธ์
เราจัดทำเอกสารปิดโครงการ (Closing Project) ในปี 2565 ซึ่งสรุปผลการฝึกโมเดล ผลพยากรณ์แบบย้อนหลัง (Back-test) และแบบเวลาจริง (Real-time) ระบบสำรองข้อมูล และเอกสารออกแบบระบบ จากนั้นโครงการเข้าสู่ช่วงบำรุงรักษาตามสัญญา ในปี 2566 เราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นอีก 3 แบบ เพื่อเทียบความแม่นยำในแต่ละช่วงเวลาพยากรณ์
ที่มาของโจทย์
โจทย์ของเคสนี้คือการรู้ล่วงหน้าว่าธุรกรรมในระบบธุรกรรมการเงินขนาดใหญ่กำลังจะผิดปกติ แทนการรู้ตัวเมื่อปัญหาเกิดขึ้นแล้ว ลูกค้าเป็นองค์กรในภาคการเงินของไทย ที่ดูแลระบบงานและอุปกรณ์ไอทีในศูนย์คอมพิวเตอร์หลายแห่ง ลูกค้าต้องการระบบ Machine Learning (การเรียนรู้ของเครื่อง) ที่วิเคราะห์ คาดการณ์ และแจ้งเตือนเมื่อปริมาณรายการหรือเวลาตอบสนองของธุรกรรมเริ่มผิดไปจากปกติ
ระบบธุรกรรมการเงินขนาดใหญ่ต้องทำงานต่อเนื่อง เมื่อเวลาตอบสนองเริ่มช้าลง ผลกระทบไปถึงผู้ใช้จำนวนมากในเวลาเดียวกัน ค่าพยากรณ์ล่วงหน้าช่วยให้ทีมดูแลระบบมีเวลาตรวจว่าความผิดปกติเริ่มที่เส้นทางรับส่งรายการไหนหรือธนาคารใด ก่อนตัดสินใจว่าจะรับมืออย่างไร
AIOps คืออะไร
AIOps คือการใช้ AI และ Machine Learning ช่วยทีมไอทีเฝ้าระวังระบบ เช่น จับรูปแบบที่ผิดปกติจากข้อมูลการทำงานของระบบ แล้วแจ้งให้ทีมรู้ก่อนที่ผู้ใช้จะได้รับผลกระทบ ในเคสนี้ระบบมีชื่อว่า AIOP System
ข้อกำหนดและข้อจำกัด
ระบบต้องพยากรณ์จากข้อมูลธุรกรรมจริงของลูกค้า และต้องไม่กระทบการให้บริการของระบบเดิม ข้อกำหนดและข้อจำกัดหลักมีดังนี้
- ระบบใหม่ต้องทำงานร่วมกับระบบเดิมโดยไม่กระทบการให้บริการ ลูกค้ากำหนดข้อนี้ตั้งแต่ต้นโครงการ
- ระบบ ML ทำงานบนเซิร์ฟเวอร์ของลูกค้า ทั้งเซิร์ฟเวอร์ใช้งานจริง (Production) และเซิร์ฟเวอร์พัฒนาและทดสอบ (Development)
- ข้อมูลธุรกรรมต้องแปลงรูปแบบและทำความสะอาดก่อนใช้ฝึกโมเดล ในช่วงแรก การได้ข้อมูลครบและการเข้าถึงข้อมูลเป็นงานที่ใช้เวลามาก
- เอกสารข้อกำหนดของโครงการเป็นความลับของลูกค้า
ทำไมเราเลือกโมเดล LSTM และติดตั้งแยกจากระบบรับส่งรายการ
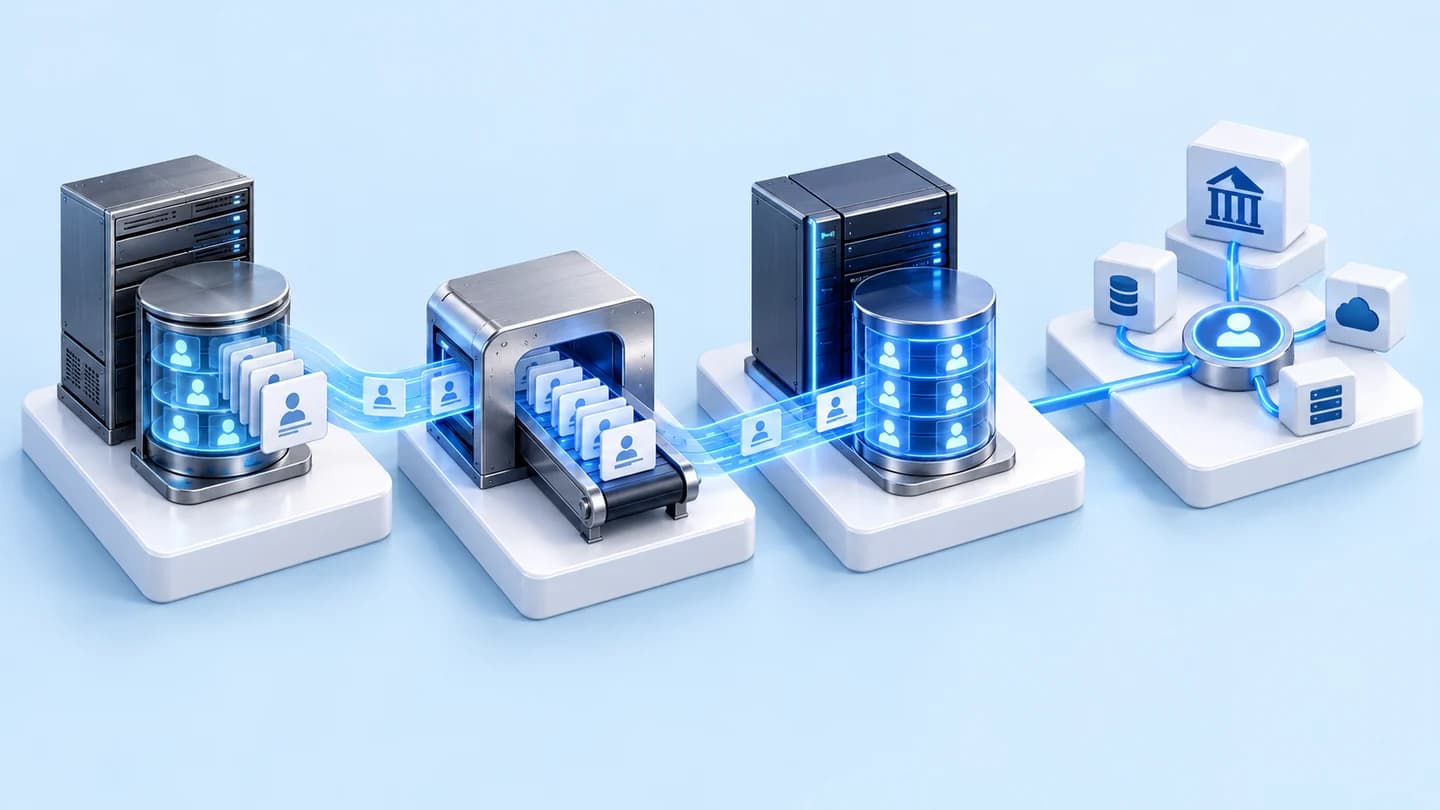
เราเลือก LSTM เพราะเป็นโครงข่ายประสาทเทียมที่เหมาะกับข้อมูลที่เรียงตามเวลา และเวลาตอบสนองของธุรกรรมเป็นข้อมูลแบบนี้ เราติดตั้งระบบ ML บนเซิร์ฟเวอร์แยกจากระบบรับส่งรายการ เพราะลูกค้ากำหนดว่าระบบใหม่ต้องไม่กระทบการให้บริการ ระบบ ML จึงรับข้อมูลธุรกรรมจากระบบเดิมมาวิเคราะห์
- 1
รวบรวมและทำความสะอาดข้อมูล
เรานำข้อมูลธุรกรรมจากระบบรับส่งรายการของลูกค้ามาแปลงรูปแบบ ตรวจความต่อเนื่อง และตัดข้อมูลที่ใช้ไม่ได้ออก ก่อนส่งเข้าขั้นฝึกโมเดล
- 2
ฝึกโมเดล LSTM
โมเดลเรียนรู้รูปแบบเวลาตอบสนองของธุรกรรม แล้วระบบบันทึกไฟล์โมเดลและรายงานผลการฝึกไว้บนเซิร์ฟเวอร์
- 3
พยากรณ์ล่วงหน้า 5 และ 10 นาที
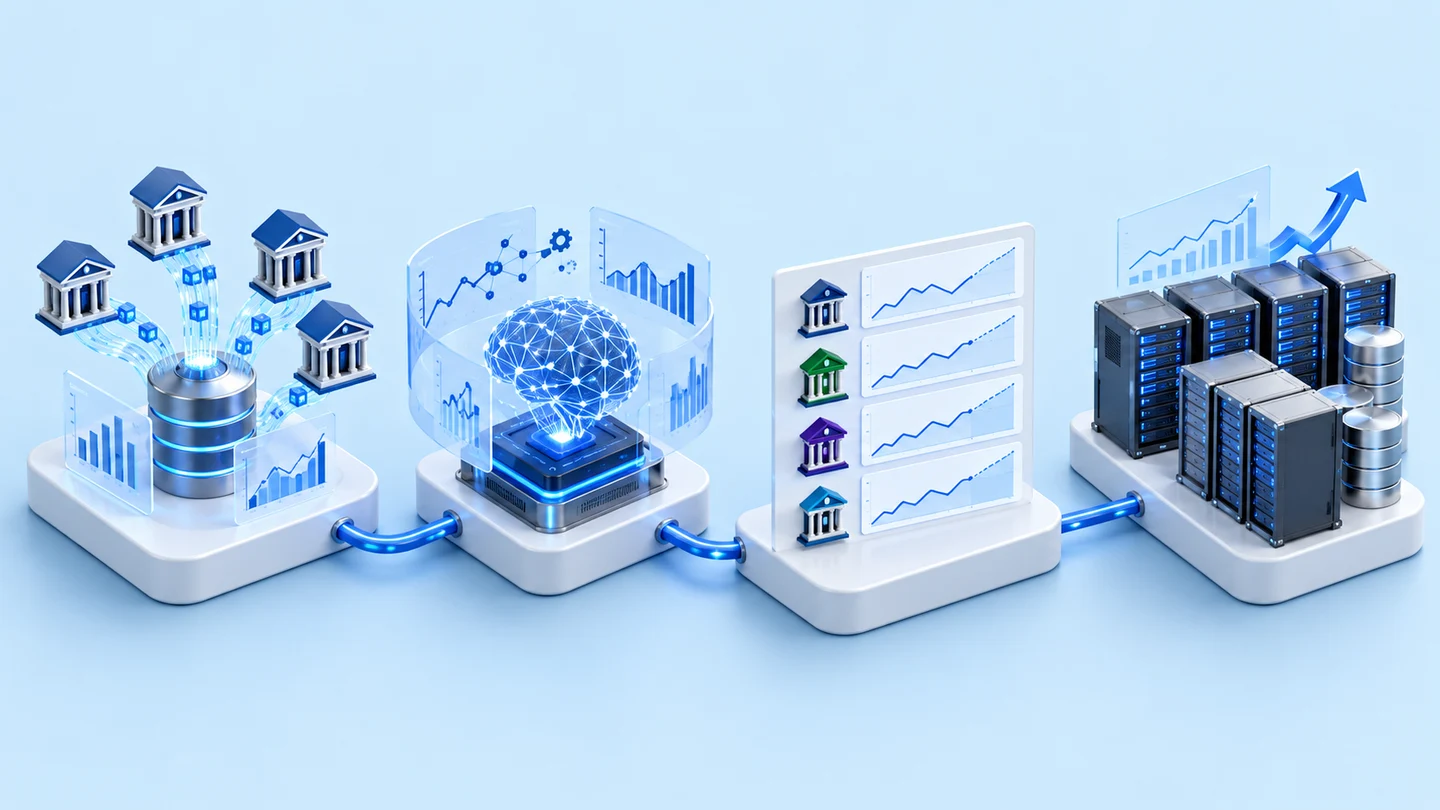
โมเดลพยากรณ์ทั้งแบบภาพรวม แยกตามเส้นทางรับส่งรายการ และแยกรายธนาคาร เราทดสอบผลพยากรณ์ทั้งแบบย้อนหลังกับข้อมูลเก่า (Back-test) และแบบเวลาจริง (Real-time)
- 4
แสดงผลบนแดชบอร์ด
กราฟบน Grafana Dashboard เทียบค่าจริงกับค่าพยากรณ์และค่าสถิติ ทีมดูแลระบบติดตามได้จากหน้าจอเดียว
- 5
ดูแลระบบให้พร้อมใช้งาน
ระบบฝึกโมเดลใหม่ (Retrain) ใช้ปรับโมเดลเมื่อมีข้อมูลใหม่ ระบบสำรองและกู้คืนข้อมูลกับการจัดเก็บข้อมูลเก่าอัตโนมัติช่วยไม่ให้พื้นที่เซิร์ฟเวอร์เต็ม
สิ่งที่ติดตั้งและสรุปในเอกสารปิดโครงการ
งานที่ติดตั้งบนเซิร์ฟเวอร์ Production และ Development ของลูกค้า และสรุปไว้ในเอกสารปิดโครงการมีดังนี้
- โมเดล LSTM ที่ฝึกแล้ว พร้อมรายงานผลการฝึก
- ระบบพยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรมล่วงหน้า 5 และ 10 นาที ที่ทดสอบทั้งแบบ Back-test และ Real-time
- Grafana Dashboard แสดงกราฟค่าจริงเทียบค่าพยากรณ์และค่าสถิติ
- ระบบฝึกโมเดลใหม่ (Retrain)
- ระบบสำรองและกู้คืนข้อมูล (Backup & Restore) และการจัดเก็บข้อมูลเก่าอัตโนมัติ
- เอกสารออกแบบระบบ และเอกสารปิดโครงการ
สถานะของระบบ HA
ระบบยังออกแบบให้ทำงานต่อได้เมื่อเครื่องหนึ่งขัดข้อง (High Availability หรือ HA) แต่ ณ ช่วงปิดโครงการ HA ยังอยู่ระหว่างทดสอบบนเครื่องของลูกค้า เราจึงไม่นับ HA เป็นงานที่เสร็จแล้ว
ขั้นตอนของโครงการ
โครงการดำเนินการตั้งแต่ปี 2564 ถึงปี 2566 ดังนี้
- ปี 2564: เริ่มโครงการ รวบรวมและแปลงข้อมูลธุรกรรมสำหรับฝึกโมเดล
- ปี 2565: จัดทำเอกสารปิดโครงการ แล้วเข้าสู่ช่วงบำรุงรักษาตามสัญญา
- ปี 2566: ทดลองฝึกโมเดลใหม่ด้วย CNN-LSTM, Random Forest และ XGBoost เพื่อเทียบความแม่นยำในแต่ละช่วงเวลาพยากรณ์
ผลที่ยืนยันได้จากเอกสารปิดโครงการ
เราพัฒนาระบบ Machine Learning ที่พยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรมล่วงหน้า 5 และ 10 นาที ให้องค์กรในภาคการเงินของไทย และจัดทำเอกสารปิดโครงการในปี 2565 เอกสารนี้สรุปผลการฝึกโมเดล ผลพยากรณ์แบบ Back-test และ Real-time ระบบสำรองข้อมูล และเอกสารออกแบบระบบ เคสนี้ไม่มีตัวเลขวัดผลที่เผยแพร่ได้ เราจึงรายงานเฉพาะสิ่งที่มีเอกสารยืนยัน
ในปี 2566 เราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นอีก 3 แบบ คือ CNN-LSTM, Random Forest และ XGBoost เพื่อเทียบความแม่นยำในแต่ละช่วงเวลาพยากรณ์ ข้อแนะนำจากการทดลองคือฝึกโมเดลเพิ่มเติมเพื่อความแม่นยำที่สูงขึ้น และพิจารณาใช้ข้อมูลฮาร์ดแวร์ของเซิร์ฟเวอร์เป็นอินพุตเพิ่ม
สิ่งที่เราเรียนรู้
งานนี้ให้หลักการ 3 ข้อสำหรับงานพยากรณ์ความผิดปกติของระบบไอที
- ความพร้อมของข้อมูลกำหนดตารางงานมากกว่าการเลือกโมเดล ในงานนี้ การได้ข้อมูลธุรกรรมครบและแปลงให้ใช้ได้เป็นงานหลักของช่วงแรก จึงควรตกลงสิทธิ์เข้าถึงข้อมูลและตรวจตัวอย่างข้อมูลจริงก่อนวางกำหนดส่งงาน
- ระบบที่ห้ามกระทบการให้บริการ ควรแยกส่วนพยากรณ์ไว้บนเซิร์ฟเวอร์ของตัวเอง และให้รับข้อมูลจากระบบหลักมาวิเคราะห์ การแยกเซิร์ฟเวอร์ทำให้ฝึกโมเดลใหม่ได้โดยไม่แตะระบบหลัก
- โมเดลพยากรณ์ต้องมีแผนดูแลหลังติดตั้ง ผลพยากรณ์ต้องตรวจทั้งแบบย้อนหลังและแบบเวลาจริง และต้องมีระบบฝึกโมเดลใหม่ตั้งแต่ต้น ส่วนใดที่ยังทดสอบไม่จบ เช่น HA ต้องระบุสถานะให้ชัดในเอกสารปิดโครงการ
นำแนวทางนี้ไปใช้กับระบบของคุณได้อย่างไร
ถ้าองค์กรของคุณมีข้อมูลการทำงานของระบบที่เรียงตามเวลา และต้องการสัญญาณเตือนล่วงหน้า คุณใช้แนวทางเดียวกับเคสนี้ได้ คือแยกระบบพยากรณ์ไว้บนเซิร์ฟเวอร์ของคุณเอง ฝึกโมเดลจากข้อมูลจริง และแสดงค่าจริงเทียบค่าพยากรณ์บนแดชบอร์ด ส่วนที่ต้องปรับคือข้อมูลนำเข้า ช่วงเวลาพยากรณ์ และวิธีวัดผล
ส่วนที่ใช้ซ้ำได้ และส่วนที่ต้องปรับ
| ส่วนของระบบ | ใช้ซ้ำได้ | ต้องปรับเมื่อ |
|---|---|---|
| ข้อมูลนำเข้า | ข้อมูลเวลาตอบสนองของธุรกรรมที่เรียงตามเวลา | ระบบของคุณเก็บข้อมูลคนละรูปแบบ หรือข้อมูลย้อนหลังไม่ต่อเนื่อง ต้องตรวจและแปลงข้อมูลก่อน |
| โมเดล | LSTM สำหรับข้อมูลอนุกรมเวลา และการเทียบกับอัลกอริทึมอื่น | ข้อมูลหรือช่วงเวลาพยากรณ์ต่างจากเคสนี้ ต้องฝึกและเทียบโมเดลใหม่ |
| ช่วงเวลาพยากรณ์ | ล่วงหน้า 5 และ 10 นาที | ทีมของคุณต้องการเวลาเตรียมรับมือต่างจากนี้ ต้องตกลงช่วงเวลาและวิธีวัดผลใหม่ |
| การแสดงผล | Grafana Dashboard เทียบค่าจริงกับค่าพยากรณ์ | ทีมของคุณใช้เครื่องมือเฝ้าระวังอื่นอยู่แล้ว ต้องตกลงว่าจะแสดงค่าพยากรณ์ที่ไหน |
| การติดตั้งและดูแล | เซิร์ฟเวอร์ของลูกค้า ระบบ Retrain และระบบสำรองข้อมูล | ยังไม่มีเซิร์ฟเวอร์แยก หรือต้องการ HA ต้องวางแผนและทดสอบเพิ่ม |
- เตรียมสิทธิ์เข้าถึงข้อมูลธุรกรรมและข้อมูลย้อนหลังให้พร้อมตั้งแต่ต้น และตรวจความครบถ้วนกับความต่อเนื่องของข้อมูล
- ตกลงร่วมกันว่าจะวัดความแม่นยำอย่างไร ทั้งแบบย้อนหลังและแบบเวลาจริง และใช้ช่วงเวลาพยากรณ์ล่วงหน้าเท่าไร
- กำหนดขอบเขตงานบำรุงรักษาหลังติดตั้งให้ชัด เช่น รอบตรวจผลพยากรณ์และรอบฝึกโมเดลใหม่
- พิจารณาเพิ่มข้อมูลฮาร์ดแวร์ของเซิร์ฟเวอร์เป็นอินพุตของโมเดล ตามข้อแนะนำจากการทดลองในปี 2566
เทคโนโลยีที่ใช้
คำถามที่พบบ่อย
ระบบนี้พยากรณ์อะไร และล่วงหน้ากี่นาที
ระบบพยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรม (Response Time) ล่วงหน้า 5 และ 10 นาที ทั้งแบบภาพรวม แยกตามเส้นทางรับส่งรายการ และแยกรายธนาคาร ระบบให้ค่าพยากรณ์และกราฟ ส่วนการตัดสินใจรับมือเป็นของทีมดูแลระบบ
ต้องแก้ไขระบบเดิมหรือไม่
ในเคสนี้ ระบบ ML ติดตั้งบนเซิร์ฟเวอร์ Production และ Development ของลูกค้า แยกจากระบบรับส่งรายการ และรับข้อมูลธุรกรรมจากระบบนั้นมาวิเคราะห์ การไม่กระทบการให้บริการเป็นข้อกำหนดของลูกค้าตั้งแต่ต้น สำหรับระบบของคุณ เราต้องดูระบบจริงก่อนจึงบอกได้ว่าต้องปรับส่วนใดบ้าง
ใช้โมเดล AI แบบไหน
ระบบในเคสนี้ใช้โมเดล LSTM ซึ่งเหมาะกับข้อมูลที่เรียงตามเวลา ในปี 2566 เราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นอีก 3 แบบ (CNN-LSTM, Random Forest และ XGBoost) เพื่อเทียบความแม่นยำในแต่ละช่วงเวลาพยากรณ์
หลังติดตั้งแล้วดูแลระบบอย่างไร
หลังจัดทำเอกสารปิดโครงการในปี 2565 โครงการเข้าสู่ช่วงบำรุงรักษาตามสัญญา ในปี 2566 เราทดลองฝึกโมเดลใหม่ และแนะนำให้ฝึกโมเดลเพิ่มเติมเพื่อความแม่นยำที่สูงขึ้น และพิจารณาใช้ข้อมูลฮาร์ดแวร์ของเซิร์ฟเวอร์เป็นอินพุตเพิ่ม
ถ้าต้องการระบบลักษณะนี้ ราคาเท่าไร
ไม่มีราคามาตรฐาน เราประเมินจากชนิดและปริมาณข้อมูล ช่วงเวลาที่ต้องการพยากรณ์ และสภาพเซิร์ฟเวอร์ที่จะติดตั้ง ติดต่อเราเพื่อขอใบเสนอราคา