Predictive Analytics
นำข้อมูลจากเซ็นเซอร์ เครื่องจักร หรือระบบไอทีมาวิเคราะห์ผ่าน Nimitflow ตั้งแต่รับและบันทึกข้อมูล วิเคราะห์สัญญาณด้วย FFT ไปจนถึงพัฒนาโมเดล Machine Learning ตามโจทย์ขององค์กร ผลลัพธ์เชื่อมต่อเป็นแดชบอร์ด รายงาน และการแจ้งเตือนให้ทีมใช้ติดตามแนวโน้มและวางแผนงาน
สำรวจการใช้งานและรายละเอียด
- พยากรณ์ความผิดปกติและแนวโน้มจากข้อมูลย้อนหลังและข้อมูลต่อเนื่อง ด้วย Machine Learning
- ทดสอบโมเดลทั้งกับข้อมูลย้อนหลัง (Back-test) และข้อมูลเวลาจริง (Real-time) ก่อนใช้งาน
- ติดตั้งบนเซิร์ฟเวอร์ขององค์กร (On-Premise) แยกจากระบบงานเดิมได้
ดูคุณสมบัติเพิ่มเติม
- กราฟเทียบค่าจริงกับค่าพยากรณ์ และแจ้งเตือนทางอีเมลหรือช่องทางที่องค์กรใช้อยู่
- ฝึกโมเดลใหม่ (Retrain) เมื่อข้อมูลหรือพฤติกรรมของระบบเปลี่ยน
- เริ่มทุกโครงการจากการประเมินความพร้อมของข้อมูล
เหมาะกับงานของคุณหรือไม่?
เหมาะกับใคร
ทีมวิเคราะห์ข้อมูล ฝ่ายผลิต และทีมซ่อมบำรุงที่มีข้อมูลย้อนหลัง และต้องการพยากรณ์แนวโน้ม
เตรียมข้อมูลก่อนคุย
เป้าหมายการพยากรณ์ ตัวอย่างข้อมูลย้อนหลัง และวิธีวัดผลที่ต้องการ
สรุปสั้น
- Predictive Analytics คือซอฟต์แวร์วิเคราะห์เชิงพยากรณ์ที่ Inspektion พัฒนาโมเดล Machine Learning ตามข้อมูลของแต่ละองค์กร เพื่อจับความผิดปกติและแนวโน้มก่อนปัญหาเกิด แล้วแสดงกราฟและแจ้งเตือนให้ทีมของคุณตัดสินใจ
- Inspektion พัฒนาและติดตั้งระบบ Machine Learning ที่พยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรมล่วงหน้า 5 และ 10 นาที ให้ลูกค้าในอุตสาหกรรมการเงินในไทย บนเซิร์ฟเวอร์ของลูกค้า และจัดทำเอกสารปิดโครงการในปี 2565
- งานในโรงงานที่เกี่ยวข้องคือระบบนับช็อตแม่พิมพ์และเตือนรอบบำรุงรักษา ที่ Inspektion ส่งมอบให้ผู้ผลิตชิ้นส่วนยานยนต์ในไทยและกัมพูชาในปี 2564–2565 งานนี้เป็นการเตือนตามเกณฑ์ ยังไม่ใช่โมเดลพยากรณ์
- ทุกโครงการเริ่มจากประเมินความพร้อมของข้อมูล เพราะความแม่นยำของการพยากรณ์ขึ้นกับความครบถ้วนของข้อมูล และโมเดลต้องฝึกใหม่เมื่อข้อมูลเปลี่ยน
- เลือกระบบตามงาน: เฝ้าดูสภาพเครื่องจากเซนเซอร์วัดการสั่นสะเทือนโดยตรงใช้ InCBM พยากรณ์จากข้อมูลหลายแหล่งใช้ Predictive Analytics และถ้าข้อมูลกระจายอยู่หลายระบบ ให้เริ่มจาก Data Lakehouse (ระบบรวมข้อมูลหลายแหล่งให้พร้อมวิเคราะห์) ก่อน
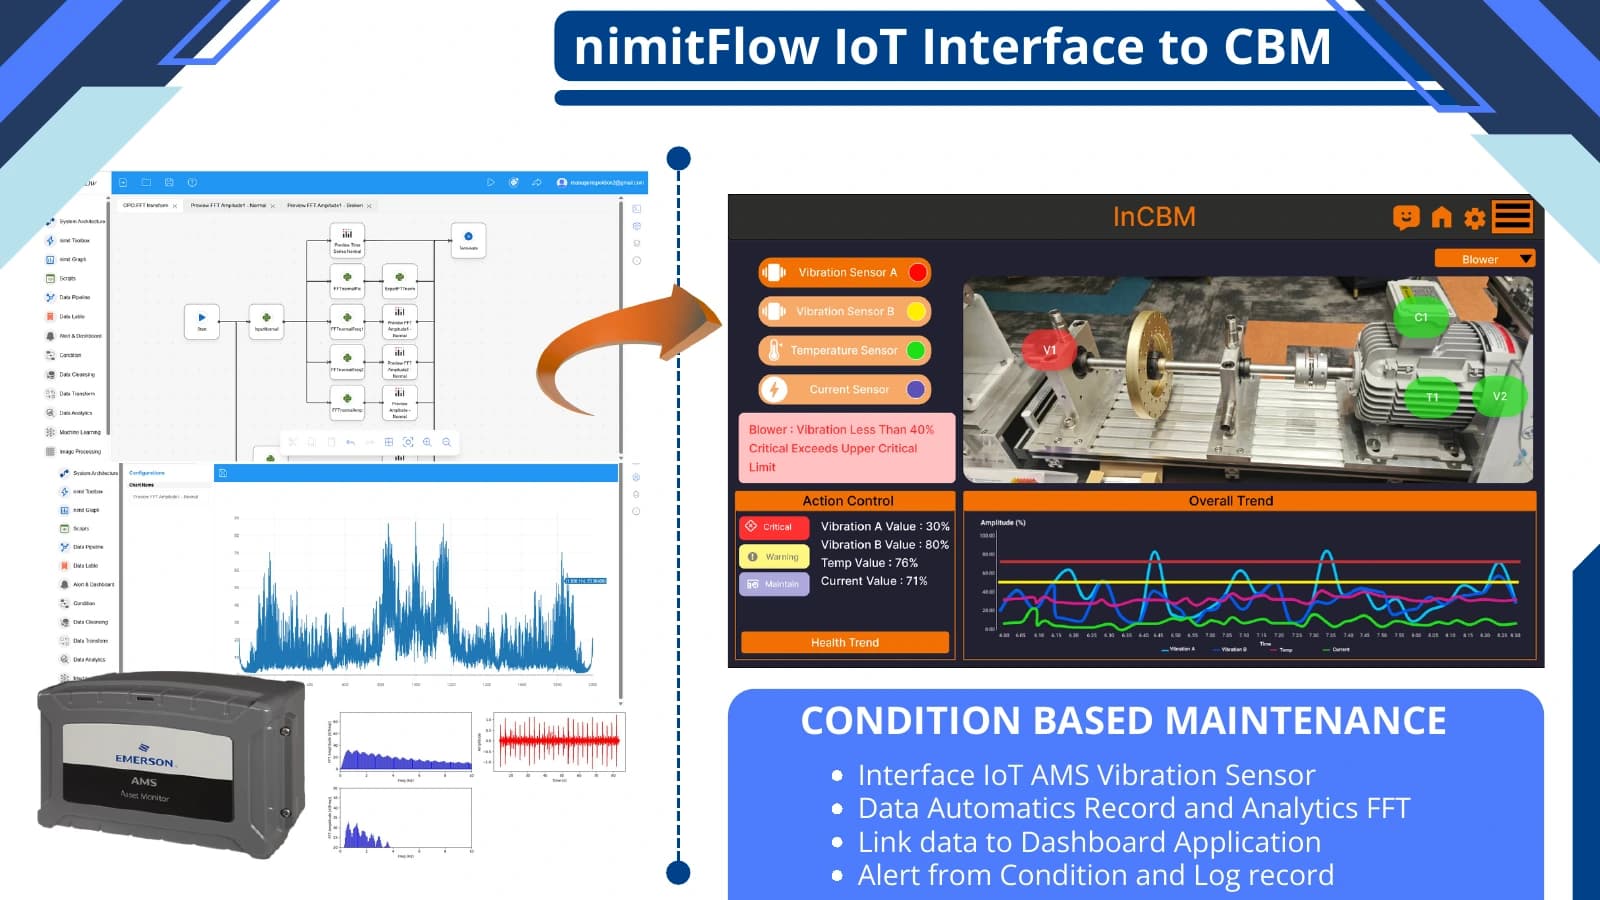
จากข้อมูลเซ็นเซอร์ สู่กราฟและการแจ้งเตือน
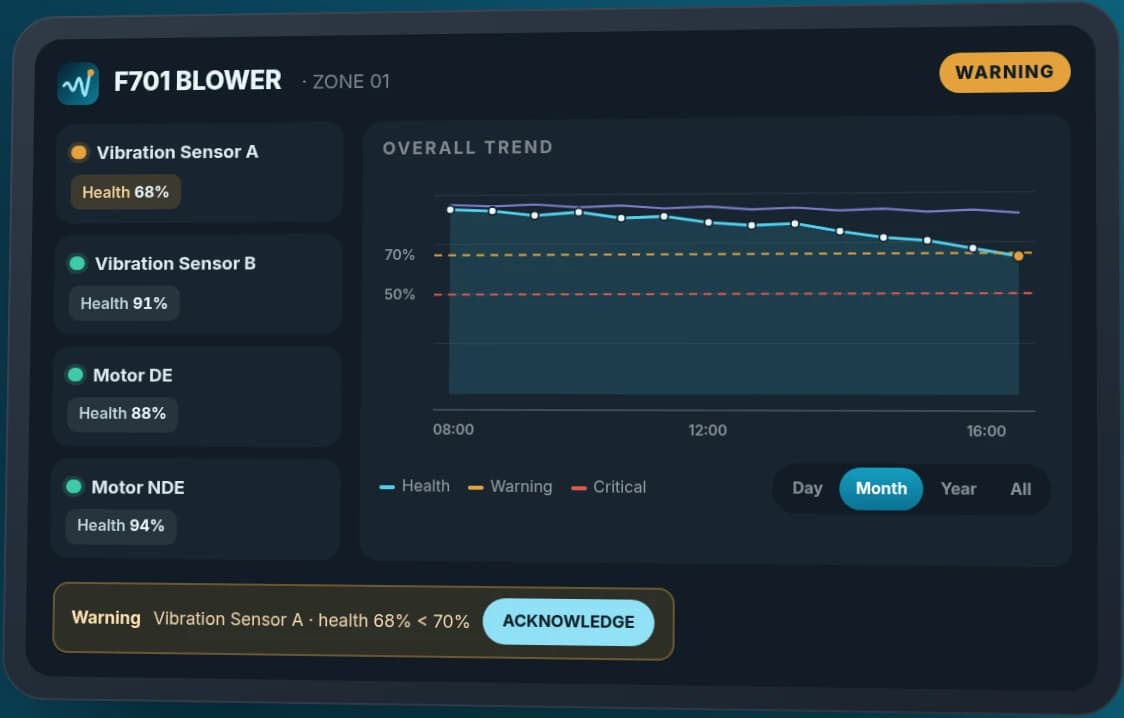
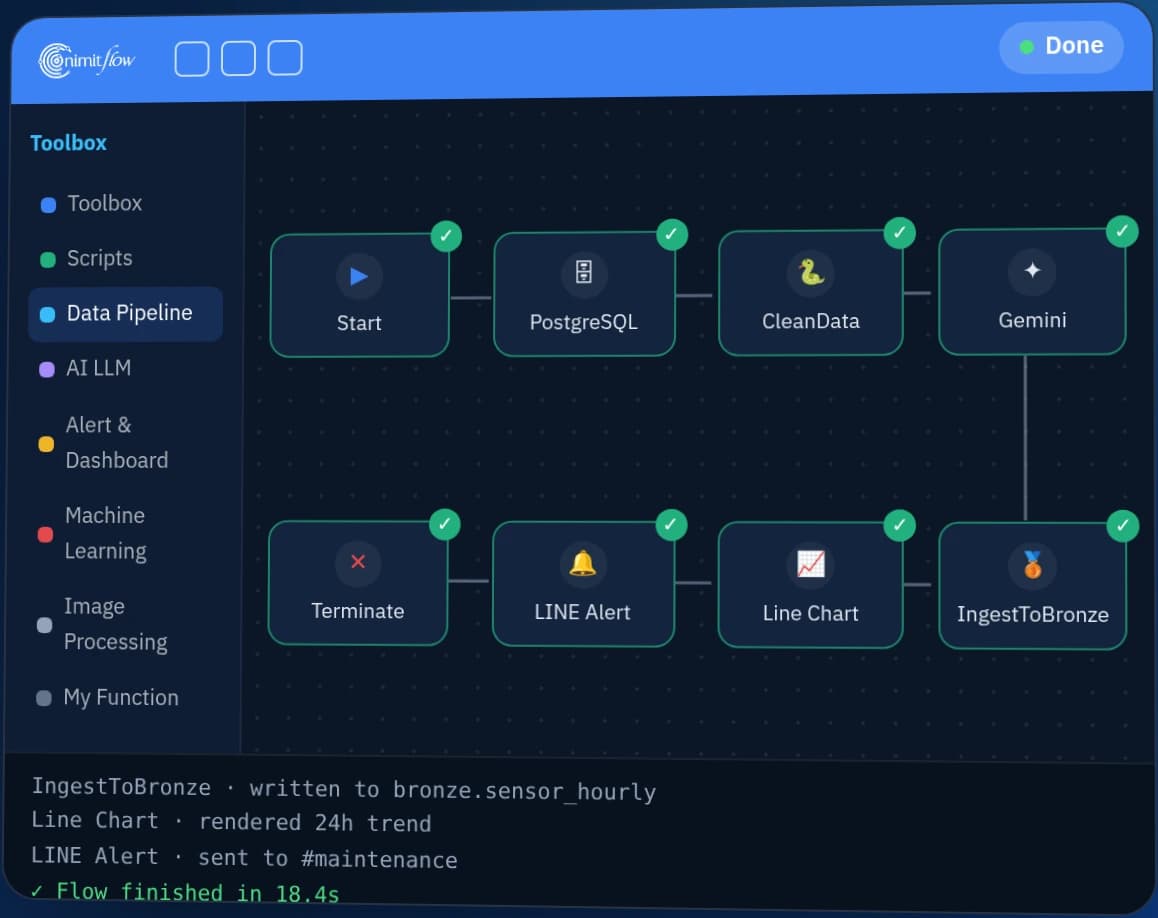
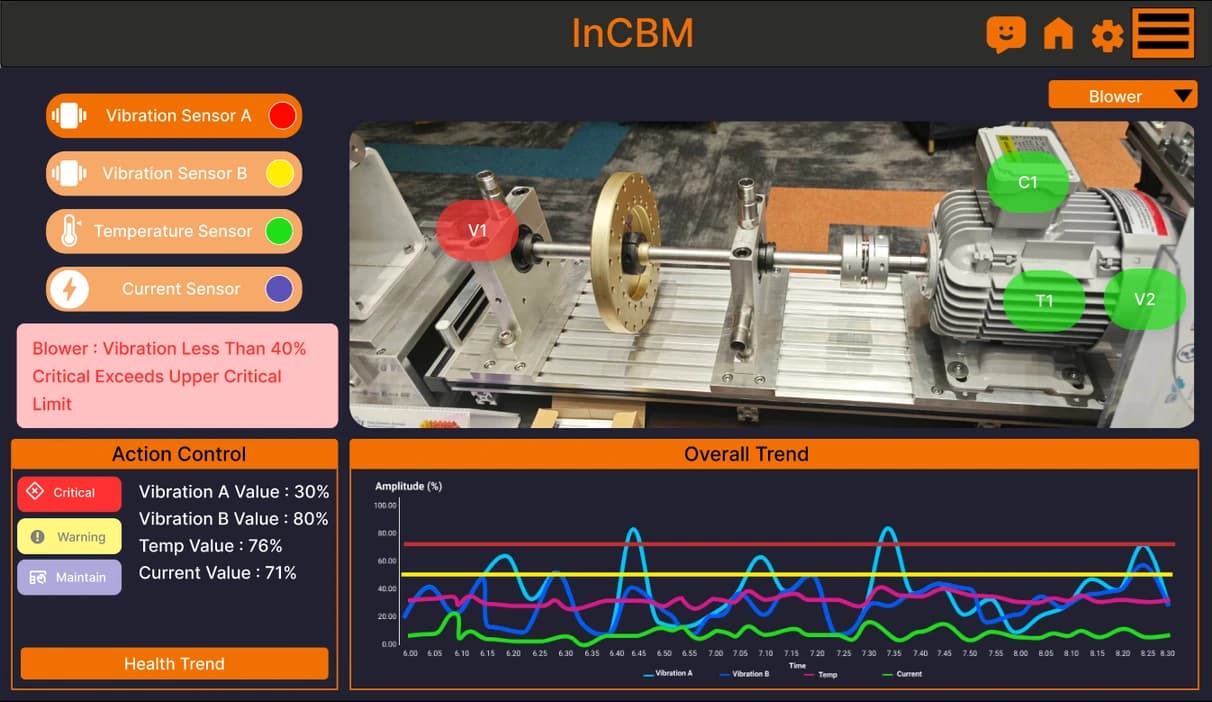
ตัวอย่างในเอกสาร Nimitflow แสดงการรับข้อมูลจากอุปกรณ์วัดการสั่นสะเทือน AMS แล้วบันทึกและวิเคราะห์ FFT (การแยกสัญญาณตามความถี่) ก่อนส่งต่อไปยังแดชบอร์ด InCBM เพื่อดูกราฟ แนวโน้ม และประวัติการเตือน
- 1
รับและจัดเก็บข้อมูล
เชื่อมเซ็นเซอร์หรือแหล่งข้อมูลเข้ากับ Workflow ใน Nimitflow เพื่อบันทึกข้อมูลและประวัติอย่างต่อเนื่อง
- 2
วิเคราะห์สัญญาณและพัฒนาโมเดล
ใช้ FFT ตรวจองค์ประกอบความถี่ของสัญญาณ และเตรียมข้อมูลสำหรับฝึก Machine Learning ตามโจทย์ที่ต้องการพยากรณ์ โดยทดสอบผลก่อนนำไปใช้งาน
- 3
แสดงผลและส่งต่อให้ทีม
เชื่อมผลลัพธ์เข้าหน้าจอ Dashboard เช่น InCBM หรือ Grafana พร้อมเงื่อนไขแจ้งเตือน บันทึกเหตุการณ์ และรายงานตามขอบเขตระบบ
เลือกวิธีวิเคราะห์ให้ตรงกับงาน
FFT และการเตือนตามเกณฑ์เป็นส่วนของการวิเคราะห์สัญญาณและเฝ้าระวังสภาพ ส่วนการพยากรณ์ด้วย Machine Learning ต้องมีข้อมูลสำหรับฝึกและตรวจสอบโมเดล ภาพตัวอย่างนี้จึงใช้อธิบายการเชื่อมระบบ ไม่ใช่หลักฐานความแม่นยำของโมเดล
Predictive Analytics เหมาะกับใคร และแก้ปัญหาอะไร
Predictive Analytics เหมาะกับทีมที่มีข้อมูลย้อนหลังจากเครื่องจักร กระบวนการผลิต หรือระบบไอทีอยู่แล้ว และต้องการรู้สัญญาณผิดปกติก่อนปัญหาเกิด ระบบใช้ Machine Learning (การเรียนรู้ของเครื่อง) เรียนรู้รูปแบบจากข้อมูลเดิม แล้วพยากรณ์ค่าข้างหน้า เมื่อค่าที่พยากรณ์ได้เข้าเกณฑ์ที่ตั้งไว้ ระบบแจ้งเตือนให้ทีมตรวจสอบ
หลายองค์กรรู้ว่ามีปัญหาเมื่อเครื่องหยุดหรือเกิดของเสียไปแล้ว หรือบำรุงรักษาตามรอบเวลาโดยไม่ได้ดูสภาพจริง สัญญาณล่วงหน้ามักอยู่ในข้อมูลที่ระบบเดิมเก็บไว้แล้ว Predictive Analytics นำข้อมูลนั้นมาวิเคราะห์ต่อเนื่อง และให้ทีมของคุณเป็นผู้ตัดสินใจว่าจะรับมืออย่างไร
งานที่ Predictive Analytics ทำได้
- พยากรณ์การบำรุงรักษา (Predictive Maintenance) — วิเคราะห์ข้อมูลจากเครื่องจักร เช่น จำนวนช็อตของเครื่องฉีดพลาสติก เพื่อแจ้งกำหนดบำรุงรักษาเชิงป้องกันล่วงหน้า
- พยากรณ์แนวโน้มคุณภาพ — ดูแนวโน้มจากข้อมูลกระบวนการผลิตต่อเนื่อง เพื่อปรับกระบวนการก่อนเกิดของเสียจริง
- ตรวจจับความผิดปกติ (Anomaly Detection) — พยากรณ์ค่าล่วงหน้า แล้วแสดงกราฟเทียบค่าจริงกับค่าพยากรณ์
- แจ้งเตือน — ส่งถึงทีมที่เกี่ยวข้องทางอีเมลหรือช่องทางที่องค์กรใช้อยู่ เมื่อค่าที่วิเคราะห์ได้เข้าเกณฑ์ที่ต้องดำเนินการ
| ปัญหาที่พบบ่อย | Predictive Analytics ช่วยอย่างไร |
|---|---|
| รู้ว่ามีปัญหาเมื่อเหตุเกิดขึ้นแล้ว | พยากรณ์ค่าล่วงหน้า ทีมจึงมีเวลาตรวจก่อนถึงเวลาจริง |
| บำรุงรักษาตามรอบเวลา ไม่ได้ดูการใช้งานจริง | เริ่มจากเตือนตามจำนวนช็อตจริง แล้วใช้ข้อมูลที่สะสมไว้พยากรณ์ต่อ |
| มีข้อมูลอยู่ แต่ไม่มีใครดูต่อเนื่อง | วิเคราะห์ต่อเนื่อง และแสดงกราฟเทียบค่าจริงกับค่าพยากรณ์บนหน้าจอแสดงกราฟ (Dashboard) |
| ข้อมูลออกนอกองค์กรไม่ได้ | ติดตั้งบนเซิร์ฟเวอร์ขององค์กร (On-Premise) |
การพยากรณ์ต่างจากการเตือนตามเกณฑ์อย่างไร
การเตือนตามเกณฑ์ (Threshold Alert) เตือนเมื่อค่าปัจจุบันถึงตัวเลขที่ตั้งไว้ เช่น จำนวนช็อตถึงรอบบำรุงรักษา ส่วนการพยากรณ์ใช้โมเดลคาดการณ์ค่าข้างหน้าจากรูปแบบในข้อมูลเดิม แล้วเตือนก่อนค่าจริงจะผิดปกติ งานที่ยังมีข้อมูลสะสมไม่พอเริ่มจากการเตือนตามเกณฑ์ก่อนได้
Predictive Analytics ทำงานอย่างไร
Predictive Analytics ทำงานเป็น 5 ขั้น คือ ประเมินข้อมูล เตรียมข้อมูล ฝึกและทดสอบโมเดล ติดตั้งพร้อมแจ้งเตือน และดูแลโมเดลหลังใช้งาน ขั้นแรกกำหนดขอบเขตของทั้งโครงการ เพราะข้อมูลที่มีกำหนดว่าพยากรณ์ล่วงหน้าได้แค่ไหน
- 1
สำรวจและประเมินความพร้อมของข้อมูล
เราดูเป้าหมายการพยากรณ์ ตัวอย่างข้อมูลย้อนหลัง และวิธีวัดผลที่คุณต้องการ เพื่อประเมินว่าข้อมูลพอสำหรับการพยากรณ์หรือยัง
- 2
เตรียมและทำความสะอาดข้อมูล
ดึงข้อมูลจากระบบต้นทาง ตัดค่าที่ผิดพลาดหรือขาดหาย แล้วจัดให้อยู่ในรูปแบบที่ใช้ฝึกโมเดลได้
- 3
ฝึกและทดสอบโมเดล
ฝึกโมเดลพยากรณ์อนุกรมเวลา (Time-series คือข้อมูลที่เรียงตามเวลา) แล้วทดสอบทั้งกับข้อมูลย้อนหลัง (Back-test) และข้อมูลเวลาจริง (Real-time) ก่อนใช้งาน
- 4
ติดตั้งและแจ้งเตือน
ติดตั้งบนเซิร์ฟเวอร์ขององค์กร แสดงกราฟเทียบค่าจริงกับค่าพยากรณ์บน Dashboard และส่งแจ้งเตือนเมื่อค่าเข้าเกณฑ์ที่ตั้งไว้
- 5
ดูแลและฝึกโมเดลใหม่
ตรวจข้อมูลและกราฟพยากรณ์เป็นรอบ และฝึกโมเดลใหม่ (Retrain) เมื่อข้อมูลหรือพฤติกรรมของระบบเปลี่ยน
ระบบแสดงผลและแจ้งเตือนเท่านั้น ไม่สั่งหยุดเครื่องหรือเปลี่ยนค่าการทำงานเอง เมื่อได้รับแจ้งเตือน ทีมของคุณเป็นผู้ตัดสินใจว่าจะตรวจ ซ่อม หรือปรับกระบวนการ
Predictive Analytics เหมาะกับงานไหน และไม่เหมาะกับงานไหน
Predictive Analytics เหมาะกับงานที่มีข้อมูลย้อนหลังต่อเนื่อง มีเป้าหมายการพยากรณ์ชัด และมีผู้รับผิดชอบเมื่อระบบแจ้งเตือน Predictive Analytics ไม่เหมาะกับงานที่ยังไม่มีข้อมูลบันทึกไว้ หรือคาดหวังให้ระบบตัดสินใจแทนทีม ในกรณีนั้นให้เริ่มจากเก็บข้อมูลหรือเตือนตามเกณฑ์ก่อน
| งาน | เหมาะกับ Predictive Analytics ไหม | เหตุผลหรือสิ่งที่ต้องทำ |
|---|---|---|
| พยากรณ์ความผิดปกติจากข้อมูลที่บันทึกตามเวลาต่อเนื่อง เช่น ข้อมูลธุรกรรมหรือข้อมูลการทำงานของระบบ | เหมาะ | เป็นลักษณะงานเดียวกับเคสระบบธุรกรรมในอุตสาหกรรมการเงิน ที่ใช้โมเดลพยากรณ์อนุกรมเวลา |
| ข้อมูลออกนอกองค์กรไม่ได้ | เหมาะ | ติดตั้งบนเซิร์ฟเวอร์ขององค์กร แยกจากระบบงานเดิม |
| กำหนดรอบบำรุงรักษาแม่พิมพ์จากจำนวนช็อต | เริ่มจากการเตือนตามเกณฑ์ | ถ้าเครื่องเก็บข้อมูลช็อตไว้ในไฟล์แล้ว การนับช็อตและเตือนตามรอบทำได้โดยยังไม่ต้องใช้โมเดล |
| พยากรณ์แนวโน้มคุณภาพหรือการบำรุงรักษาในสายการผลิตด้วยโมเดล | ทำได้ ยังไม่มีเคสที่ส่งมอบ | งานที่ส่งมอบแล้วในโรงงานเป็นการเตือนตามเกณฑ์ เราประเมินจากข้อมูลจริงของคุณในขั้นสำรวจก่อน |
| ข้อมูลกระจายอยู่หลายระบบ | ทำได้ เมื่อรวมข้อมูลก่อน | วางโครงสร้างข้อมูลด้วย Data Lakehouse ก่อน เพื่อให้โมเดลได้ข้อมูลที่ครบและสม่ำเสมอ |
| เฝ้าดูสภาพมอเตอร์จากเซนเซอร์วัดการสั่นสะเทือน | ใช้ InCBM | InCBM สรุปค่าสุขภาพรายเซนเซอร์ และตั้งเกณฑ์ Warning/Critical เองได้ |
| ยังไม่มีข้อมูลย้อนหลัง หรือบันทึกบนกระดาษ | ยังไม่เหมาะ | เริ่มจากเก็บข้อมูลให้ต่อเนื่องก่อน แล้วจึงประเมินความพร้อมอีกครั้ง |
| ต้องการให้ระบบสั่งหยุดเครื่องหรือปล่อยงานเอง | ไม่เหมาะ | ระบบแสดงผลและแจ้งเตือน ทีมของคุณเป็นผู้ตัดสินใจ |
| ต้องการตัวเลขความแม่นยำก่อนเริ่มโครงการ | ต้องคุยกันก่อน | ความแม่นยำขึ้นกับข้อมูลของคุณ เราตกลงวิธีวัดผลร่วมกันในขั้นสำรวจ แล้ววัดจากการทดสอบ Back-test และ Real-time |
InCBM
- เฝ้าดูสภาพเครื่องจักรจากเซนเซอร์วัดการสั่นสะเทือนโดยตรง
- สรุปค่าสุขภาพรายเซนเซอร์ ตั้งเกณฑ์ Warning/Critical เอง
- แอป Android ดาวน์โหลดไปลองใช้ได้
Predictive Analytics
- พยากรณ์จากข้อมูลหลายแหล่ง ทั้งเครื่องจักร กระบวนการผลิต และระบบไอที
- ฝึกโมเดลตามข้อมูลและเป้าหมายของแต่ละองค์กร
- ราคาตามขอบเขตข้อมูลและกระบวนการ
สรุป: ใช้ร่วมกันได้ — เลือกตามว่าต้องการเฝ้าดูสภาพเครื่อง หรือพยากรณ์จากข้อมูลหลายแหล่ง
เราเคยทำงานพยากรณ์จากข้อมูลแบบไหน และเรียนรู้อะไร
เราเคยทำงานที่เกี่ยวข้อง 2 แบบ แบบแรกคือระบบ Machine Learning พยากรณ์ความผิดปกติของธุรกรรม ในอุตสาหกรรมการเงินในไทย ปี 2564–2566 แบบที่สองคือระบบนับช็อตแม่พิมพ์ที่เตือนรอบบำรุงรักษาตามเกณฑ์ ในอุตสาหกรรมชิ้นส่วนยานยนต์ในไทยและกัมพูชา ปี 2564–2565 งานแรกใช้โมเดลพยากรณ์ งานที่สองใช้การนับและเกณฑ์ ยังไม่ใช่โมเดลพยากรณ์
พยากรณ์ความผิดปกติของธุรกรรม · อุตสาหกรรมการเงิน · ไทย · ปี 2564–2566
ในปี 2564–2566 เราพัฒนาและติดตั้งระบบ Machine Learning ให้ลูกค้าในอุตสาหกรรมการเงินในไทยที่ดูแลระบบธุรกรรมการชำระเงิน โมเดล LSTM (โครงข่ายประสาทเทียมสำหรับข้อมูลที่เรียงตามเวลา) พยากรณ์ความผิดปกติของเวลาตอบสนองธุรกรรม (Response Time) ล่วงหน้า 5 และ 10 นาที ระบบติดตั้งบนเซิร์ฟเวอร์ใช้งานจริง (Production) และเซิร์ฟเวอร์พัฒนาและทดสอบ (Development) ของลูกค้า แยกจากระบบรับส่งรายการ
ระบบนี้มีระบบฝึกโมเดลใหม่ ระบบสำรองและกู้คืนข้อมูล และกราฟเทียบค่าจริงกับค่าพยากรณ์บน Grafana เราจัดทำเอกสารปิดโครงการในปี 2565 แล้วเข้าสู่ช่วงบำรุงรักษาตามสัญญา ในปี 2566 เราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นอีก 3 แบบ คือ CNN-LSTM, Random Forest และ XGBoost เพื่อเทียบความแม่นยำในแต่ละช่วงเวลาพยากรณ์
นับช็อตแม่พิมพ์และเตือนรอบบำรุงรักษา · ชิ้นส่วนยานยนต์ · ไทยและกัมพูชา · ปี 2564–2565
เราส่งมอบเว็บแอป 5 ส่วนสำหรับนับช็อตแม่พิมพ์ฉีดพลาสติกให้ผู้ผลิตชิ้นส่วนยานยนต์ในไทยในปี 2564 และติดตั้งที่ฐานการผลิตในกัมพูชาในปี 2565 ระบบรวมจำนวนช็อตจากไฟล์ของเครื่องฉีด 2 ยี่ห้อไว้ต่อแม่พิมพ์ แสดงสถานะ OK / Warning / PM และส่งอีเมลเตือนได้สูงสุด 5 เงื่อนไขต่อแม่พิมพ์ งานนี้เป็นการเตือนตามเกณฑ์ ข้อมูลช็อตที่เก็บต่อเนื่องแบบนี้คือจุดเริ่มต้นของการพยากรณ์การบำรุงรักษา
อ่านเคสเต็ม
สิ่งที่เราเรียนรู้
- การรวบรวมและแปลงข้อมูลใช้เวลามากในช่วงแรกของงานพยากรณ์ธุรกรรม สิทธิ์เข้าถึงข้อมูลย้อนหลังจึงต้องพร้อมตั้งแต่ต้นโครงการ
- ความแม่นยำขึ้นกับความครบถ้วนและความต่อเนื่องของข้อมูล วิธีวัดความแม่นยำและช่วงเวลาพยากรณ์ล่วงหน้าต้องตกลงกันก่อน ทั้งแบบย้อนหลังและแบบเวลาจริง
- โมเดลต้องดูแลต่อหลังติดตั้ง หลังปิดโครงการ เราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นเพื่อเทียบความแม่นยำ และแนะนำให้พิจารณาเพิ่มข้อมูลฮาร์ดแวร์ของเซิร์ฟเวอร์เป็นอินพุต
- ข้อมูลที่เครื่องเก็บไว้แล้วใช้ได้ก่อนติดเซนเซอร์เพิ่ม และยอดที่ระบบอ่านได้ต้องตรวจกับไฟล์รายงานของเครื่องก่อนนำไปใช้ ในงานนับช็อต จำนวนช็อตที่ระบบอ่านได้ตรงกับไฟล์รายงานของเครื่องในการทดสอบปิดโครงการ
แปลว่าอะไรสำหรับคุณ
ก่อนเสนอราคา เราขอเป้าหมายการพยากรณ์และตัวอย่างข้อมูลจริงของคุณ เพื่อตรวจความครบถ้วน ความต่อเนื่อง และช่วงเวลาที่เก็บไว้ ถ้าข้อมูลยังไม่พอ คุณเริ่มจากเก็บข้อมูลและเตือนตามเกณฑ์ก่อนได้ งานดูแลหลังติดตั้ง เช่น รอบตรวจผลพยากรณ์และรอบฝึกโมเดลใหม่ ควรกำหนดไว้ในขอบเขตงานตั้งแต่แรก
สเปคทางเทคนิค
| ประเภท | ซอฟต์แวร์วิเคราะห์เชิงพยากรณ์ พัฒนาและปรับโมเดลตามข้อมูลของแต่ละองค์กร |
|---|---|
| งานที่ทำได้ | พยากรณ์การบำรุงรักษา · แนวโน้มคุณภาพ · ตรวจจับความผิดปกติ |
| เทคนิคในผลงานจริง | Machine Learning โมเดล LSTM พยากรณ์อนุกรมเวลา · ทดลองเทียบ CNN-LSTM, Random Forest, XGBoost |
| การทดสอบโมเดล | ข้อมูลย้อนหลัง (Back-test) และข้อมูลเวลาจริง (Real-time) |
| การติดตั้ง | บนเซิร์ฟเวอร์ขององค์กร (On-premise) |
| การแสดงผล | กราฟเทียบค่าจริงกับค่าพยากรณ์ เช่น Grafana Dashboard |
| การแจ้งเตือน | อีเมลหรือช่องทางที่องค์กรใช้อยู่ |
รายละเอียดเทคนิคมาจากผลงานจริงของบริษัท โมเดลและเครื่องมือของแต่ละโครงการเลือกตามข้อมูลจริงในขั้นออกแบบ
สถาปัตยกรรมและการเชื่อมต่อ
ระบบที่เชื่อมต่อได้
- Data Lakehouse ขององค์กร — แหล่งข้อมูลที่จัดโครงสร้างแล้ว
- Grafana Dashboard — กราฟเทียบค่าจริงกับค่าพยากรณ์
- อีเมลหรือช่องทางแจ้งเตือนที่องค์กรใช้อยู่
ความต้องการระบบ
- ข้อมูลย้อนหลังจากเครื่องจักร กระบวนการ หรือระบบที่ต้องการพยากรณ์ — ปริมาณที่ต้องใช้ประเมินจากข้อมูลจริงในขั้นสำรวจ
- เซิร์ฟเวอร์ขององค์กรสำหรับฝึกและรันโมเดล (On-premise) — สเปกกำหนดตามปริมาณข้อมูลในขั้นออกแบบ
- ไม่จำเป็นต้องมี Data Lakehouse ก่อน ถ้าข้อมูลพร้อมใช้อยู่แล้ว
รูปแบบลิขสิทธิ์
ประเมินราคาตามขอบเขตงาน
ราคาขึ้นกับขอบเขตข้อมูลและกระบวนการที่ต้องการพยากรณ์ ติดต่อทีมงานเพื่อขอใบเสนอราคา
- ทีมงานประเมินความพร้อมของข้อมูลในขั้นสำรวจก่อนเสนอขอบเขตงานและราคา
- งานดูแลหลังส่งมอบ เช่น ตรวจข้อมูล ตรวจกราฟพยากรณ์ และฝึกโมเดลใหม่ ตกลงตามขอบเขตงาน
อุตสาหกรรมที่ใช้
- การเงิน — พยากรณ์ความผิดปกติของระบบธุรกรรมการชำระเงิน
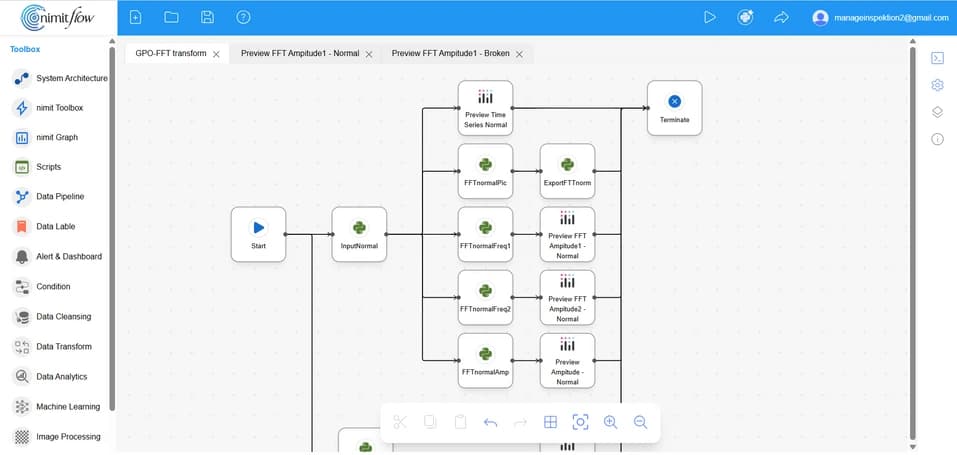
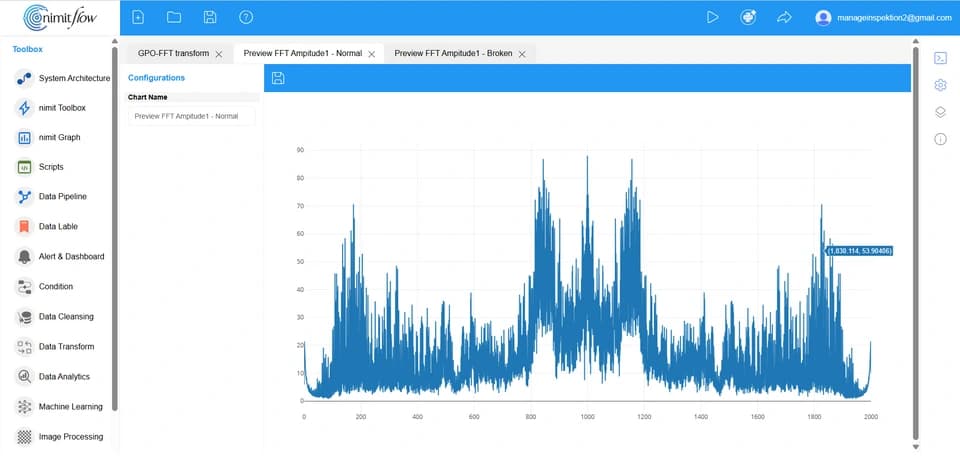
ตัวอย่าง Workflow และหน้าจอจากเอกสาร Nimitflow
เริ่มต้นอย่างไร
ส่งเป้าหมายการพยากรณ์และตัวอย่างข้อมูลให้เรา เราประเมินความพร้อมของข้อมูลในขั้นสำรวจ แล้วเสนอขอบเขตงานและใบเสนอราคา
เตรียมอะไรมาบ้าง
- เป้าหมายการพยากรณ์ — อยากรู้อะไรล่วงหน้า เช่น กำหนดบำรุงรักษา แนวโน้มคุณภาพ หรือความผิดปกติของระบบ
- ตัวอย่างข้อมูลย้อนหลัง และระบบหรือไฟล์ที่เก็บข้อมูลอยู่ตอนนี้
- วิธีวัดผลที่ต้องการ และช่วงเวลาที่อยากรู้ล่วงหน้า
- ผู้รับผิดชอบเมื่อระบบแจ้งเตือน และช่องทางแจ้งเตือนที่องค์กรใช้อยู่
คำถามที่พบบ่อย
ต้องมีข้อมูลย้อนหลังเท่าไรก่อนเริ่มพยากรณ์ได้?
ไม่มีตัวเลขขั้นต่ำที่ใช้ได้กับทุกงาน ปริมาณที่ต้องใช้ขึ้นกับลักษณะข้อมูล กระบวนการ และช่วงเวลาที่ต้องการพยากรณ์ล่วงหน้า เราประเมินความพร้อมของข้อมูลจากตัวอย่างข้อมูลจริงในขั้นสำรวจก่อนเริ่มโครงการ
ต้องมี Data Lakehouse ก่อนไหม?
ไม่จำเป็นเสมอไป ถ้าองค์กรมีข้อมูลที่พร้อมใช้อยู่แล้วเริ่มได้เลย ถ้าข้อมูลกระจายอยู่หลายระบบ เราแนะนำให้วางโครงสร้างข้อมูลด้วย Data Lakehouse ก่อน เพื่อให้โมเดลได้ข้อมูลที่ครบและสม่ำเสมอ
ข้อมูลต้องส่งออกนอกองค์กรไหม?
ไม่ต้อง เพราะ Predictive Analytics ติดตั้งบนเซิร์ฟเวอร์ขององค์กรได้ ในงานพยากรณ์ธุรกรรมให้ลูกค้าในอุตสาหกรรมการเงินในไทย ระบบติดตั้งบนเซิร์ฟเวอร์ใช้งานจริง (Production) และเซิร์ฟเวอร์พัฒนาและทดสอบ (Development) ของลูกค้าเอง แยกจากระบบรับส่งรายการ พร้อมระบบสำรองและกู้คืนข้อมูล รูปแบบการติดตั้งของแต่ละโครงการกำหนดในขั้นออกแบบ
เมื่อข้อมูลเปลี่ยน โมเดลยังแม่นอยู่ไหม?
ไม่เสมอไป เมื่อข้อมูลหรือพฤติกรรมของระบบเปลี่ยน โมเดลต้องฝึกใหม่ (Retrain) เพราะความแม่นยำขึ้นกับความครบถ้วนของข้อมูล ในงานพยากรณ์ธุรกรรม ระบบมีส่วนฝึกโมเดลใหม่ และหลังปิดโครงการเราทดลองฝึกโมเดลใหม่ด้วยอัลกอริทึมอื่นเพื่อเทียบความแม่นยำ เราจึงแนะนำให้ฝึกโมเดลต่อเนื่อง และพิจารณาเพิ่มข้อมูลที่เกี่ยวข้องเป็นอินพุต
Predictive Analytics ต่างจาก InCBM อย่างไร?
InCBM เฝ้าดูสภาพเครื่องจักรจากข้อมูลเซนเซอร์วัดการสั่นสะเทือนโดยตรง (Condition-Based Monitoring) และเตือนตามเกณฑ์ที่ตั้งเอง ส่วน Predictive Analytics พยากรณ์จากข้อมูลหลายแหล่ง ครอบคลุมทั้งคุณภาพและการบำรุงรักษา โดยฝึกโมเดลตามข้อมูลของแต่ละองค์กร ทั้งสองระบบใช้ร่วมกันได้
Predictive Analytics ราคาเท่าไร?
ราคาขึ้นกับขอบเขตข้อมูลและกระบวนการที่ต้องการพยากรณ์ เราประเมินความพร้อมของข้อมูลในขั้นสำรวจก่อน แล้วจึงเสนอขอบเขตงานและใบเสนอราคา งานดูแลหลังติดตั้งตกลงตามขอบเขตงาน