企業向けサーバー
企業の業務システムとデータベース
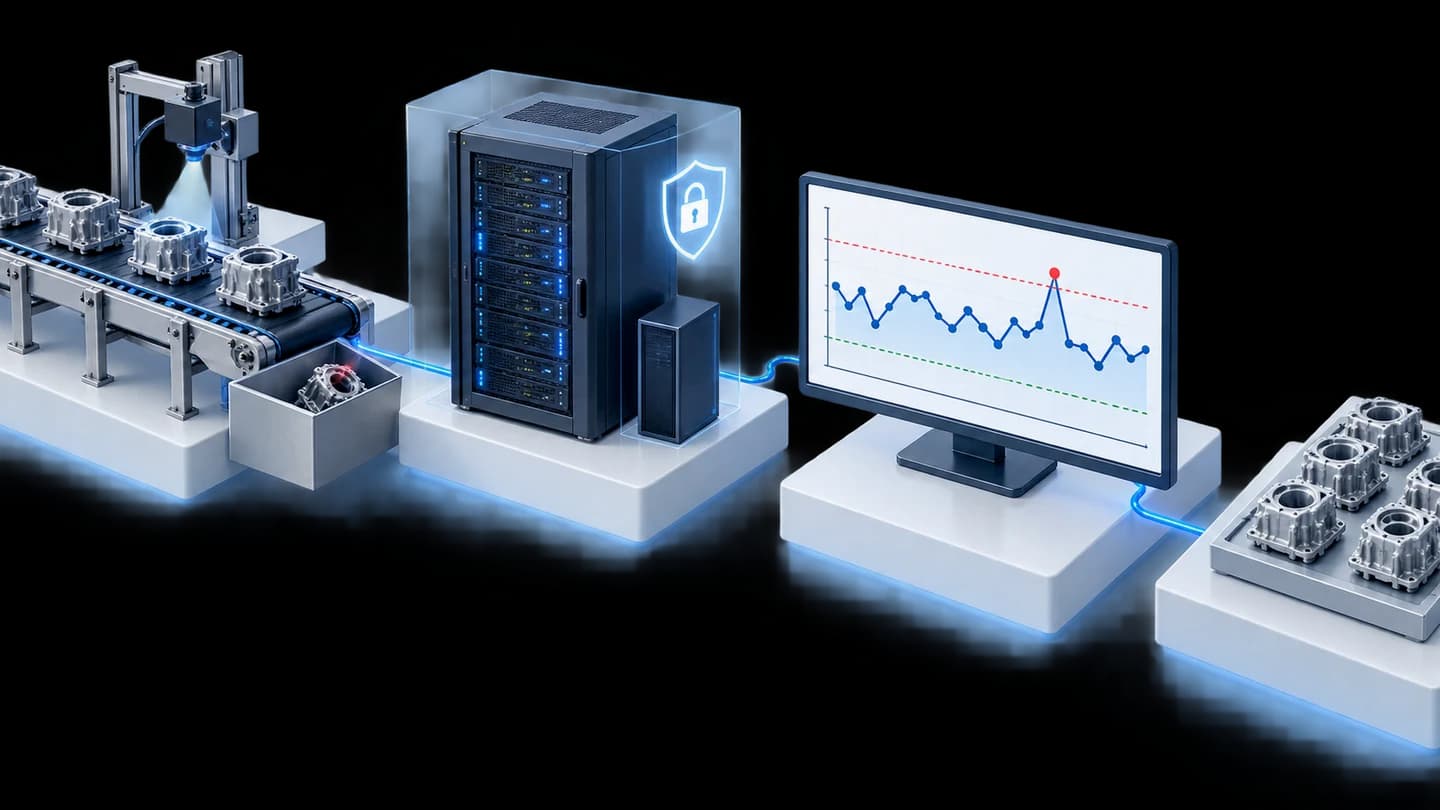
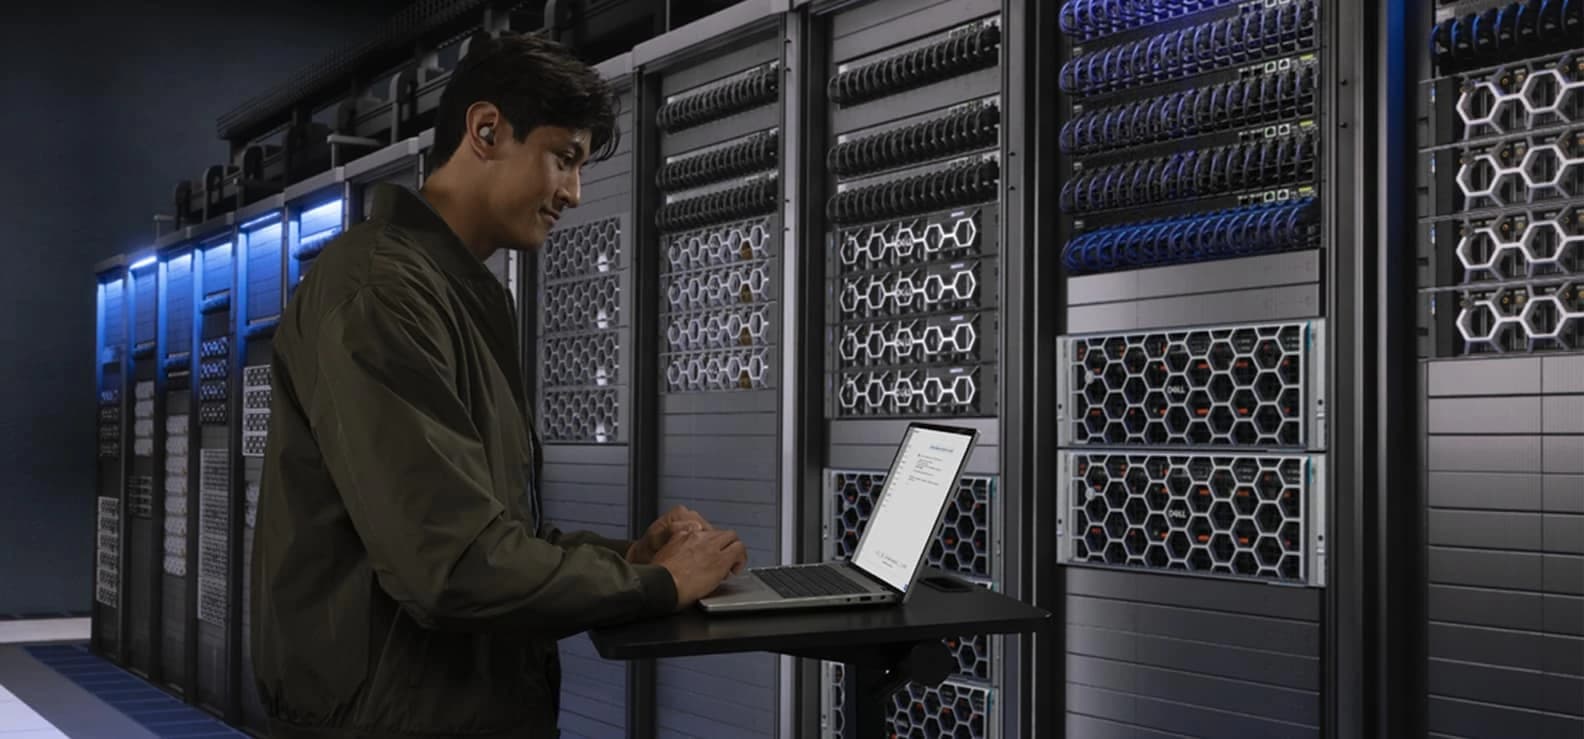
アプリケーション、データベース、仮想化向けのサーバーを調達・構築します。CPU、RAM、ストレージ、既存システムとの接続を評価します。
MODERN DATA · 組織のデータとAI
複数のシステムに分散したデータをつなぎ、品質とアクセス権を整えたうえで、組織の課題に応じたレポート作成、ナレッジ検索、AI活用につなげます。
01 / データの流れ
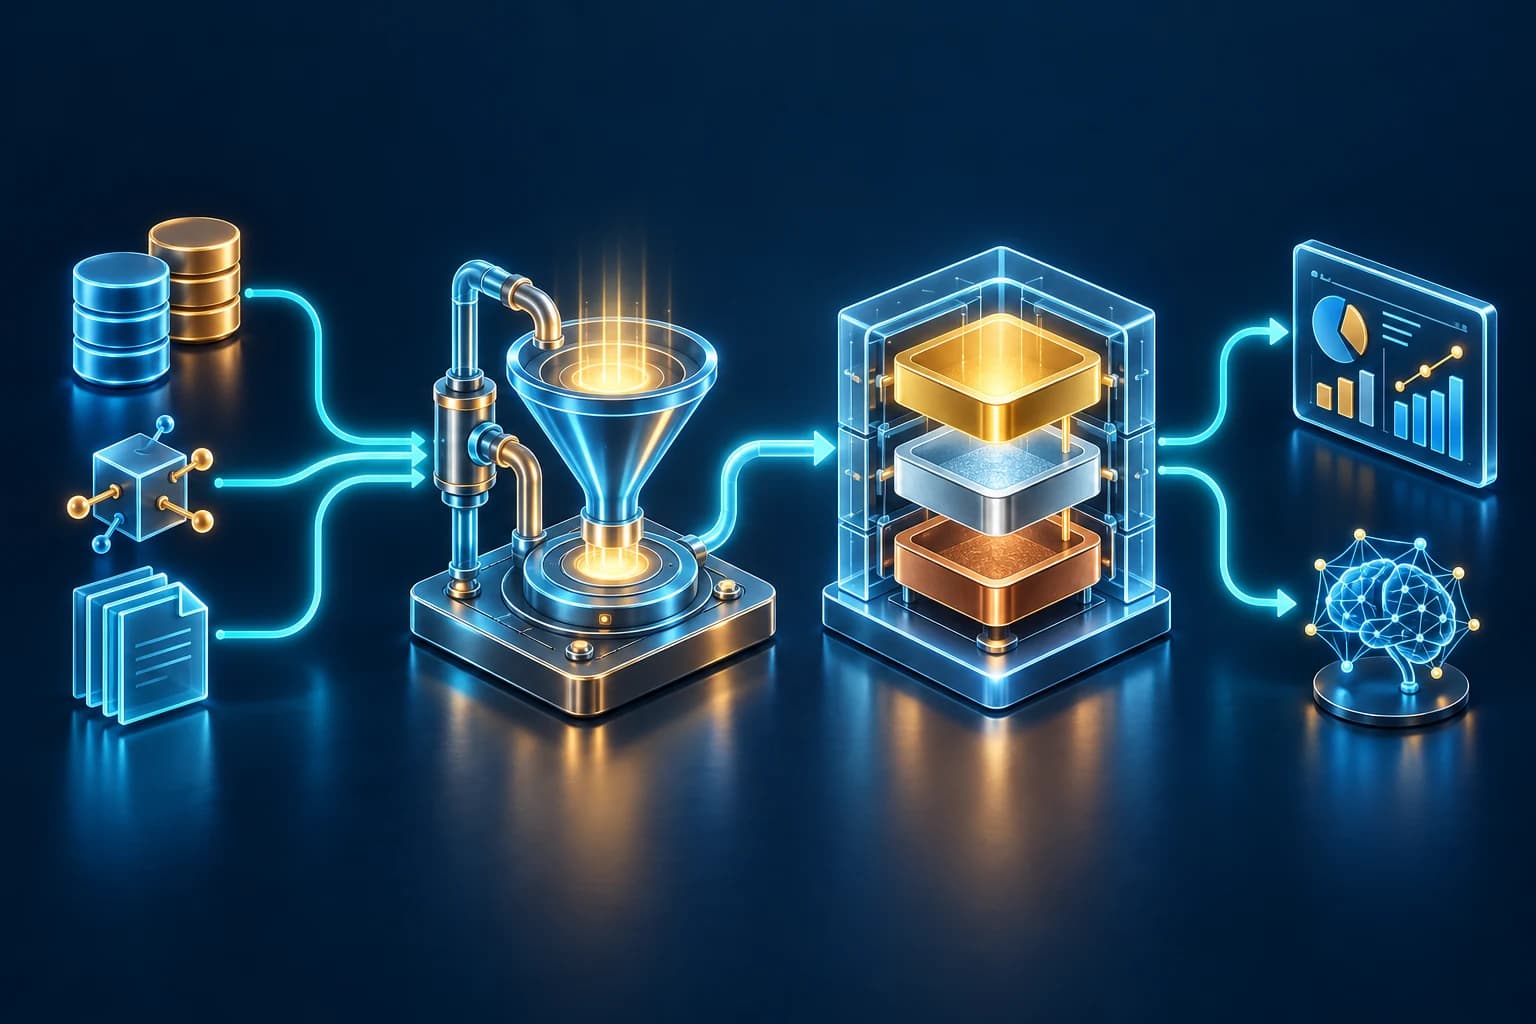
システムを役割の明確な4つのステップで捉えます。既存のデータから始め、業務の目的に必要な部分を選んで連携します。
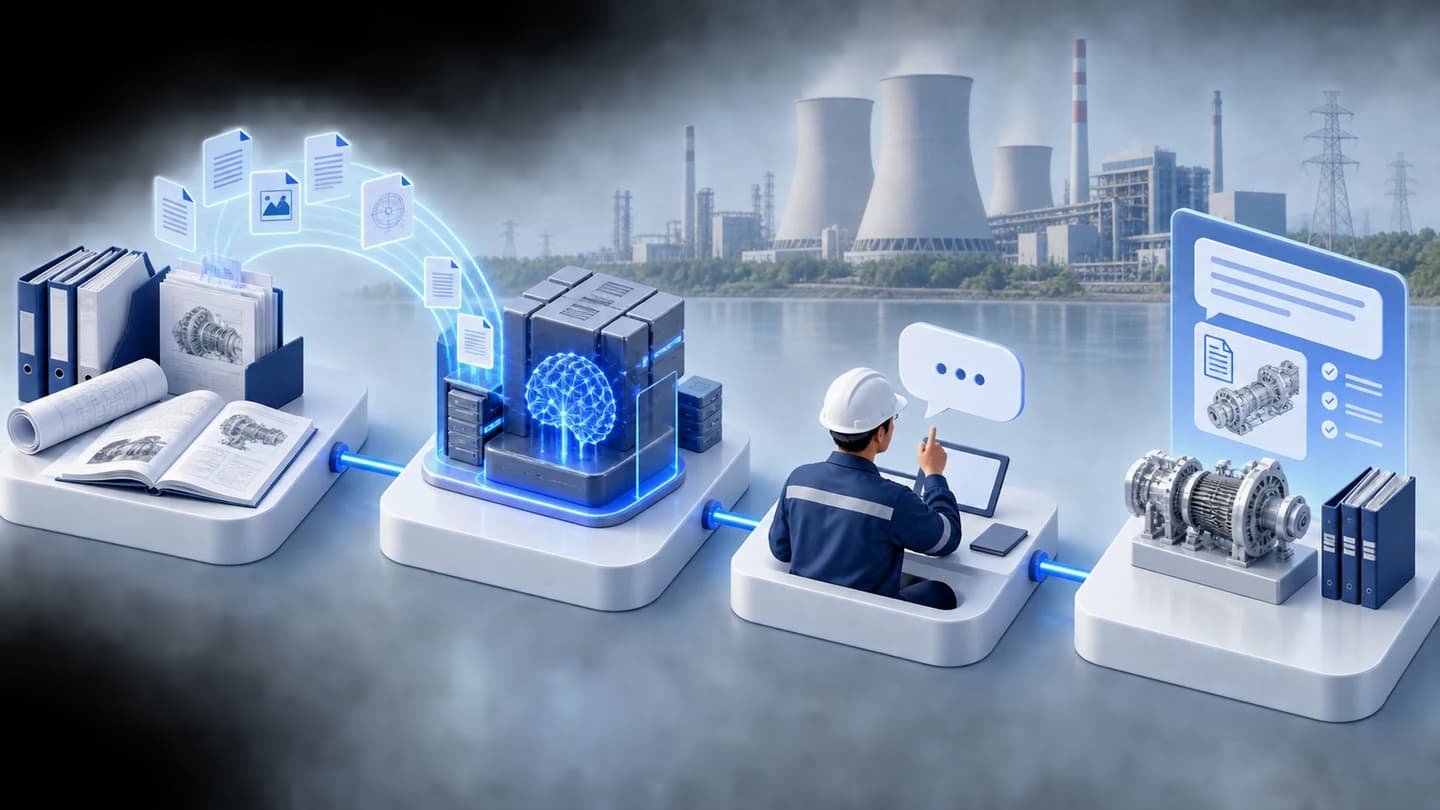
既存システムのデータベース、文書、CSV、API
組織が持つデータから始めるnimitFlowでデータを連携し、設計した流れに沿ってデータの受け渡しを整えます。
データの出所を把握する生データ、確認済みデータ、活用可能なデータをData Lakehouse内で整理します。
各層の役割を分ける準備したデータをダッシュボード、ナレッジ検索、追加の分析に活用します。
ビジネスの問いに答える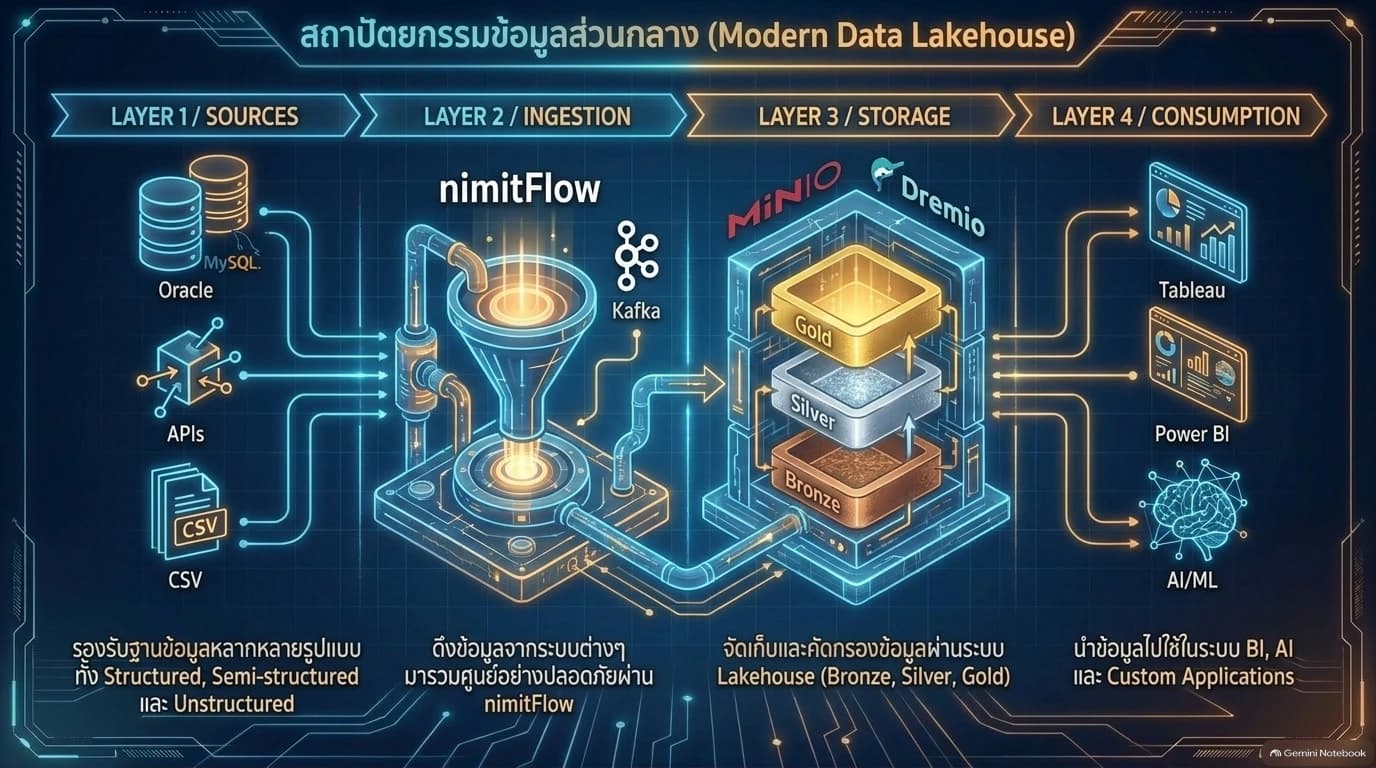
取り込んだデータを保存し、出所と照合できるようにします。
形式を整え、品質を確認してから、共同で利用できるようにします。
レポート、指標、分析の目的に合わせてデータを整えます。
サーバー · データレイク · AIワークステーション
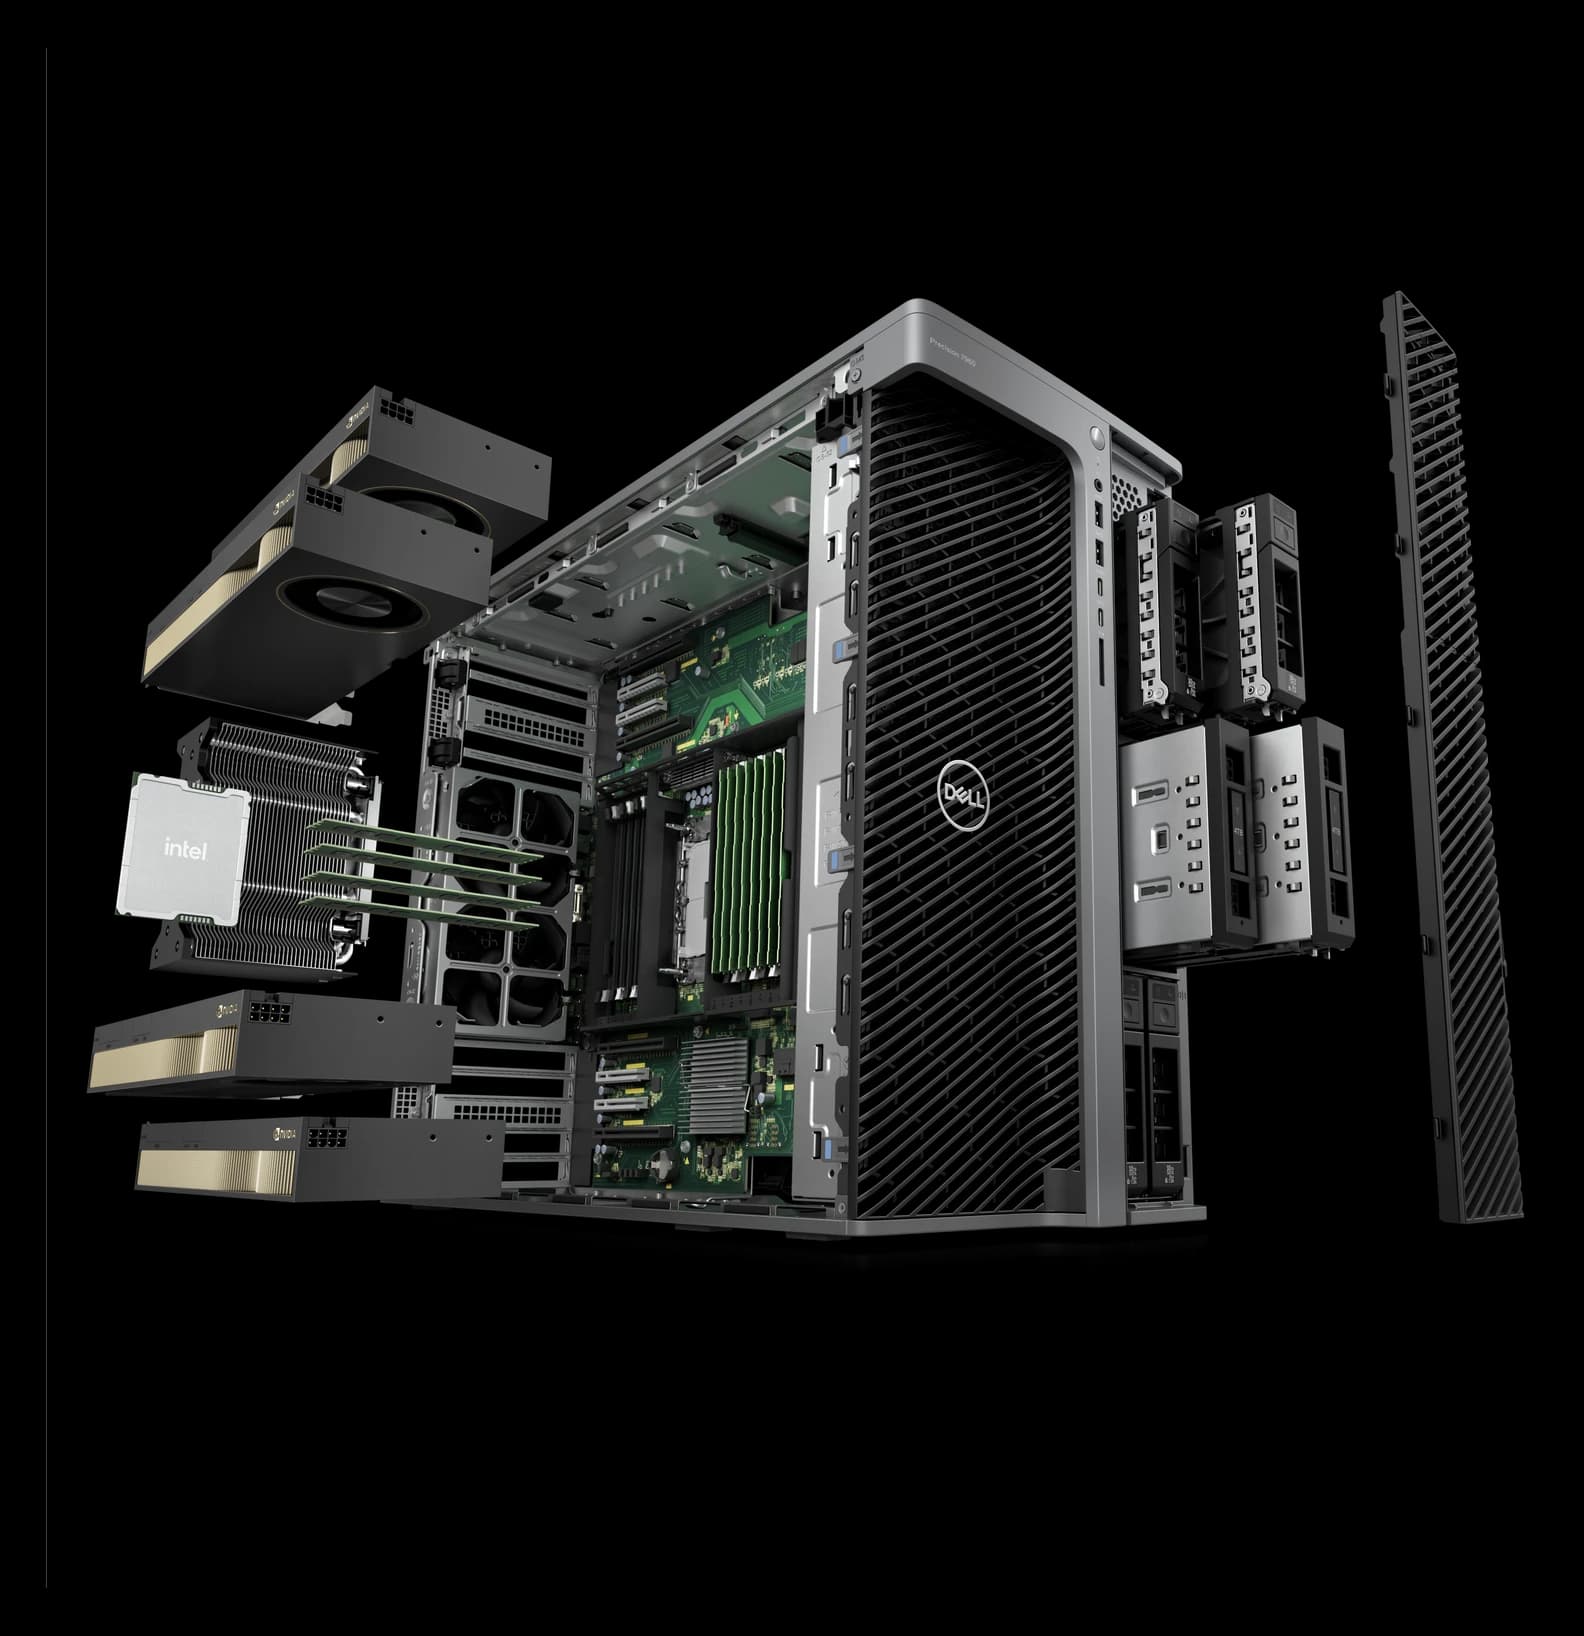
用途に合う機器を選び、ストレージ、ネットワーク、ソフトウェアも設計します。企業向けサーバーやData Lakeから、開発チーム向けのAIサーバー、ワークステーションまで対応します。
企業の業務システムとデータベース
アプリケーション、データベース、仮想化向けのサーバーを調達・構築します。CPU、RAM、ストレージ、既存システムとの接続を評価します。
複数のソースからデータを集約・準備
保存領域、データ転送、処理を設計し、バックアップと拡張の方針を検討します。業務範囲に応じてnimitFlowやデータツールと連携します。
利用者や複数システムにモデルを提供
モデル、同時利用者数、推論や学習の処理内容に応じてGPUとVRAMを評価し、電源、ネットワーク、冷却も検討します。
開発者・エンジニア向けの作業用マシン
データ準備、モデルの試行、ローカル環境でのAI開発に適したワークステーションを選定します。GPU、RAM、ストレージ、実際に使うソフトウェアを考慮します。
価格、調達可能な機種、ソフトウェアライセンス、保証、引き渡し後のサービス範囲は、プロジェクトごとの見積書に個別に記載します。
02 / データガバナンス
システムとともに、人、ルール、データのライフサイクルを整えます。チームがデータを見つけ、共通の理解を持ち、責任者を把握できるようにします。
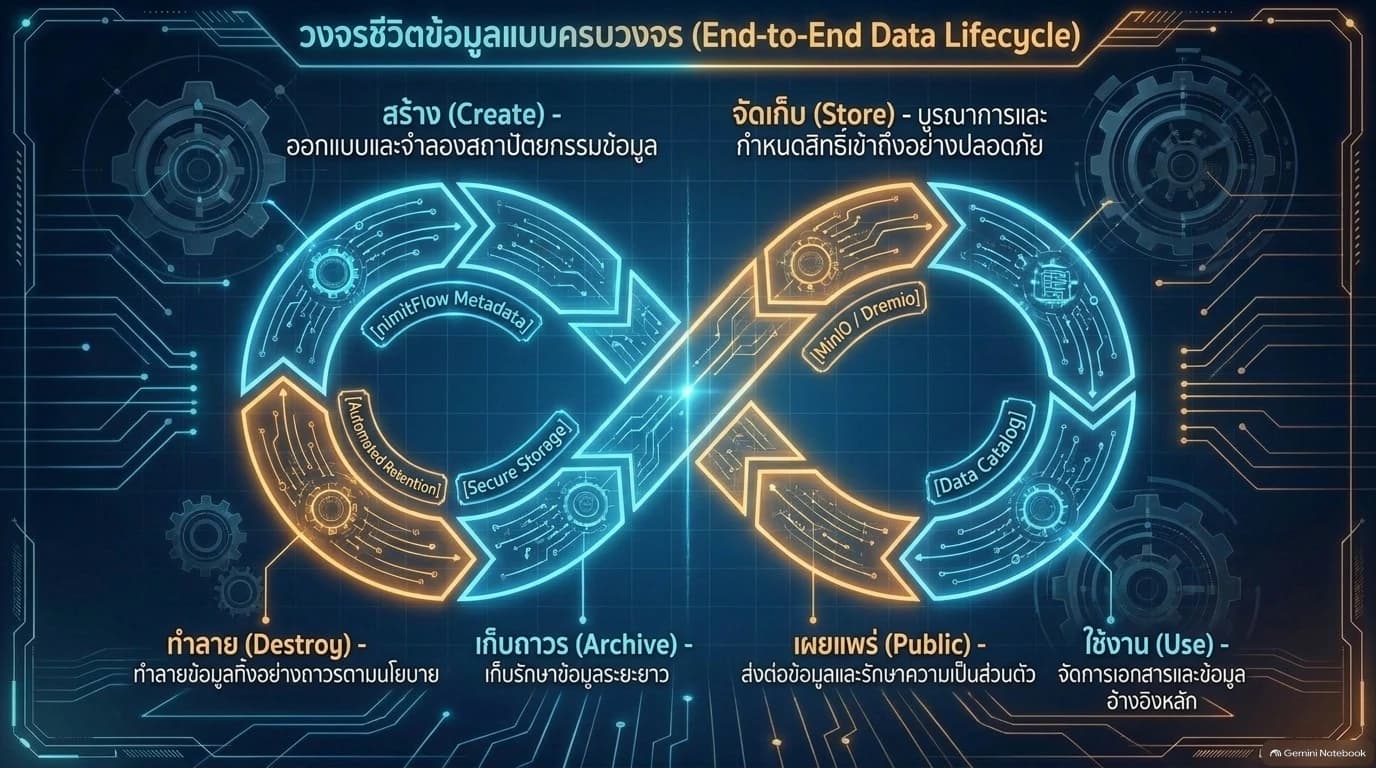
各データセットの所有者と管理担当者を定め、意思決定や問題解決での役割も明確にします。
定義、形式、品質確認の方法を定め、各チームが同じ意味でデータを利用できるようにします。
組織の方針や要件に沿って、データの種類と利用権限を検討します。
手順を共有し、知識を引き継ぐことで、利用者が継続してデータを管理できるようにします。
各データセットの所在、意味、管理者、元のシステムを記録します。チームが利用前にデータを検索し、適切かどうかを判断するために役立ちます。
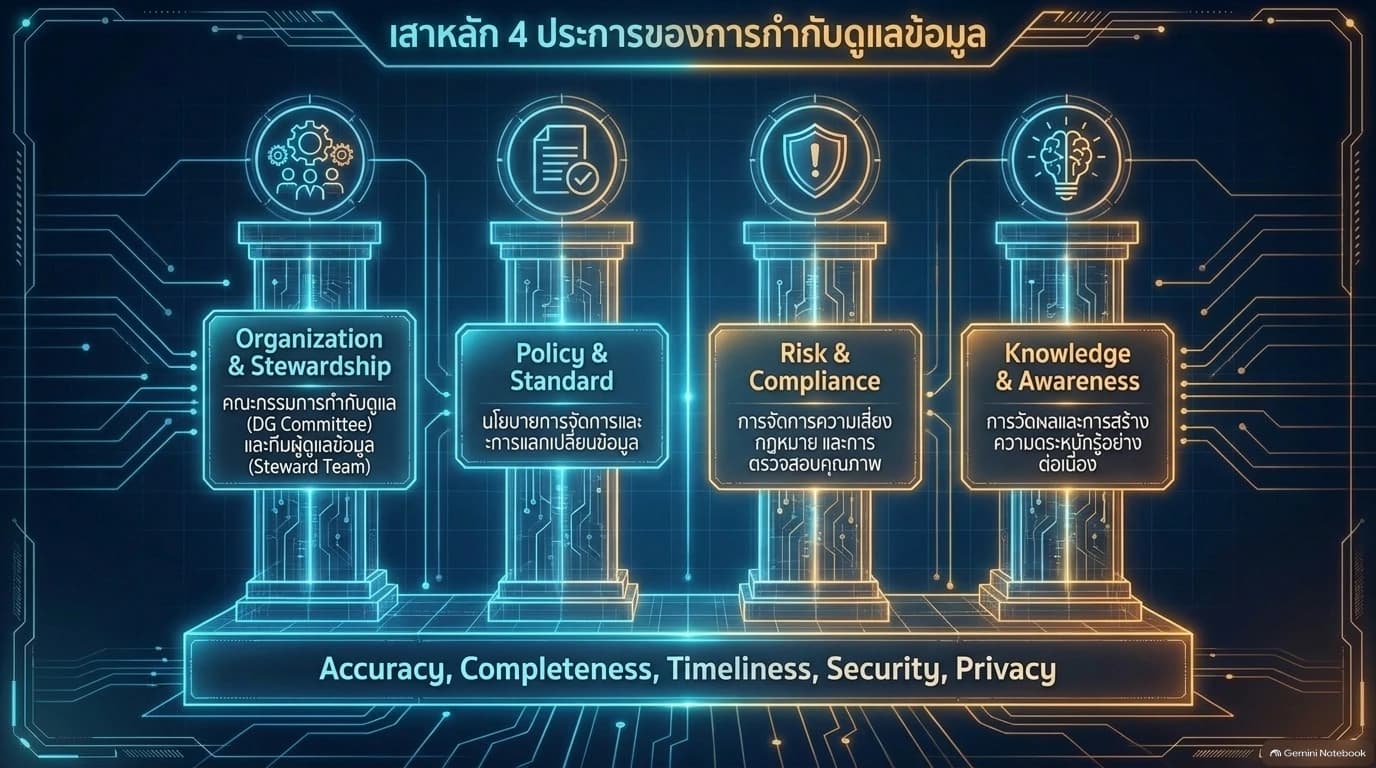
方針に基づき、データの作成、保存、公開、利用、保管、廃棄の方法を定めます。システムへの取り込みだけで終わらせません。
03 / アクセスとセキュリティ
役割とデータの機密性に応じてアクセスを設計し、後から確認すべき事項を定めます。
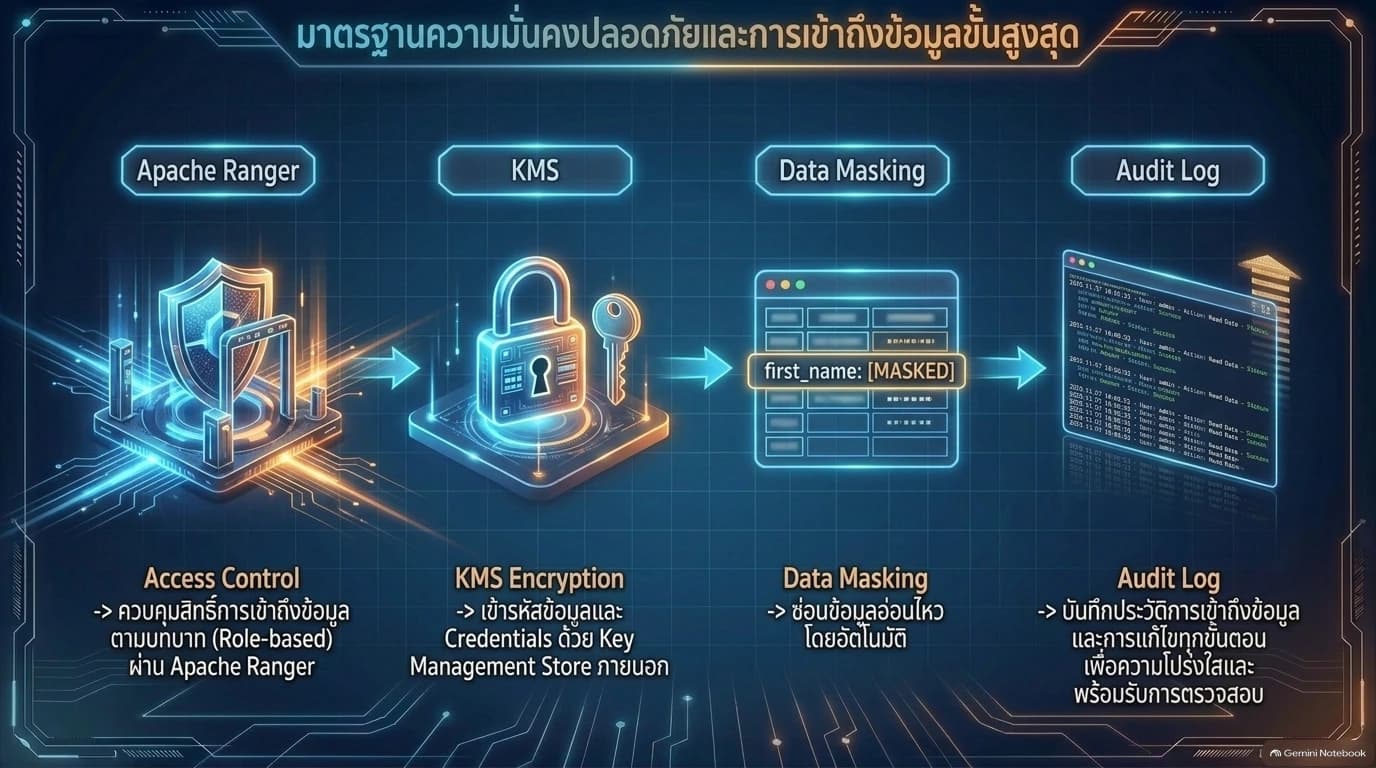
どのデータを誰が閲覧・編集・管理できるかを定めます。
システムに適した暗号化と鍵管理の方法を選びます。
権限に応じて、非表示にするデータや一部だけ表示するデータを定めます。
後から確認するために必要な操作を記録します。
04 / データの活用
準備したデータはさまざまな用途に活用できます。データが揃っており、結果の確認・受け入れ方法を定められる業務を最初に選びます。
複数システムのデータをまとめ、全体像を把握し、チームに必要な指標を追跡します。
nimitFlowプラットフォームを見る利用が許可された文書を質問応答システムに取り込み、回答を元の資料と照合します。
Enterprise KM Chatbotを見るデータの品質と量を評価してからモデルを開発し、業務の目的に照らして結果を検証します。
Predictive Analyticsを見るAIの出力を意思決定に使う前に、担当者による確認が必要です。適切に利用できるかどうかは、データと業務範囲に左右されます。
05 / プロジェクトの進め方
現状を確認し、範囲と責任分担を定めてから、開発、テスト、引き渡しを計画します。
既存システム、データソース、解決したい課題を確認します。
最初に取り組む業務と成果物を決めます。
データとシステムの管理者、および検収担当者を合意します。
合意した計画に沿って設計、接続、開発を進めます。
テストと課題の追跡を行い、合意した範囲に基づいて検収します。
使い方を説明し、担当チームをトレーニングします。
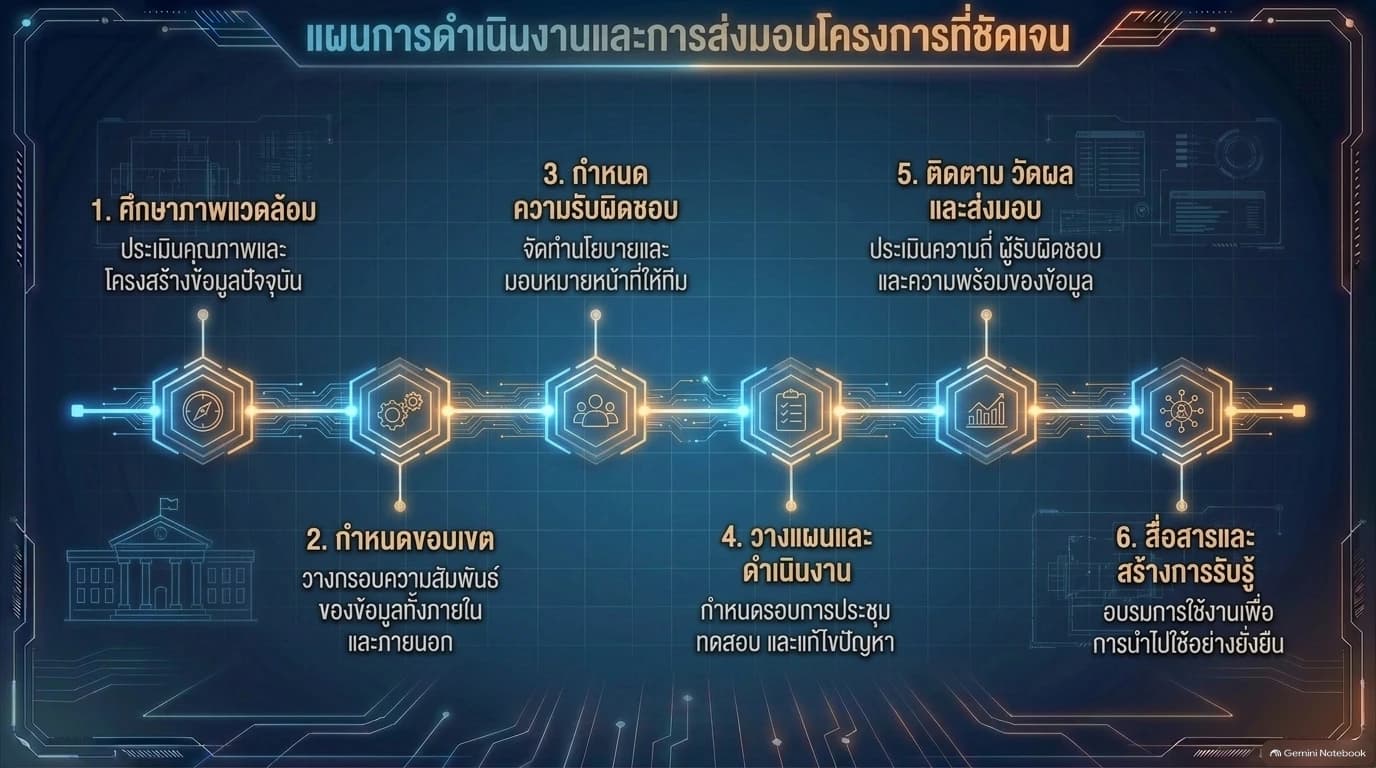
目的に応じて構成要素を選びます。すべてのシステムを同時に始める必要はありません。
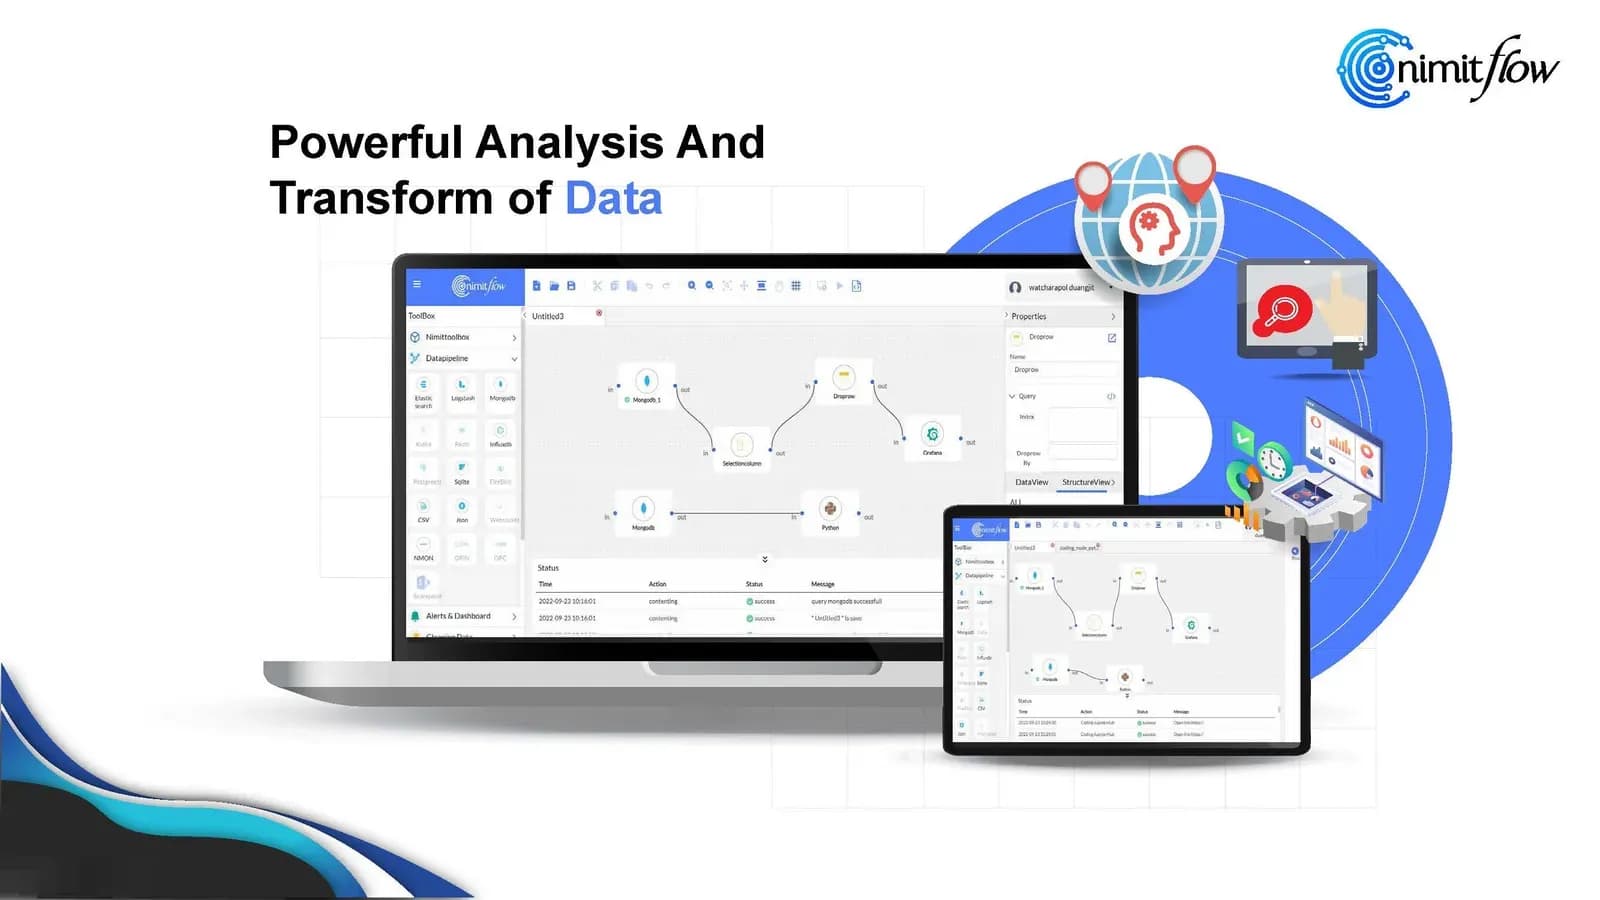
ドラッグ&ドロップで自動処理(Workflow)とData Pipelineを構築するLow-Codeプラットフォーム。月額THB 8,000から
工場データレイク(一元化されたデータリポジトリ)として使用され、データレイクハウスと予測分析にデータを送信し、さらなる分析を行います
対象: 複数のシステムのデータを連携し、業務に応じてPythonコードを追加したいITチームやエンジニア
詳細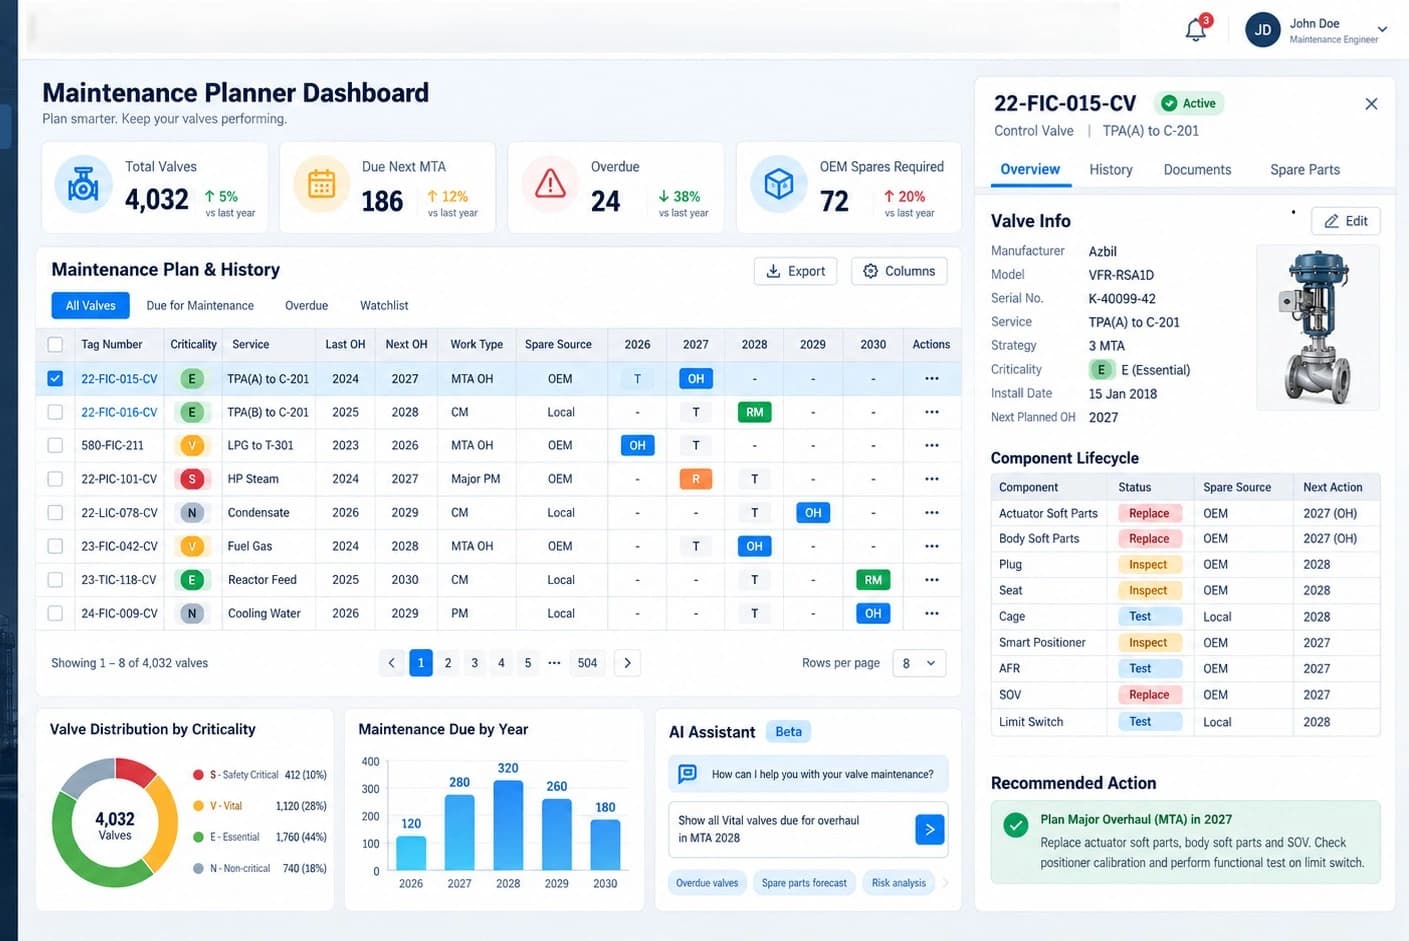
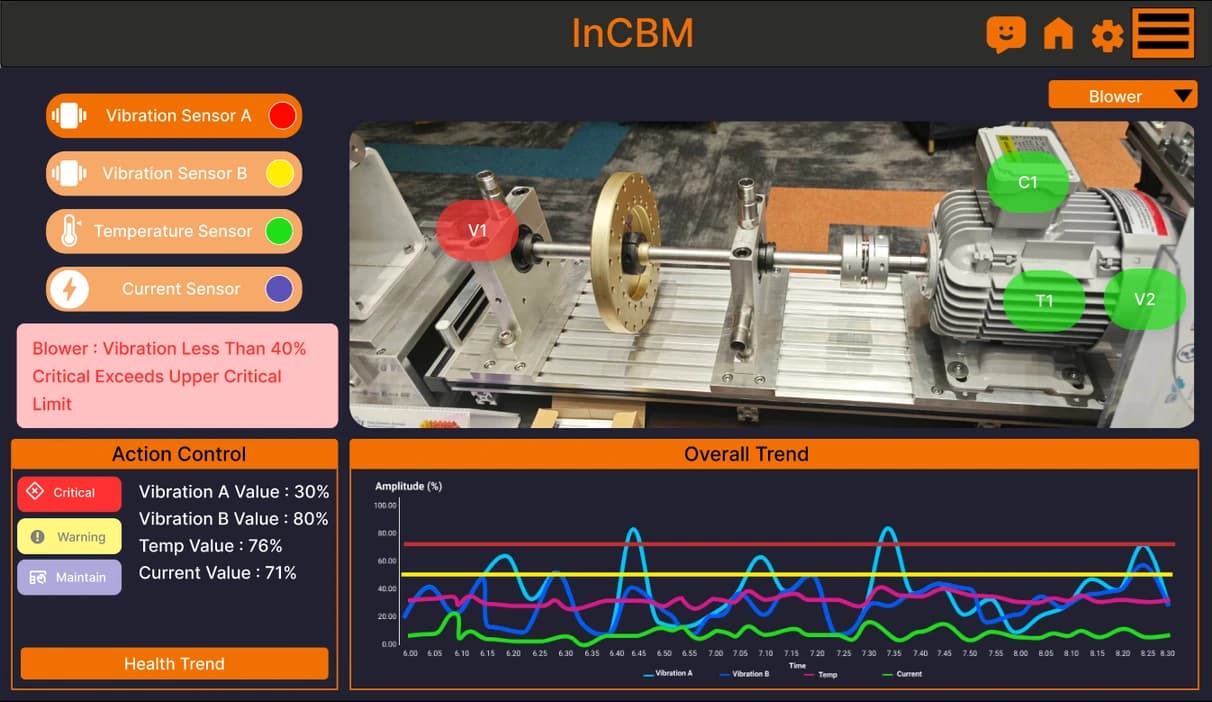
Maintenance Planner スクリーンの例:AI アシスタント付き
組織内の文書から回答するAIチャットボット、タイ語で回答、文書の出典を指定し、オンプレミス(On-Premise)での展開が可能です
対象: 多くの組織マニュアルや文書から答えを見つける知識労働者やエンジニアのチーム
詳細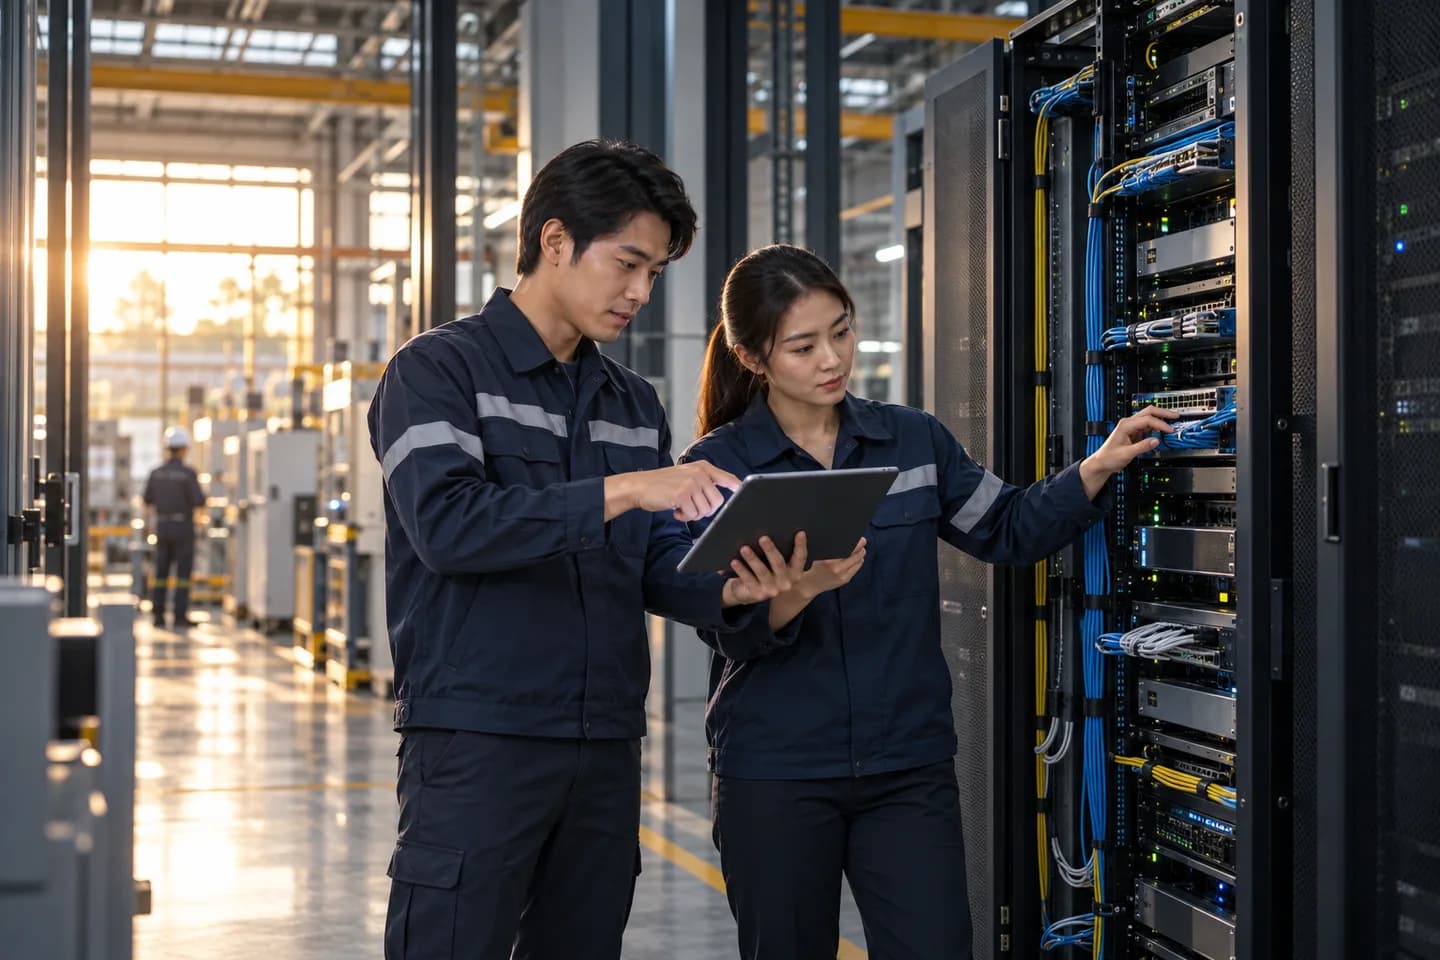
AI から作成されたイラストレーション概念 – 実際の製品やプロジェクトの画像ではありません
プラットフォームは、ビジネスシステムとIoTデバイスからのデータを中央データウェアハウスに統合し、レポートを作成し、AIを進化させます。
対象: 複数のシステムからデータを統合する必要があるITチームやデータチーム
詳細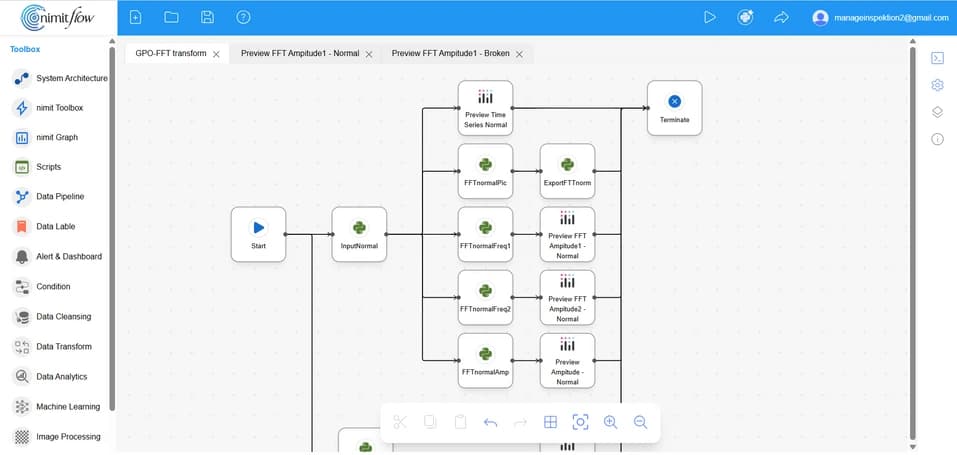
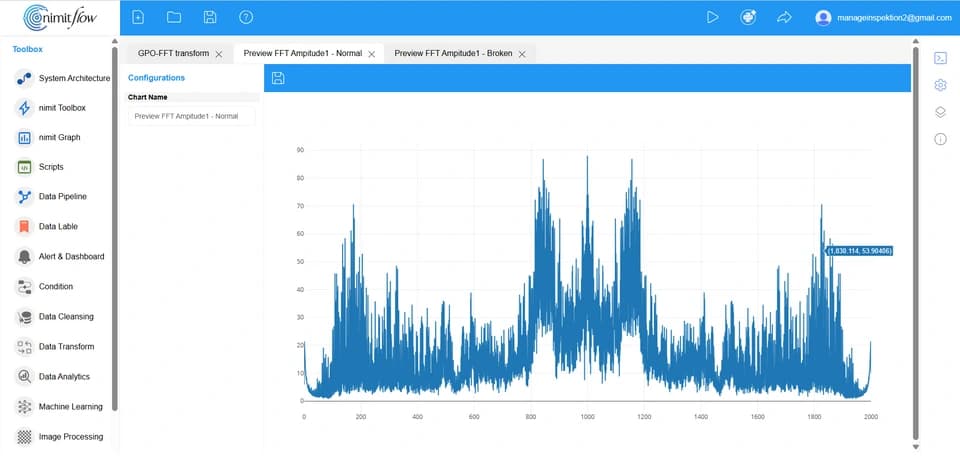
Nimitflow ドキュメントからのデータ接続と分析の例
センサーデータをNimitflowを通じて接続し、FFTで信号を分析し、ダッシュボード上のトレンドを追跡し、アラートを発生させるためのマシン学習モデルを開発します。
対象: 歴史的なデータとトレンド予測のニーズを持つデータ分析チーム、生産部門、メンテナンスチーム
詳細Modern DataはIT、データ、AIに関する取り組み全体を指します。nimitFlowは、適した業務でデータの連携や処理フローの整理に使うプラットフォームです。プロジェクトの範囲に応じて他のツールも組み合わせます。
まず既存システムと、データベース、API、ファイルなどの連携方法を調査します。そのうえで、どのデータを共通利用できるかを評価します。すべてのシステムがすぐに接続できるとは限りません。
データに関する方針、インフラ、業務範囲に応じて、On-PremiseまたはCloudでの導入を検討できます。組織内でLLMを運用するために必要なリソースも評価します。
解決したい問いや課題、システムとデータソースの一覧、担当者、機密情報を除いたサンプルデータをご用意ください。最初の業務と結果の検収方法を定めるために役立ちます。
お客様の課題から始める
業務の課題、既存システムの一覧、機密情報を除いたサンプルデータを基に、適切な範囲をチームと相談できます。
Modern Dataについて相談する