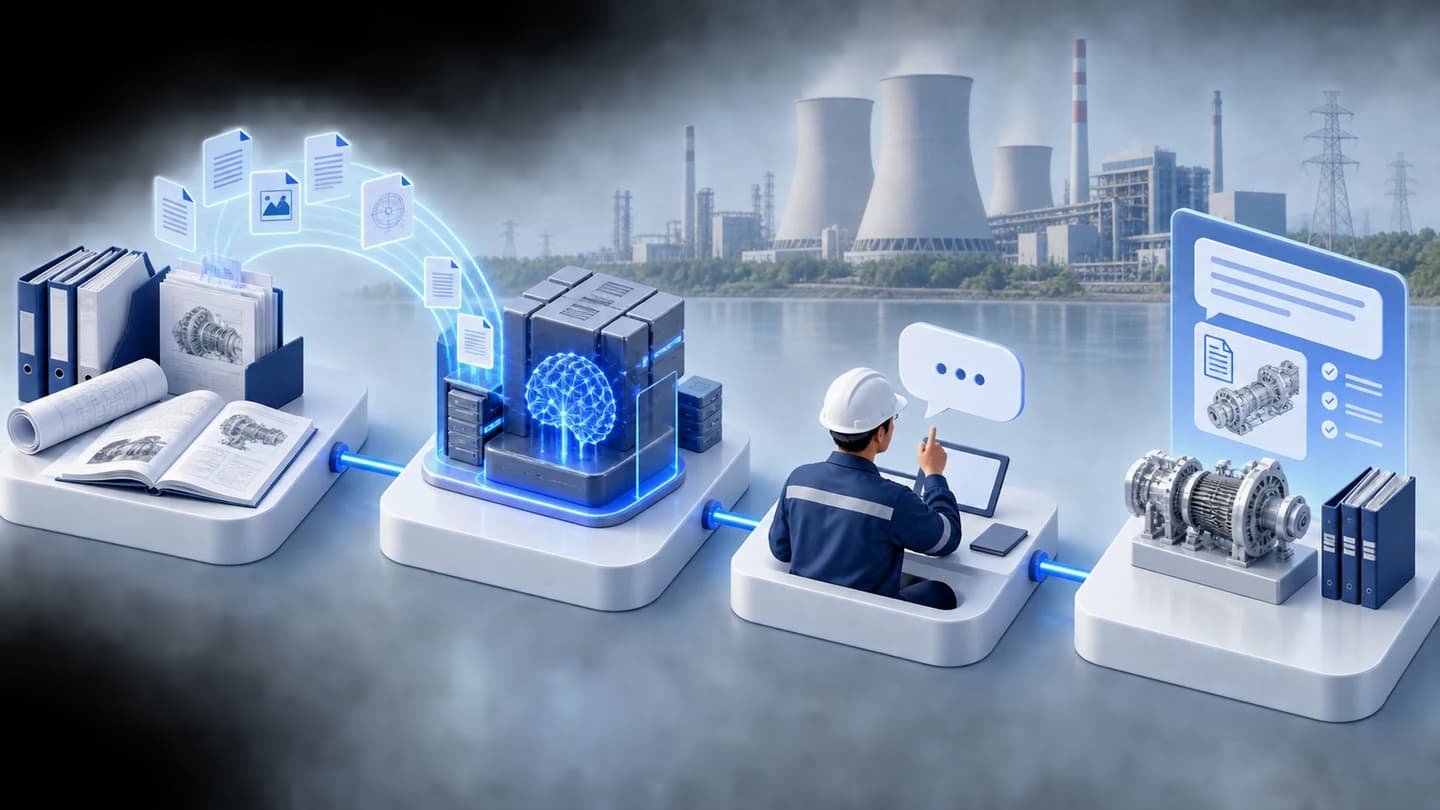
ENTERPRISE DATA / INDUSTRIAL AI
nimitFlowデータ、機械を接続する
とAIを一つのシステムで
nimitFlowは、データを接続し自動化されたワークフローを作成するためのLow-Codeプラットフォームです。組織内の特定のタスクから始まり、中央データレイク、データガバナンス、スマートファクトリーアイオーティとAIマシンラーニングシステムに拡張します。
月額THB 8,000からクラウド価格はここから · エンタープライズプロジェクトと追加統合システムは個々のプロジェクトごとに評価されます
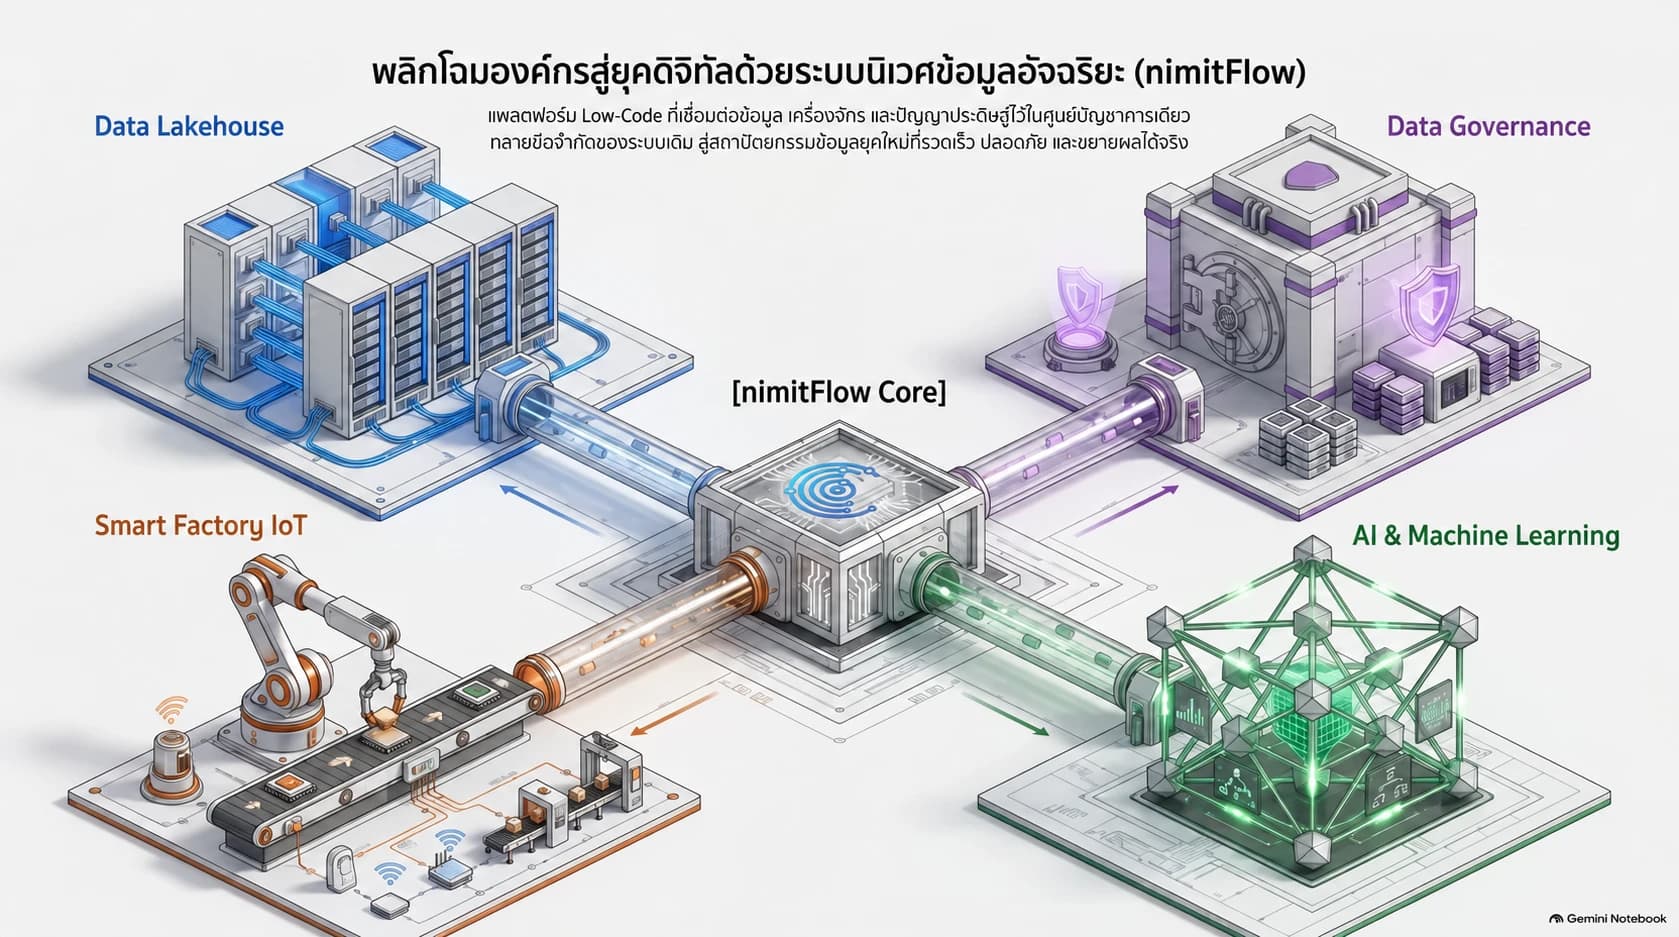
接続したいタスクから始め、その後統一されたシステムに拡張します
nimitFlowを使用してデータの受信と処理を行うコアとして使用します。タスクに合わせたデータレイク、ガバナンスタool、AIモデルを選択します
01 / DATA FOUNDATION
直ちに利用できるようにデータを統一する
既存のシステム、データベース、API、ウェブページからデータを受け取り、トレース可能なデータパスに組み込む
02 / データガバナンス
起源とデータ管理者を知る
データ所有者、説明、品質、権利、およびライフサイクルを接続システムと共に定義する
03 / INDUSTRIAL IoT
工場からのデータを接続する
生産総額、品質測定値、機械状態、作業場所のカメラからの検査結果を集約する
04 / AI & ANALYTICS
さらなる分析のためにデータを送信する
モデル用にデータを準備し、トレンドを分析し、レポートまたはワークフロー手順に結果を送信する
あなたの仕事に適していますか?
誰に適していますか?
複数のシステムのデータを連携し、業務に応じてPythonコードを追加したいITチームやエンジニア
話し合う前に情報を準備する
データソースまたは既存のシステム、サンプルデータ、自動化するタスク。
要約
- nimitFlowはInspektionによって開発されたLow-Codeプラットフォームで、データパイプライン(データの取り込み、処理、転送)を作成し、ノードをキャンバス(フローレイアウトエリア)にドラッグしてワークフローを自動化します
- nimitFlowはDocker Compose(コンテナインストールスイート)を使用して組織のサーバーにインストールでき、AIノードと組織内で実行されているLLMをOllamaを通じて接続し、データをネットワーク内に保つことができます
- nimitFlowでは一般的なタスクはコードを書かずにフォームで設定され、複雑なタスクはリソース使用を制限するサンドボックス環境で動作するPythonノードを使用します
- エンタープライズ拡張はプロジェクトの範囲内でデータレイクハウス、データカタログ、データガバナンス、AI分析をサポートし、接続ツールと個別のインストールシステムを評価します
- nimitFlowのCloud Subscriptionは月額8,000 THBからです。組織内への導入は、ユーザー数と連携範囲に応じてお見積もりします
nimitFlowはデータチームと工場チームをどのように結びつけるのでしょうか?
データが異なるファイル、データベース、アプリケーションにある場合、レポート作成には再収集と再確認が必要です。nimitFlowはフローを使用して中間パスウェイとして機能し、データの受信、変換、処理、および転送を行い、チームがステップを見ることができるようにし、仕事上の協力を可能にします
| チームの課題 | 初期アプローチ |
|---|---|
| ITおよびデータチーム | APIデータベースとファイルを接続し、データパイプラインを作成し、使用前に品質検査を行います |
| データマネージャー | Data Catalogおよびデータガバナンスシステムと連携して、データの意味、データセットの所有者、権限、検証ルールを定義 |
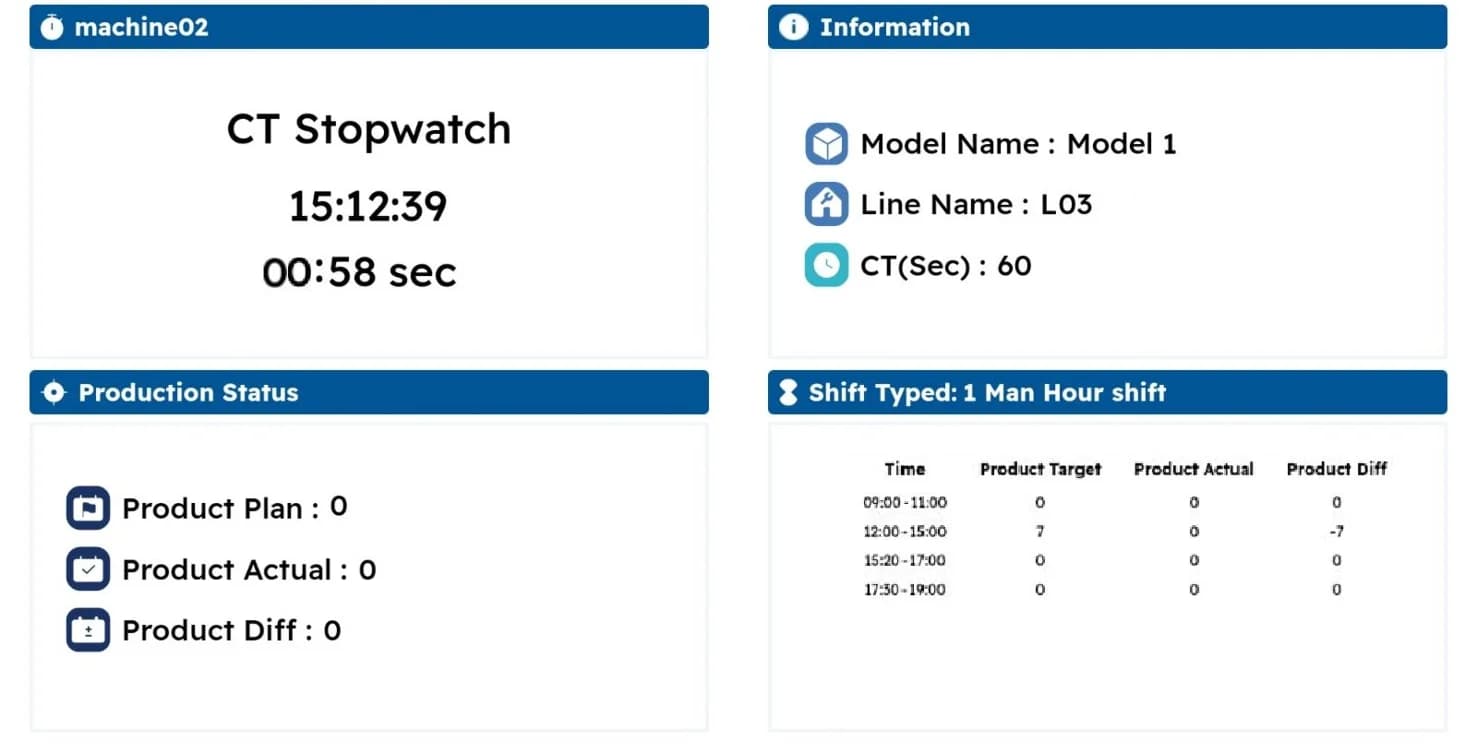
| チームリーダーとメンテナンステーム | 設備またはフロントエンドアプリから生産量、測定値、機械状態を受け取り、その後一緒にレポートを生成します |
| 分析チームと管理 | 準備されたデータを使用してトレンドを表示し、レポートを作成するか、または与えられた問題に応じてAIモデルを接続します |
一つのジョブを開始し、徐々に拡大する
繰り返しの仕事と利用可能なデータを選択し、例えば日次生産総数や異常値アラートなど、実際のデータでフローをテストした後、複数のシステムに展開します
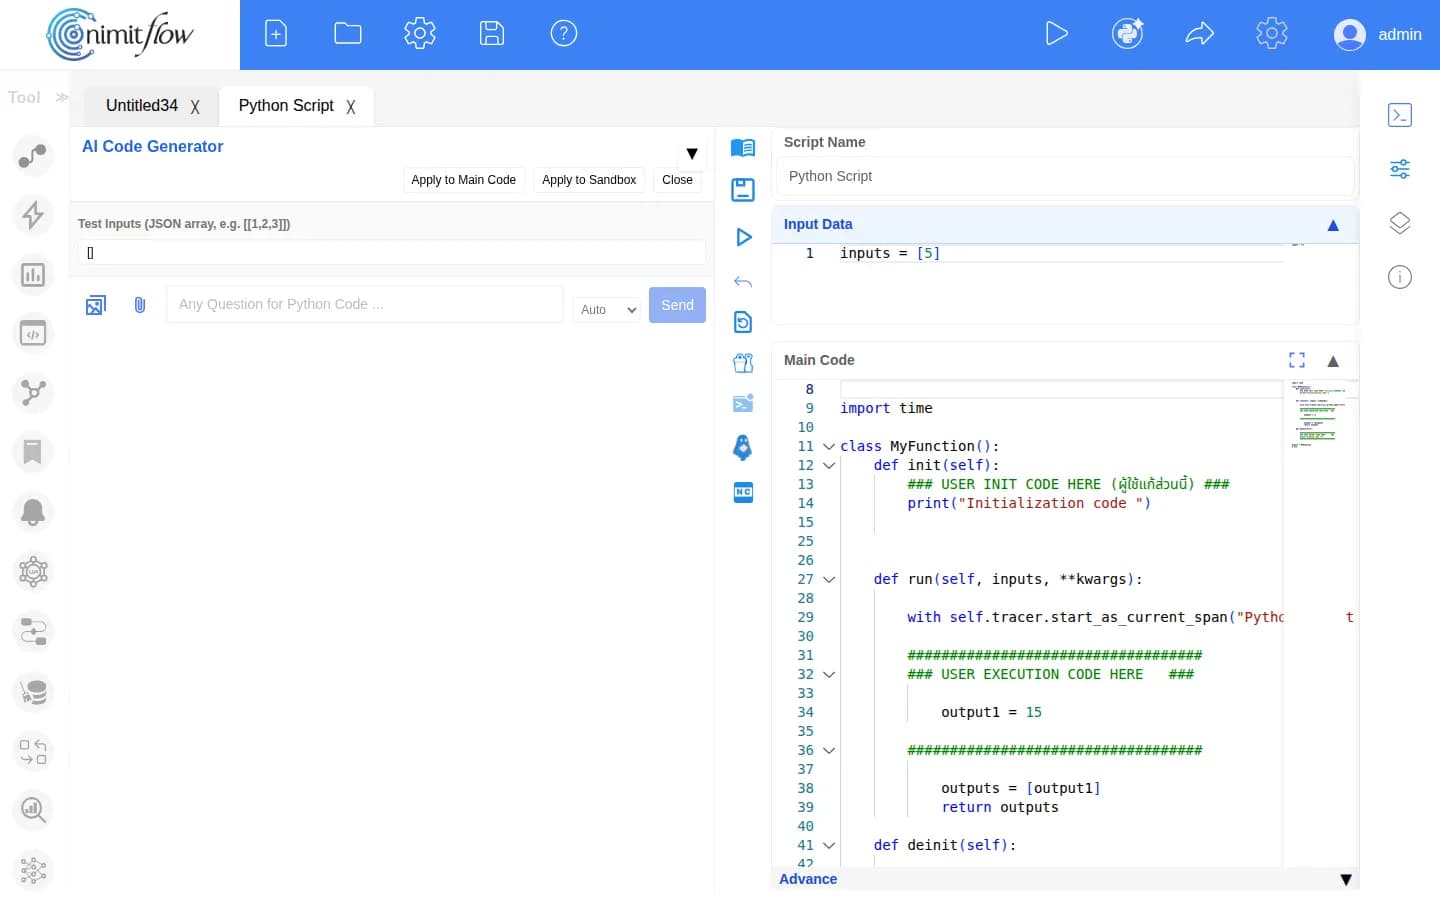
Low-CodeとPythonを使って自動化された仕事を作成する
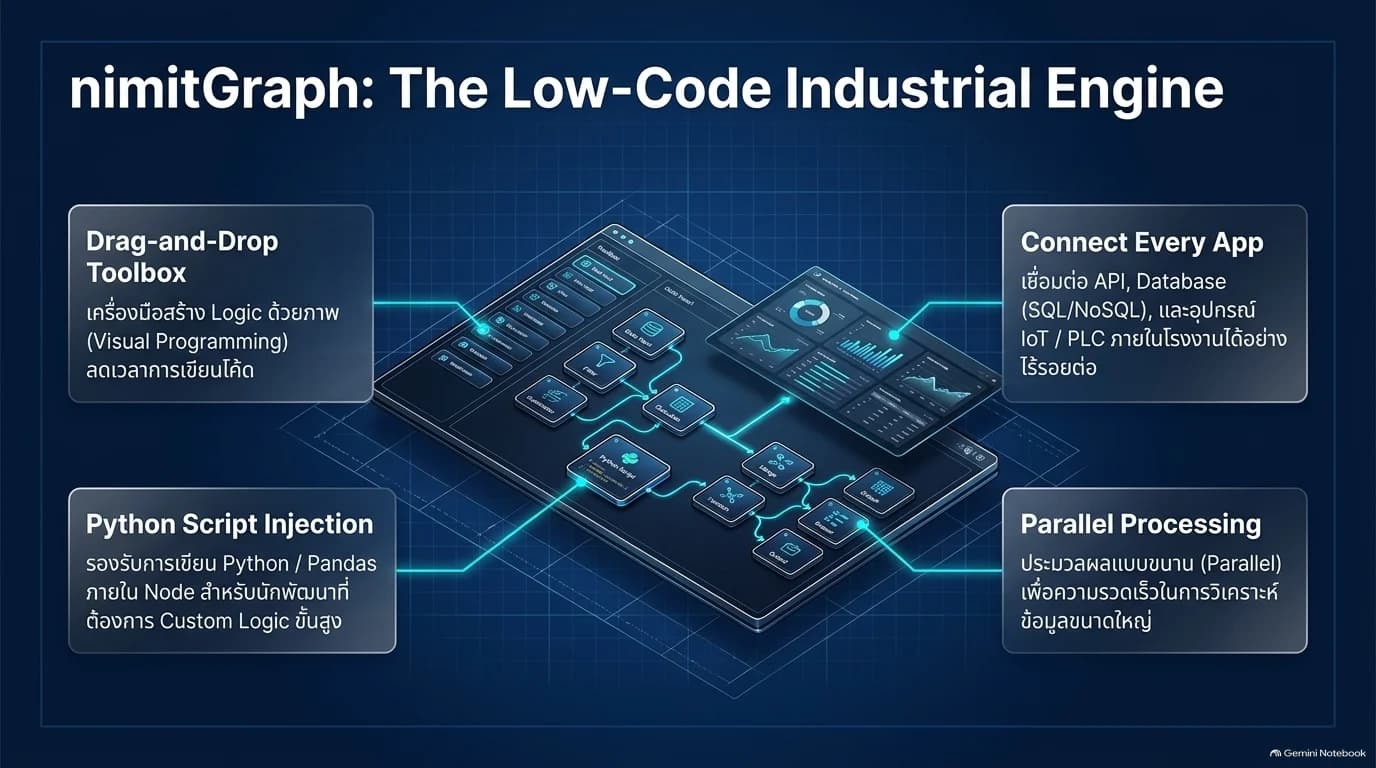
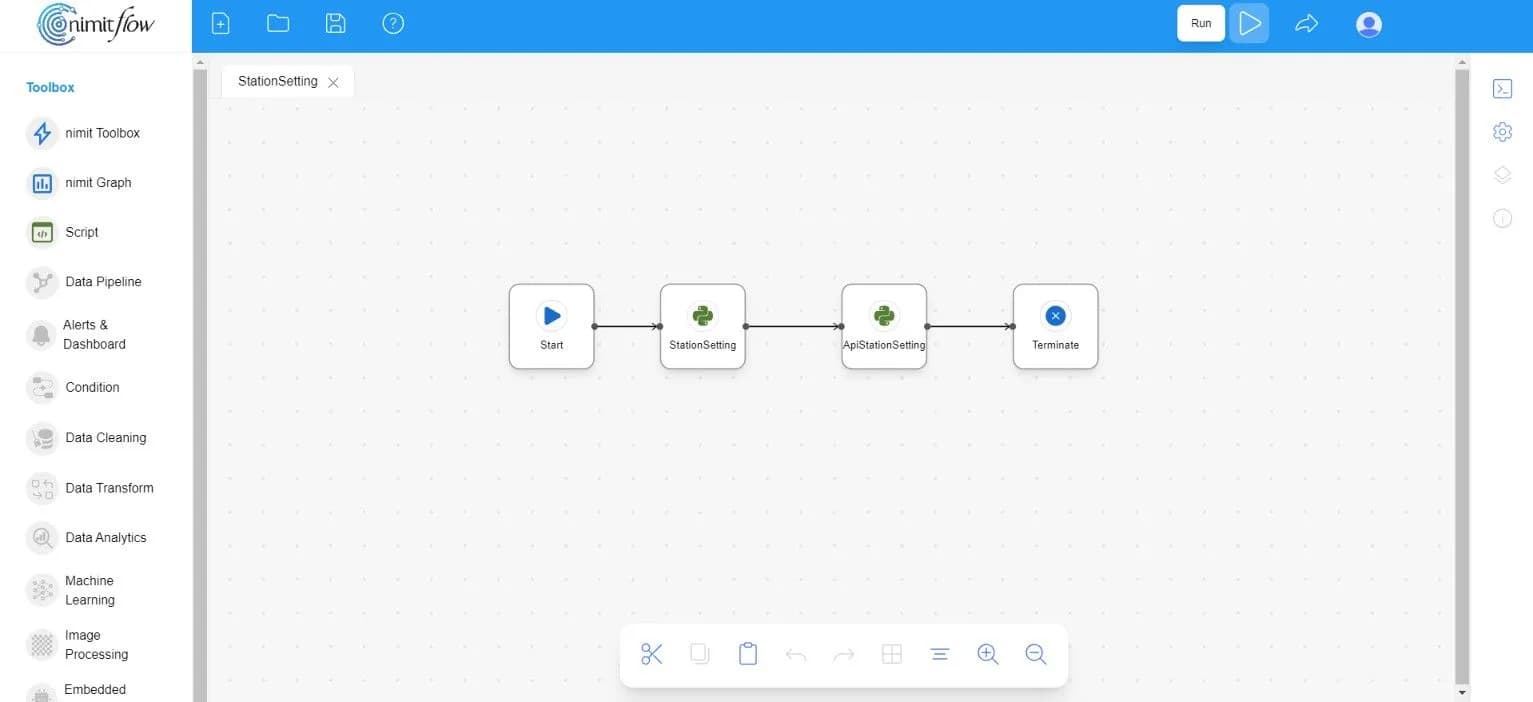
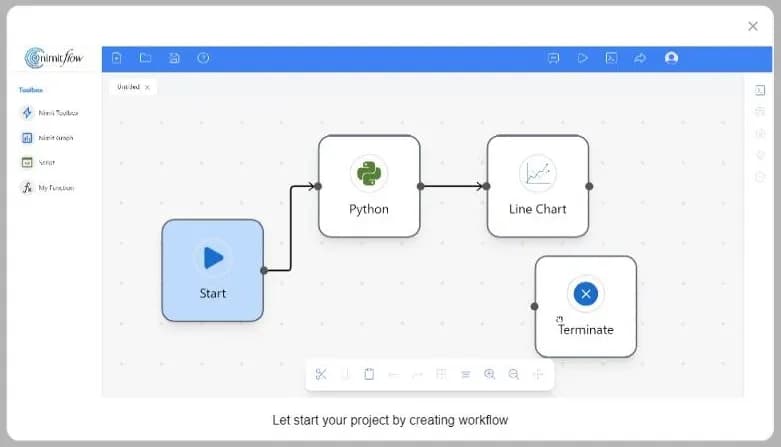
Toolboxからノードをドラッグして接続することでフローを設計し、ソース、処理手順、および目的地を定義します。プレゼンテーションドキュメントはこのジョブ作成方法をnimitGraphと呼びます。特定のジョブではノード内でPythonを使用して追加の条件を定義します
- 1
データ受信
PostgreSQL、MySQL、HTTP/REST、Webhook、または作業で使用するファイルを選択し、アクセス設定を構成します
- 2
操作の設定
データノードを接続し、値を変換し、計算を行い、ループし、またはPythonとAIを順番に呼び出します
- 3
テストとトリガーの設定
テスト実行、結果確認後、自分で実行を選択したり、タイミングを設定したり、またはWebhookからのイベントを受け取ります
- 4
結果をユーザーチームに送信
グラフを作成し、Excel/CSVレポートを作成するか、接続されたチャネルを通じてデータとアラートを送信します
- 特定の条件用のPythonとAIコードジェネレーターは、開発者が使用前にレビューするためのコードを起草するのに役立ちます
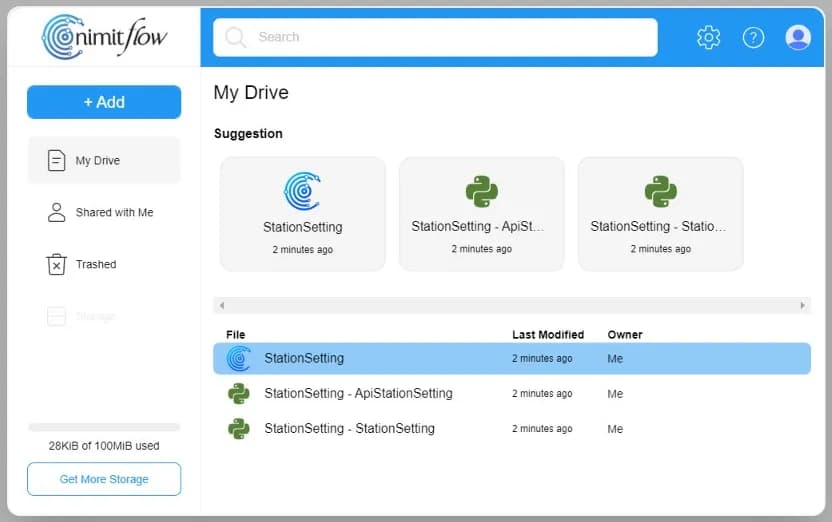
- nimitFlow Driveはファイルを保存し、所有者、編集者、および視聴者専用の権限を分割します
- .nimファイルとしてフローをエクスポートおよびインポートして、作業を再開するか、開発を継続します
- 既製ノードがないシステムやデータベースは、サポートされているエンドポイントに従ってPythonやAPIを通じてさらに接続します
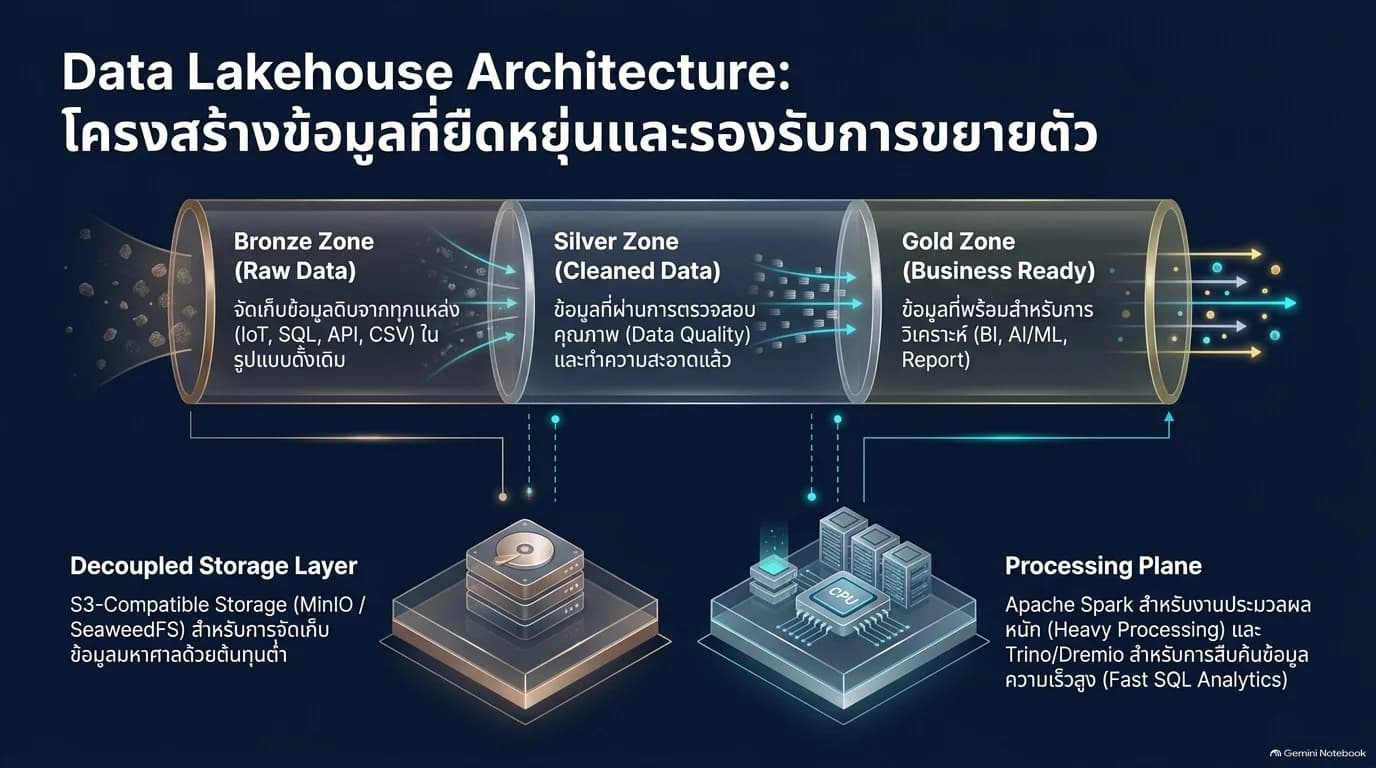
データパイプラインとデータレイクハウス:生データから利用可能なデータへ
nimitFlowを使用して、既存のSQL/NoSQLシステム、API、ファイル、およびオンサイトデバイスからのデータを中央データレイクにルーティングします。 ストレージステップを処理ステップから分離し、必要なデータの量と頻度に合わせてリソースを選択します。
| データレイヤー | 責任 |
|---|---|
| ブロンズ / 生データ | ソースフォーマットに従ってデータを保存し、ソースと受信時間も含めます |
| シルバー / 検証済みデータ | クリーン、完全性をチェックし、相互運用性のために標準化する |
| ゴールド / 使用可能なデータ | ダッシュボード、BIレポート、またはAIモデルの要件に応じてデータを準備します |
- ソースの準備が整っているかどうかに基づいて、バッチモードまたはストリーミングモードでデータ取り込みジョブを選択します
- S3互換のファイルストレージエリアを設計し、プロジェクトごとに処理または検索レイヤーを分離します
- 各レイヤーのデータ保持期間を定義し、アーカイブと復旧はシステム管理者と一緒に行います
作業サイズに応じた組立工具を選択する
Apache Airflow、Kafka、Spark、Trino/DremioおよびMinIO/SeaweedFSは、参照アーキテクチャでの選択肢です。個別のインストールと接続評価が必要であり、nimitFlowのすべてのパッケージには含まれていません。
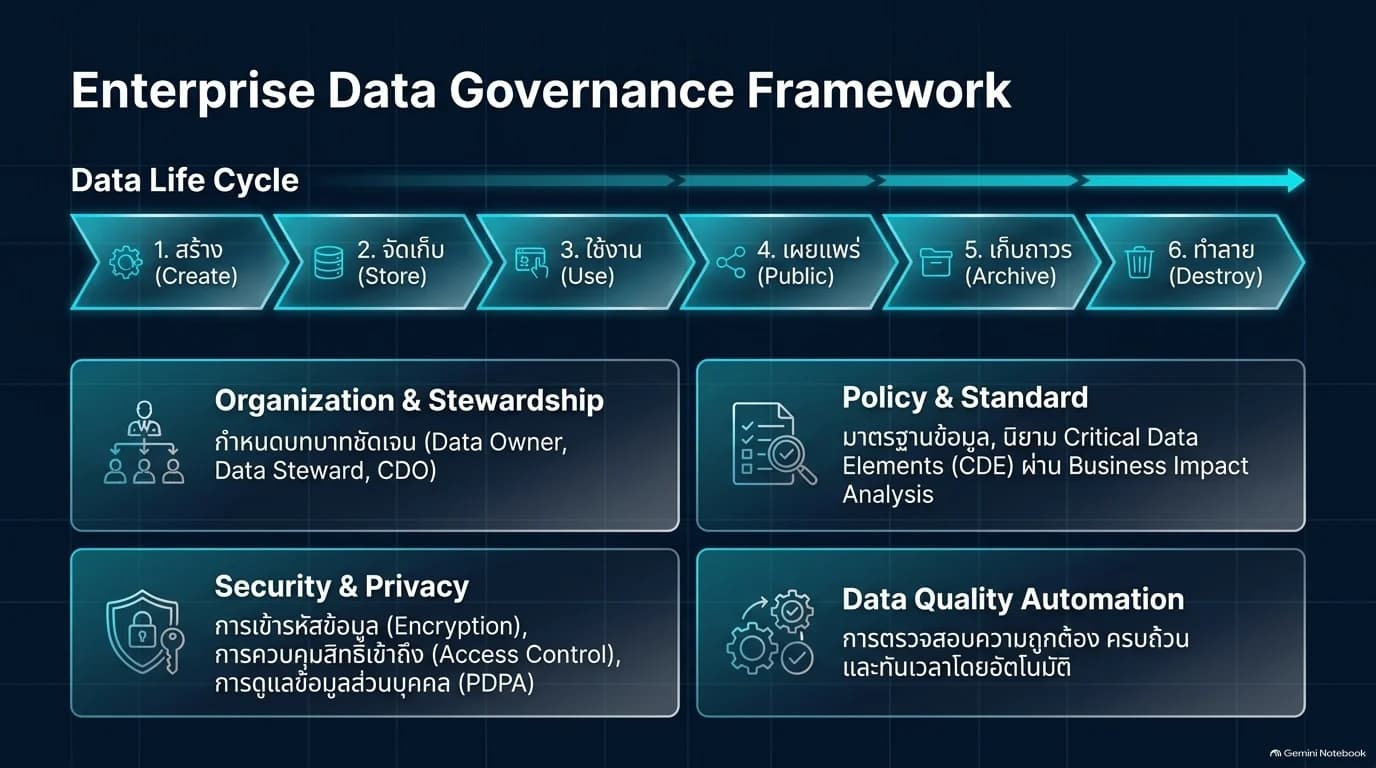
データガバナンス:ソースを知り、品質を確認し、データ権限を定義する
データフローと共にガバナンスを実装し、データ所有者としてデータ責任者を任命し、データ管理者として意味と品質を管理します。組織のルールをフローと統合されたカタログシステムに適用します。
- データカタログ/メタデータ:説明、ソース、管理者、およびデータセットのカテゴリを記録して見つけやすくする
- データ系譜:データがどのステップを通ったか、レポートでどこで使用されたかを示すことで、ソースを変更した際の影響を分析する
- 重要なデータ要素:空白値、データ形式、重複、完全性などの検証規則とともに重要なデータを特定する
- データ品質:バリデーションルールを設定し、ワークフローに基づいて異常を関連する担当者に報告する
- Security:導入するシステムに合わせて、アクセス権限、データのマスキング、キーや機密情報の管理を設計
データのライフサイクルは、作成、保存、利用、公開、アーカイブ、廃棄を含みます。各段階の責任者と条件を、組織の方針に合わせて定めます
- 1
データリクエストを処理する
組織のプロセスにデータが入力される際のアクセス要求、修正、または管理を記録する
- 2
検索および確認
カタログデータと接続チャネルを使用して関連アイテムを検索し、権限と範囲を確認します
- 3
承認
責任者にリクエストをレビューし承認させ、その後アクションを実行する
- 4
実行と履歴を記録する
承認結果に基づいてデータを管理し、結果と証拠を記録して後から見直せるようにする
統治業務の範囲
ルール、権限、承認者、処理時間は組織と一緒に定義する必要があります。ワークフローのインストールはプロセスをサポートしますが、組織がすべての要件を満たすことを自動的に保証するわけではありません
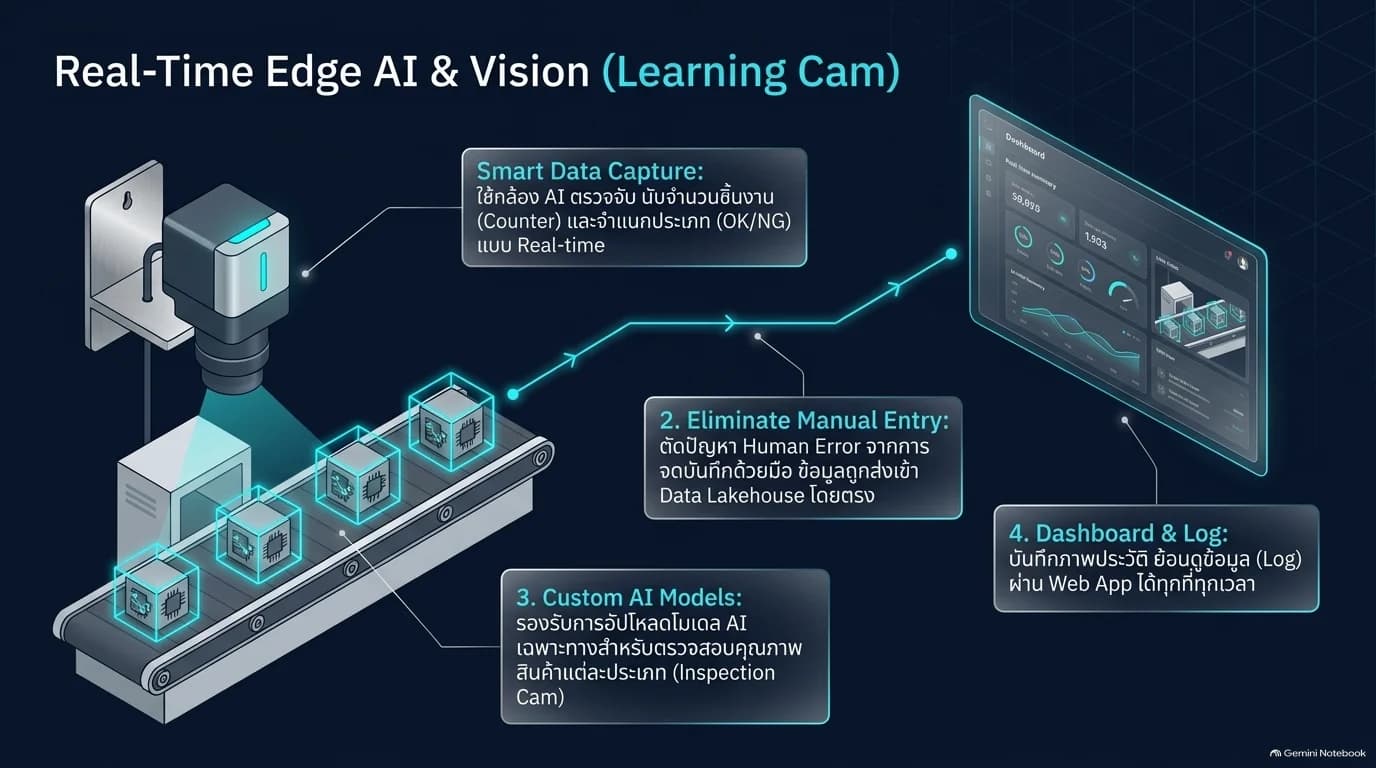
産業IoT: フィールドデータを全体的な工場概観に接続する
各デバイスとアプリケーションには特定の役割があります。nimitFlowは、信号、インターフェース、ゲートウェイを選択することで、レポートや共同ワークフローでさらに使用するためにデータを集めるのに役立ちます
| 作業ポイント | 接続用データ |
|---|---|
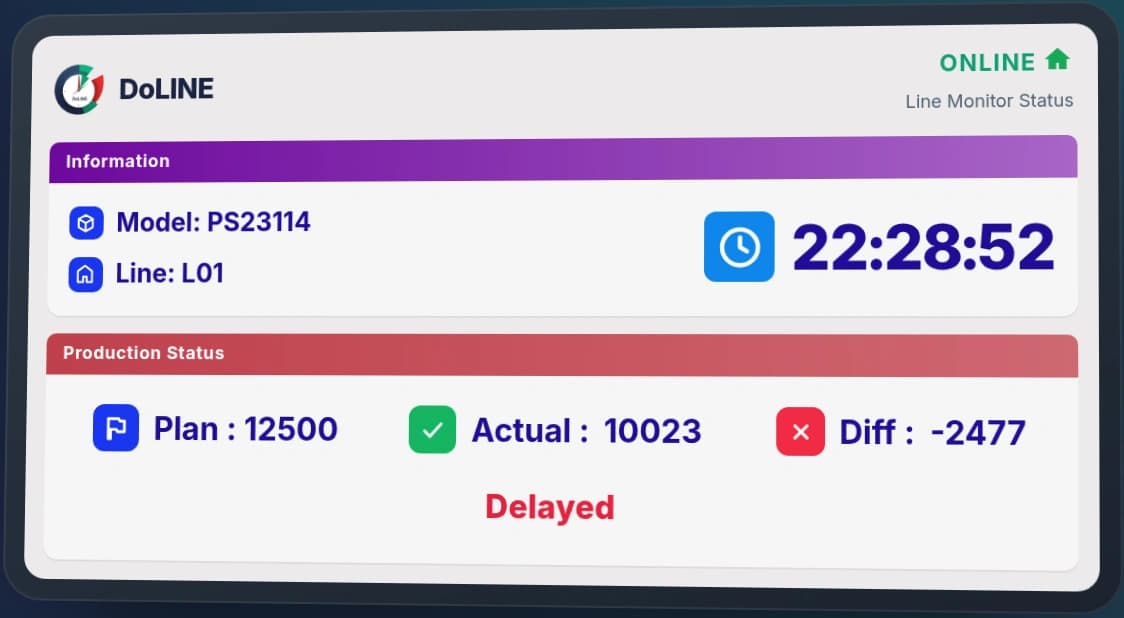
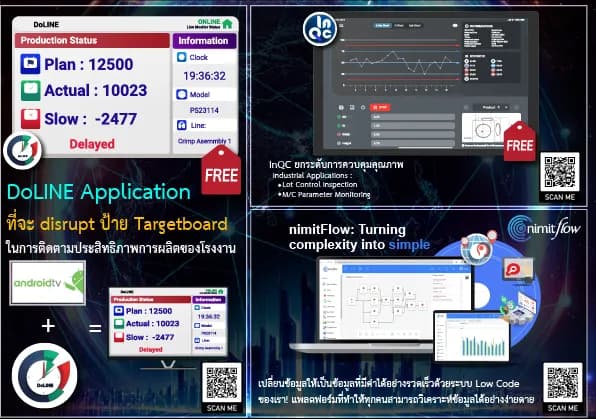
| DoLINE / 生産量 | 計画、実際の生産量、および生産ステーションからの差異 |
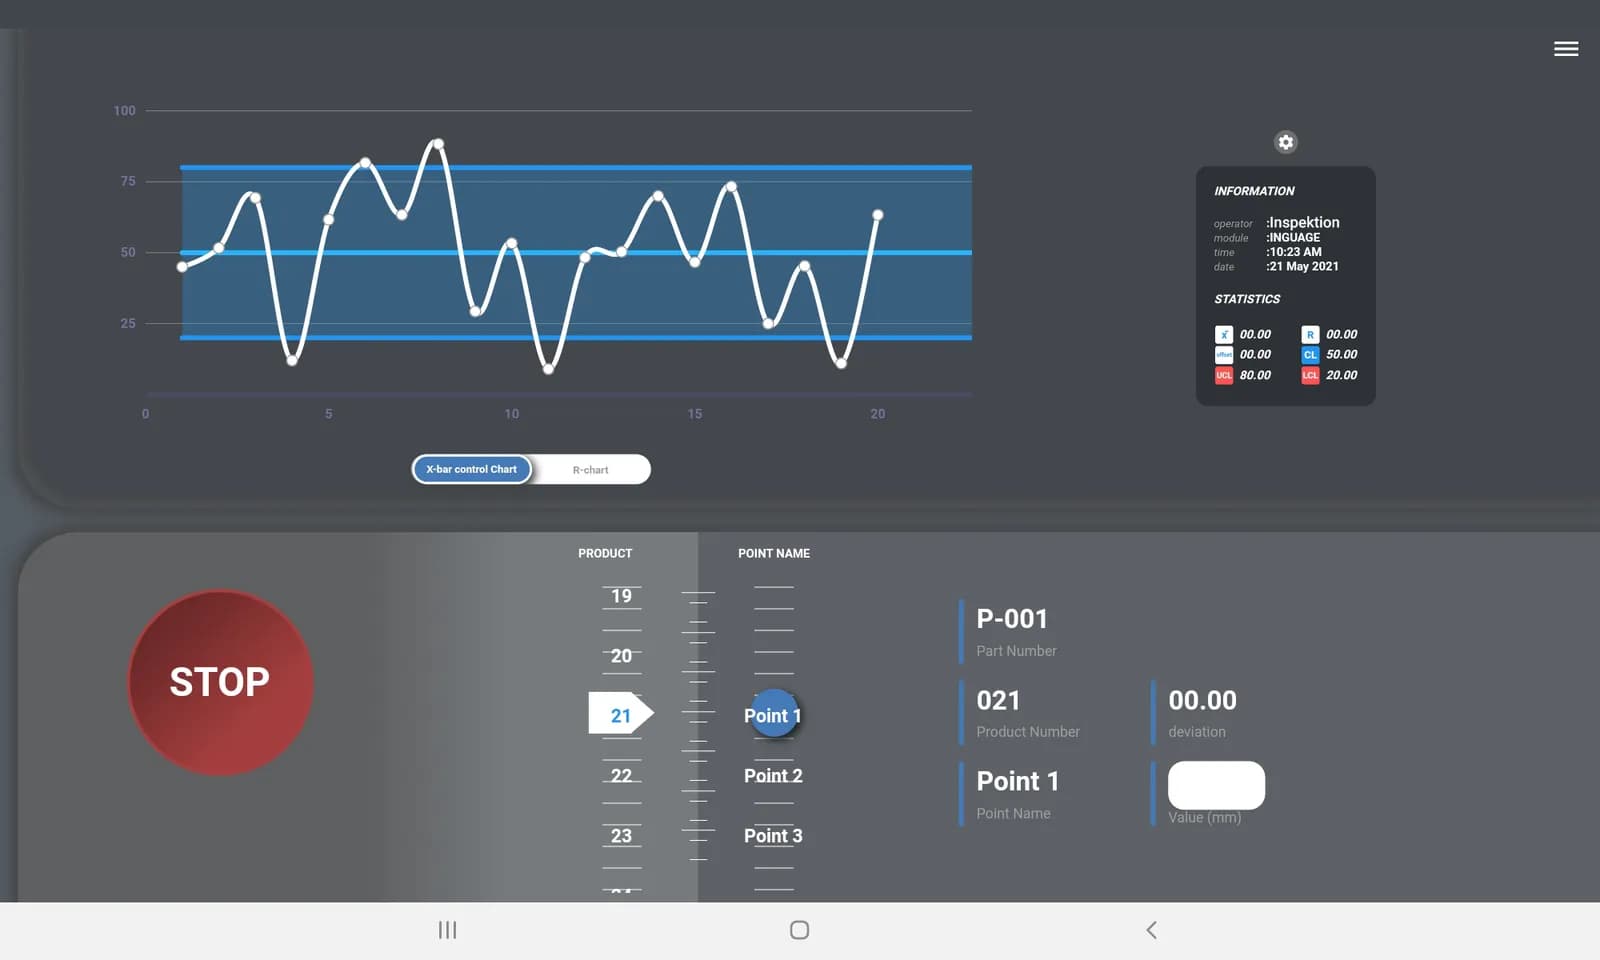
| InQC + InGauge / 品質 | 測定器からデータ収集装置を通じて得られた値と品質管理結果 |
| InCBM + InSensor / 設備状態 | センサー値がInSensorを通じて受信され、接続システムから設備状態データが取得されます |
| LearningCam / 製品検査 | 製品の検査結果、数え上げ、またはモデルとテスト条件に基づいて製品を分類します |
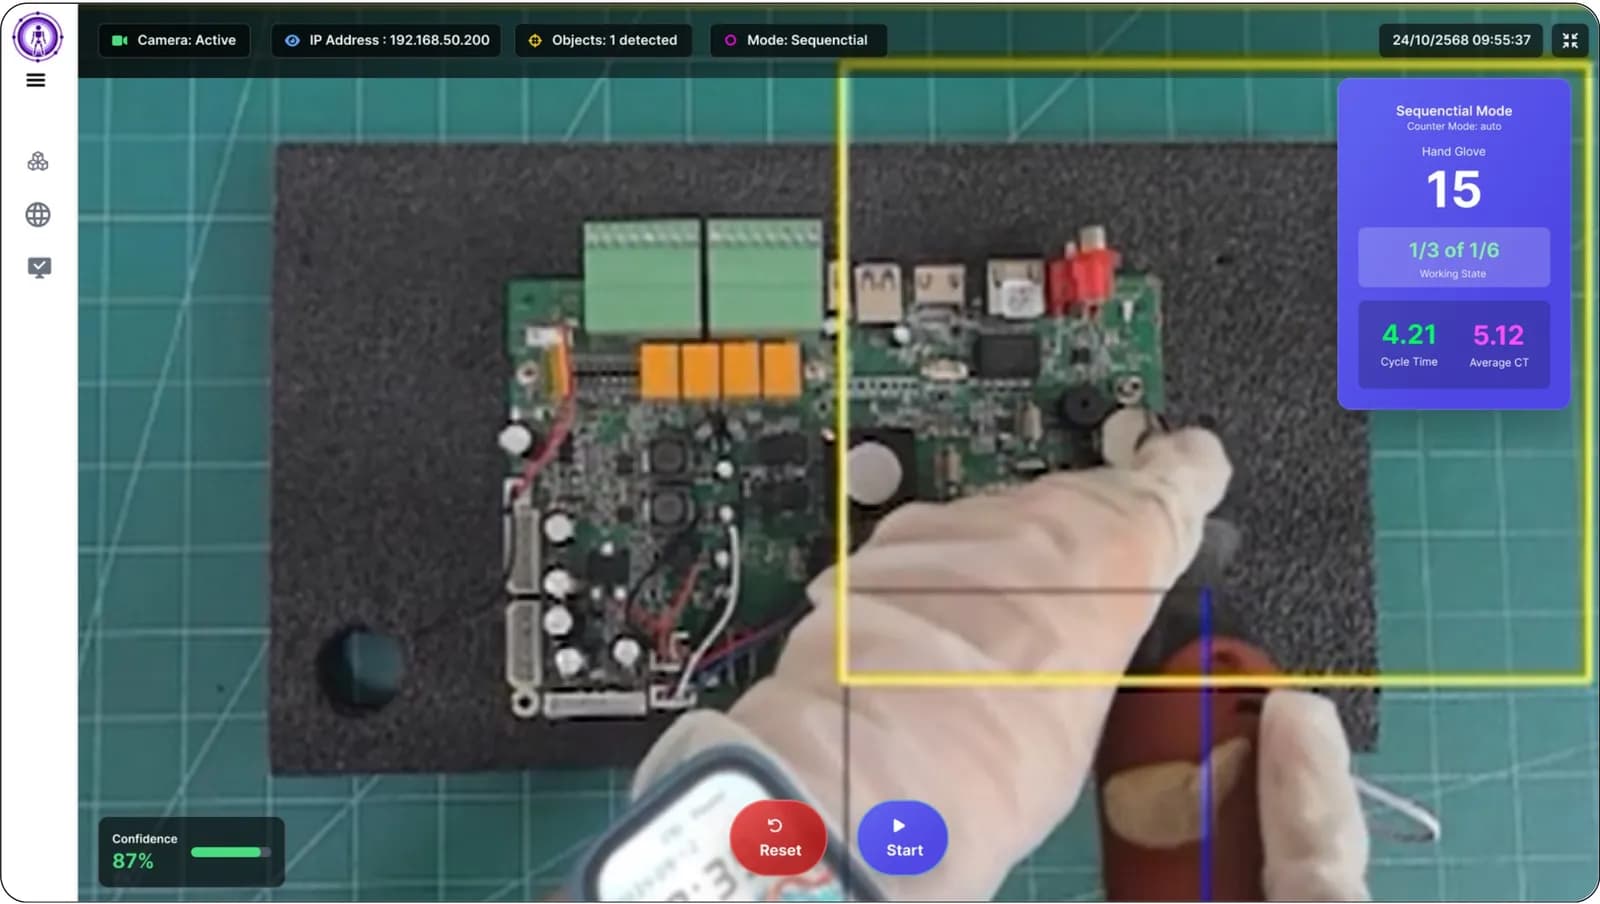
| Task Cam / 作業手順 | 作業ステーションでの作業手順の確認と時間 |
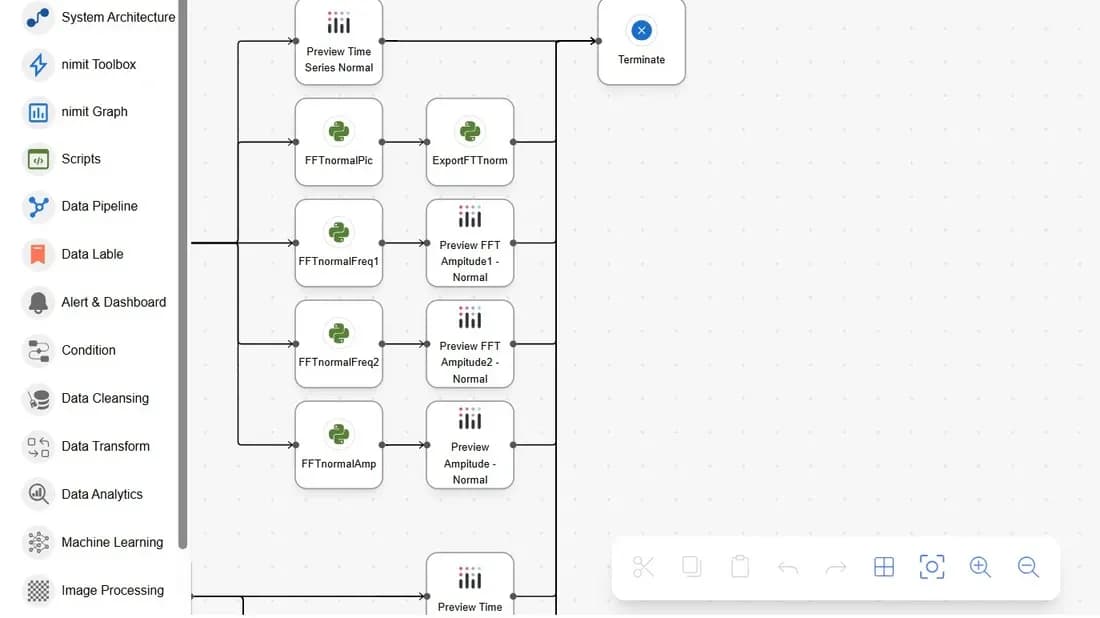
振動解析作業の場合、データを受信する → シグナルとFFTグラフを処理する → 指標やモデルに従って分析する → 結果を修理・保守チームに送ることができます。モデルを使用した分析は、InCBMの閾値監視とは別に準備し、テストを行う必要があります。
AIと機械学習を作業プロセスに統合する
準備および検査済みデータをAI作業の出発点として提供します。Flowを使用してデータの準備、モデル呼び出し、分析結果の送信をシーケンス化します。
- 時系列データと異常検知:時系列データから変数を作成し、基準値と比較し、異常検知をテストします。
- AIビジョン:実時間データを処理するカメラからの検査結果を受け取り、生産数量、品質、ステーション履歴とリンクさせます。
- LLM:AIノードを通じてモデルを接続するか、組織内で動作するモデルのためにOllamaを使用します。
- ダッシュボードとレポート:トレンド、モデル結果、ジョブステータスをユーザーがアクセス可能なデータと共に表示します。
決定前にテストを行う
正確さと速度はデータ、モデル、機器、作業条件に依存します。テストは別々の検証データセットと実際の使用前に受け入れ基準を定めて行う必要があります。
ポリシーとワークロードに合わせたインストールを選択する
ユーザー数、データソース、Flowの実行頻度、ストレージ容量、運用担当者を評価し、Cloud Subscriptionまたは組織内のServerへの導入(On-Premise)を選択します
| 形式 | 準備要件 |
|---|---|
| Cloud Subscription | 組織が許可したシステムに送信されるデータの範囲、ユーザー、接続チャネル |
| On-Premise | サーバーネットワーク、ストレージスペース、バックアップシステム、および内部管理者 |
| Enterprise / High Availability | 処理セクションを分離し、バックアップとサービススイッチング、作業範囲内の復旧テストを設計する |
| 閉鎖ネットワーク / アイアーギャッピッド | すべてのフロー、モデル、コンポーネントをチェックして、それらが内部で動作することを確認し、インストール方法、更新、およびデータ入出力を含む |
別途の文書で定義されたエンタープライズアーキテクチャは、Edge、App、Data、Executionの各領域を定義し、各セクションの権限とリソースを設計します。コンテナアプローチやクラスターシステムの選択は、インストールする環境とバージョンに一致させる必要があります
見積もりを依頼する前に範囲を定義する
データレイクハウス、カタログ、HA、AIモデル、エッジデバイスはプロジェクトに基づいて評価され、サービスの数、データ取り込みレート、可用性レベルは設計とテスト結果を参照する必要があります
実際の問題から始めて、受け入れ可能な結果を定義する
- 1
既存のデータと作業を確認する
上流データサンプル、レポートフォーマット、ユーザー、およびネットワーク制限を収集する
- 2
パイロットプロジェクトを選択する
検査チームが合意した結果と受け入れ基準を含む一つのフロータスクを定義する
- 3
接続してテストする
実際のデータでテストし、エラー、権限、上流システムが停止した場合の動作を確認する
- 4
引き渡しと拡大
新しいデータソースやモデルを追加する前に、マニュアル、責任者、バックアップとその後の作業を準備する
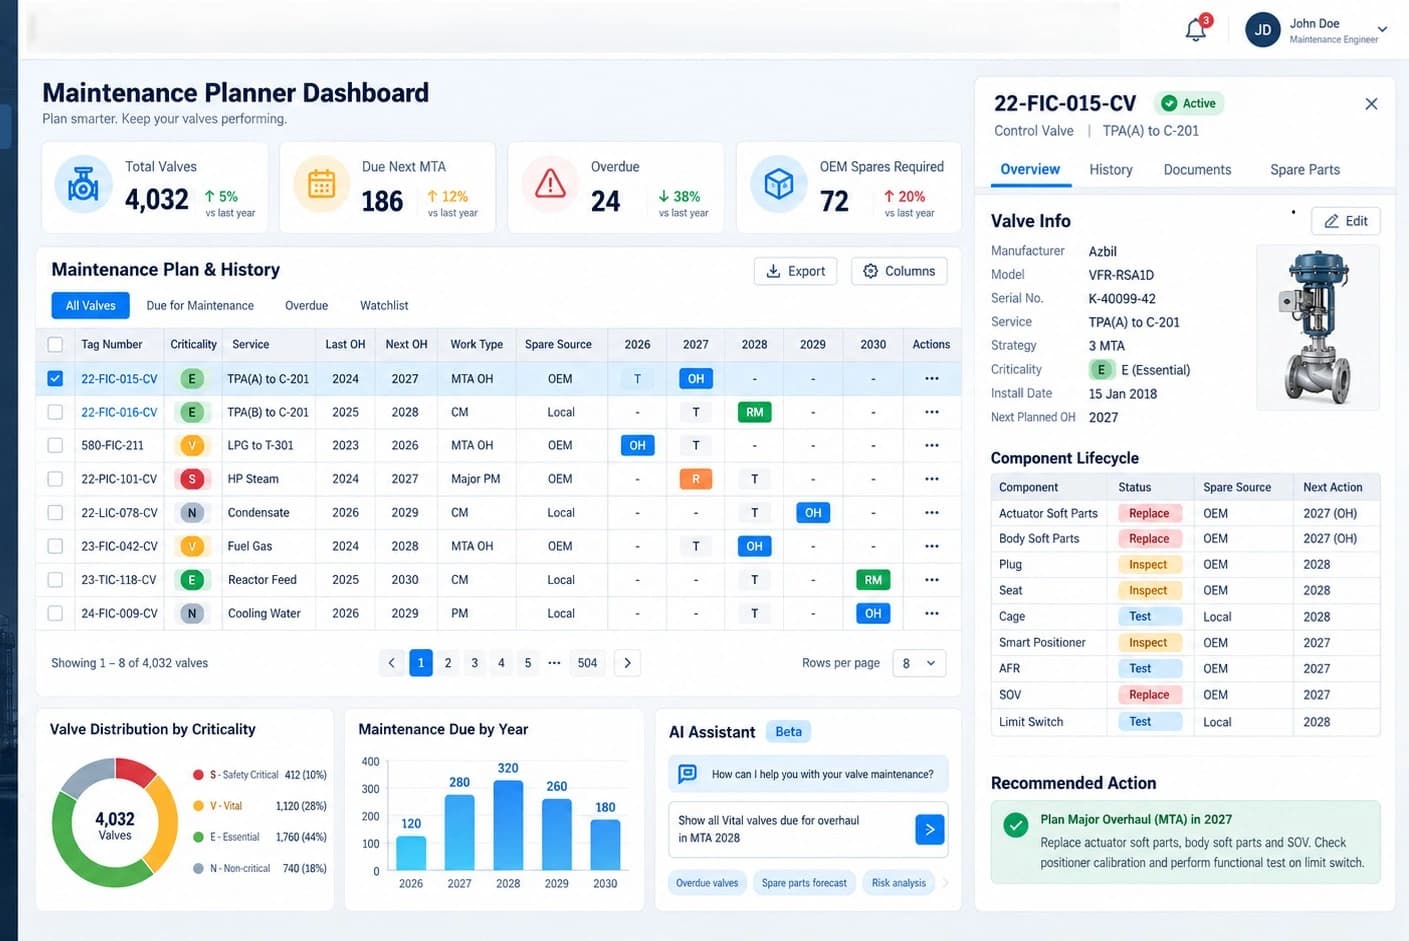
データ収集時間、重複作業の削減、検出されたデータ品質、および組織のシステム維持費からコスト効果を評価します。デモンストレーション画像の節約数値や正確さをすべてのプロジェクトの証明として使用しないでください。
技術仕様
| タイプ | 自動化およびデータパイプラインシステム用の低コード/ノーコードソフトウェアプラットフォーム |
|---|---|
| 現在のバージョン | nimitFlow 4.02a(仏暦2569年九月時点の情報) |
| 使用 | ウェブブラウザからアクセス可能 |
| インストール形式 | 企業サーバーにDocker Composeを使用してインストール(コンテナインストールパッケージ)(オンプレミスまたはクラウドサブスクリプション) |
| バックエンド技術 | Pythonバックエンドシステム · PostgreSQLデータベース · Next.js / Reactウェブページ |
| 使用可能なノード | Python、AI LLM、PostgreSQL、MySQL、HTTP/REST、複数のグラフタイプ、Loop、Trigger(手動 / スケジュール / Webhook)、nimitFlow Drive |
| Pythonで接続 | MSSQL、MongoDB、InfluxDB、SharePoint、Power BI、Power Apps、Superset、Dremio、OpenMetadata、LINE、メール |
| フローファイル | .nimファイル(フロー全体のエクスポート/インポート)およびリモートデバイス設定用のCSVファイル(DoLINEボードなど) |
| ファイルストレージ | nimitFlow Drive(My Drive、Shared with Me、Trashed)で、所有者/編集/閲覧のみの権限に応じて共有 |
| セキュリティ | JWT(認証トークン)によるログイン · 各コマンドの権限を確認 · データベースノードは読み取り専用 · データベースパスワードを暗号化 · PythonはSandbox内で実行 |
| データ送信デバイス Inspektion | Task Cam、InQC、InGauge(InQC経由)、DoLINE、LearningCam、DoRare |
| レポートとアラート | Excel / CSVレポート · 作業範囲に応じたPythonスクリプトによる通知 |
最小Server仕様、パッケージごとのユーザー数、ストレージ容量は、標準の数値を定めていません。案件の規模に応じて担当チームが評価します
アーキテクチャと接続性
FROM SOURCE TO ACTION
データパスをソースから最終ユーザーまで確立する
既存システムが接続のために開くチャネルから始めて、nimitFlowでデータ受信、検査、処理、転送の順番をつける
- 01
元データ
データベース · API · CSV · ゲートウェイを通じてマシン · フロントエンドアプリケーションからの結果
- 02
nimitFlow
トリガー → データ受信 → 検証と変換 → Python / AI → 結果送信
- 03
データを使用する
ダッシュボード · レポート · 工場アプリ · データレイクと企業システム
ワークロードとデータポリシーに応じて構造を拡張する
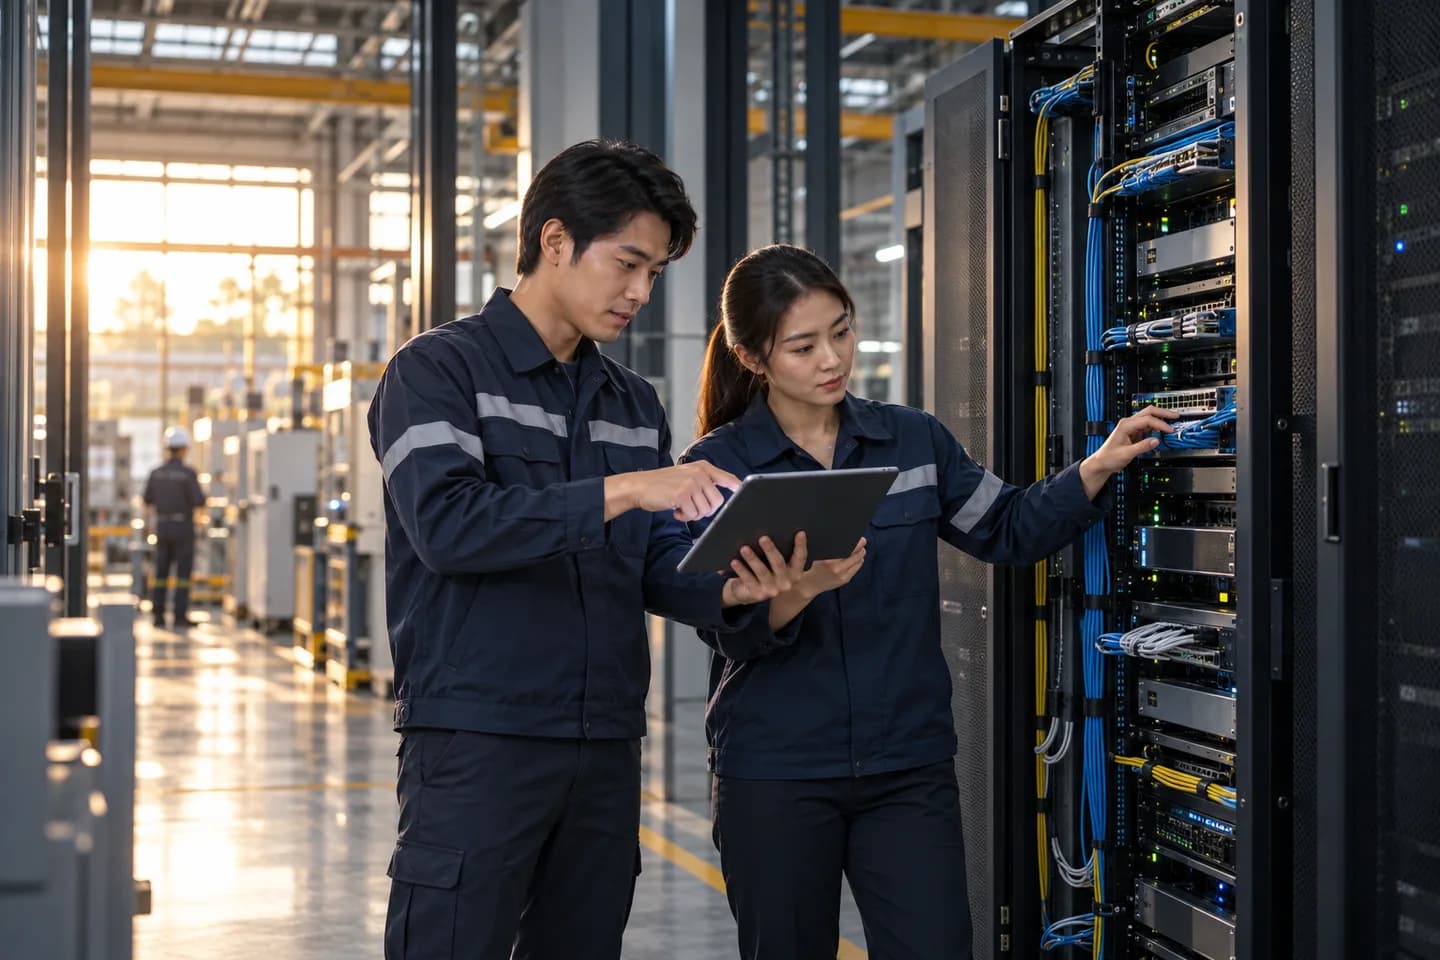
作業現場のセンサーやカメラ、ゲートウェイ(例:InSensor は機械データの受信用)
ウェブインターフェース、ユーザーAPIアカウント、アクセスルール
データベース、ファイルストレージ、選択されたデータレイク
ワーカープロセスがフロースクリプト、Python スクリプト、および分析ジョブを処理します
クラウドとオンプレミスはインストールオプションですが、HA、閉域ネットワーク、ワーカーのスケーリングは実際のシステムに合わせて設計とテストが必要です。また、各フローでの外部サービス呼び出しのチェックも含まれます。
接続可能なシステム
- PostgreSQL
- MySQL
- HTTP / REST API
- Webhook
- ERP / MES統合用API
- LLM: Gemini · Claude · ChatGPT · DeepSeek
- Ollama(企業向けLLM)
- MSSQL · MongoDB · InfluxDB(Python経由)
- SharePoint · Power BI · Power Apps(Python経由)
- LINE · メール(業務範囲内でPython経由)
- Task Cam
- InQC
- DoLINE
- LearningCam
- InCBM
システム要件
- ユーザーはWebブラウザから利用でき、端末にソフトウェアをインストールする必要はありません
- 組織内への導入:Ubuntuを搭載したServerに、Docker Compose(コンテナ形式の導入セット)でシステム全体を一括インストールします
- 処理担当プロセス(Worker)を追加して、より多くのジョブに対応
- 組織内でAIを使用する:Ollama、LM Studioまたはllama.cppを使用してLLMを実行するマシン
- クラウドサブスクリプションモデル:独自のサーバーを調達または維持する必要はありません
利用パッケージ
ライセンスモデル
年間サブスクリプション
クラウドサブスクリプションモデルは月額料金で、8,000 THB/月から開始します。オンプレミス展開の場合、料金はユーザー数と接続範囲に基づいて評価されます。
- 価格にはVATは含まれていません
- オンプレミス展開の見積もりをチームに依頼する
組織のデータポリシーや予算に応じて使用モードを選択
Cloud Subscription
月額THB 8,000から
- ウェブ経由での利用、サーバー管理の必要なし
- 継続的な機能更新システム
オンプレミス展開
見積もりを依頼
- Docker Compose を使用して組織のサーバーに展開(コンテナインストールパッケージ)
- データと AI は組織内のネットワーク内で動作します
- ユーザー数と接続範囲に基づく価格設定
価格にはVATは含まれていません — 詳細はユーザー数と接続範囲によります
利用業界
- 一般的な製造プラント
- エネルギー(精錬所メンテナンス作業)
- サービス
- 自動車部品(プロトタイプ作業)
スクリーンショット
始め方
nimitFlowは自己インストールが可能ではなく、組織ごとのデータやプロセスに合わせてフローを設計する必要があるためです。初期ステップはデモのスケジュール、パイロットプロジェクトの選択、および実際の組織データでのテストです。エンジニアリングチームが準備状況を評価し、フローを設計します。
準備するもの
- 接続するデータソースの一覧、例えば既存のInspektion装置(InQC、DoLINE、Task Cam、InGauge)、データベース、センサー、または旧ERP/MESシステム
- 実際のデータ例、例えばExcel/CSVファイルや現場で現在使用されている紙フォーム
- 自動化したいタスク、例えば毎日の再発生レポートやLINEやメールアラートが必要な条件、受信者のリストと共に
- 希望のインストールタイプ — Cloudかオンプレミスサーバーインストール(On-Premise)データポリシーに従って、組織でのAI利用を望むかどうか
- 概算のユーザー数と接続範囲、これらは価格計算に使用されます
よくある質問
nimitFlowとは何か?何に使うことができますか?
nimitFlowはデータを接続し、フローを使用して自動ワークフローを作成するためのLow-Codeプラットフォームです。データベース、API、および現地からのデータを受け取り、PythonまたはAIで処理し、レポートや通知を出力します。また、データウェアハウスやガバナンスプロジェクトと統合することもできます。
コードの書き方が必要ですか?
一般的なタスクはフォームとノードを通じて設定され、接続が可能です。特定のタスクはPythonを使用し、AIコードジェネレーターを利用して開発者がレビューするコードを起草します。Low-codeにより冗長なコード書き込みを減らすことができますが、実際のデータに合わせてフローを設計およびテストする必要があります。
価格は何ですか?Data Lakehouseは開始価格に含まれていますか?
Cloud Subscriptionは月額8,000 THB(VAT別)からです。On-PremiseとEnterpriseは作業範囲に応じて評価します。Data Lakehouse、Catalog、HA、AIモデル、現場の機器は個別の評価が必要であり、すべてが最低価格に含まれるわけではありません
組織または閉鎖ネットワークでインストールできますか?
nimitFlowは組織のサーバーにインストールでき、内部LLMをOllama経由で使用することができます。閉鎖ネットワークのジョブでは、外部サービスに頼らず、すべてのフローモデルとコンポーネントをチェックし、更新方法とシステムメンテナンスの方法を組織の責任者と一緒に設計する必要があります。
機械データをnimitFlowにどのように接続するか?
センサーまたはPLCは、適切なゲートウェイ(例:InSensor)を選択して信号に一致させるためのサポートされているデータ読み取りチャネルを持つ必要があります。その後、データをフローに入力し、検査、変換、およびInCBMなどのアプリケーションや工場レポートに使用します。チームは設置前に各デバイスのインターフェースと条件を評価します。
すべてのコンポーネントを同時にインストールする必要があるか?
いいえ、最初に必要なフローとデータソースから始め、その後、適切な課題とリソースがあるときにデータウェアハウス、管理ツール、AIモデル、バックアップシステムを追加します。文書内の画像は、パッケージではなく、解決策のアプローチを示しています。