Pilih AI Server yang sesuai dengan kerja anda: dari mesin kecil hingga berbilang GPU
Pasukan jurutera Inspektion · Diterbitkan 14 November 2026 · Kemas kini terakhir 14 November 2026
Panduan AI Server: bandingkan DGX Spark dan Workstation. Pilih GPU, VRAM, RAM, CPU, PCIe, storan dan kuasa, kemudian uji pengguna serentak.
Ringkasan
- Mulakan daripada kerja dan model, kemudian kira memori sebelum memilih GPU; jangan mulakan daripada harga mesin sahaja
- 128 GB unified memory pada DGX Spark bukanlah VRAM kad berasingan, dan GPU tidak boleh ditambah seperti pada PC
- GPU berbilang memerlukan perisian dan topology yang menyokongnya; VRAM tidak digabungkan secara automatik
- Bilangan pengguna mesti diukur daripada permintaan serentak, context dan masa jawapan, bukan ditentukan daripada saiz GPU sebagai satu nilai sahaja
- Periksa RAM, Storage, PCIe, network, kuasa dan haba bagi seluruh sistem, serta uji sebelum membuat pesanan
Mulakan daripada kerja, bukan daripada nama kad grafik
Memilih AI Server menyerupai memasang komputer, tetapi anda perlu melihat saiz model, kelajuan penghantaran data dan bilangan kerja yang berlaku serentak. Mesin yang boleh memuatkan model mungkin masih tidak dapat menjawab pengguna tepat pada masanya, dan menambah GPU tidak banyak membantu jika data tersekat di Storage, CPU atau rangkaian. Artikel ini membahagikan mesin kecil, sederhana dan besar mengikut corak penggunaan, bukan mengikut standard saiz pengeluar
- Tentukan kerja: menggunakan model yang sudah ada, melatih tambahan daripada model asal, atau melatih model baharu dari awal
- Tentukan jenis data — teks, imej, video atau berbilang jenis, termasuk panjang soalan, resolusi imej dan bilangan fail
- Tentukan masa yang boleh diterima: perlu jawapan serta-merta, kerja boleh masuk baris gilir, atau diproses secara pusingan pada waktu malam
- Tentukan orang dan kerja serentak: jumlah bilangan akaun tidak sama dengan bilangan permintaan yang sedang diproses oleh mesin
Istilah yang digunakan sepanjang artikel
Inference = menggunakan model untuk menjawab atau meramal, Training = melatih model, Fine-tuning = melatih tambahan daripada model asal, VRAM = memori pada GPU, RAM = memori utama, Token = unit teks yang diproses oleh model, yang tidak sama dengan bilangan perkataan Thai secara satu dengan satu CPU ialah pemproses utama yang menyediakan data dan mengatur tugas, manakala GPU sesuai untuk banyak pengiraan secara selari. Batch ialah kumpulan data yang diproses bersama. Context ialah maklumat yang digunakan model untuk menjawab soalan. Quantization mengurangkan bilangan bit untuk mewakili pemberat model bagi menjimatkan memori, dan mutu hasil perlu diuji semula.
Apakah bezanya antara mesin kecil, sederhana dan besar
Pilih bentuk mesin yang sepadan dengan cara penggunaan
| Saiz dalam artikel ini | Sesuai sebagai titik permulaan | Kelebihan | Batasan |
|---|---|---|---|
| Kecil: DGX Spark | Pembangunan, uji kaji model, dan kerja AI dalaman yang skopnya telah diuji | Mesin padat, mempunyai memori kongsi bersaiz besar dan set perisian AI | Tidak boleh menambah kad GPU seperti pada PC; periksa Arm64 dan kelajuan dengan kerja sebenar |
| Sederhana: PC / Workstation + GPU | Kerja imej, LLM dan latihan tambahan yang GPUnya boleh dipilih secukupnya | Boleh memilih kad, RAM dan SSD mengikut platform; lebih mudah diurus daripada mesin berbilang nod | Slot, lane PCIe, kuasa dan haba mengehadkan bilangan kad |
| Besar: GPU Server / berbilang nod | Kerja berbilang pasukan, model besar, atau latihan dan penyediaan perkhidmatan yang perlu diperluas | Mereka bentuk GPU, rangkaian, sistem kuasa dan penjagaan pada tahap pusat data secara bersama | Perlu ada ruang, sistem penyejukan dan pasukan penjagaan; GPU berbilang tidak sentiasa menjadi lebih pantas mengikut bilangannya |
Saiz badan mesin, harga atau bilangan GPU sahaja bukanlah hasil ujian keupayaan menampung kerja
DGX Spark dilahirkan untuk apa
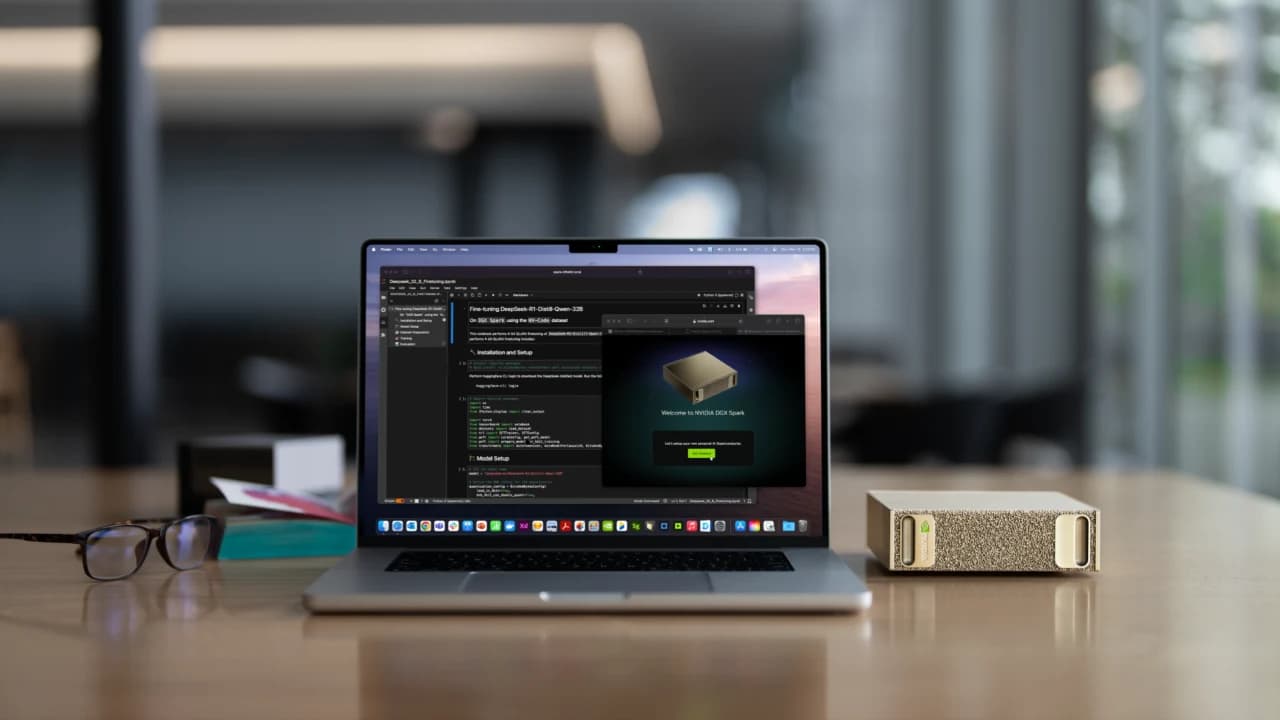
NVIDIA DGX Spark menggunakan GB10 Grace Blackwell Superchip dengan CPU jenis Arm dan memori kongsi 128 GB untuk CPU/GPU. Kelebihannya ialah anda boleh membangunkan, menguji, menala dan menggunakan model di atas meja kerja, tanpa perlu bermula daripada memasang mesin berbilang kad. Ia mempunyai lebar jalur memori menurut spesifikasi 273 GB/s, jadi anda perlu melihat kedua-dua kapasiti dan kelajuan; jangan tafsirkan 128 GB sebagai sama dengan kad VRAM 128 GB [1]
- Sesuai untuk uji kaji LLM, pembantu carian dokumen, kerja pembangunan AI dan penilaian model dalam organisasi, sebelum diperluas ke mesin yang lebih besar
- Memori kongsi membuatkan CPU/GPU menggunakan ruang yang sama, tetapi sistem pengendalian dan program lain juga menggunakan ruang ini, jadi tidak tinggal 128 GB penuh untuk model
- Anda perlu memeriksa sama ada framework, container, library dan komponen tambahan menyokong Arm64 dan GPU model ini. Bukan semua perisian x86 yang lama boleh dipindahkan untuk digunakan di sini.
- Ini bukan jawapan automatik untuk jumlah pengguna yang banyak atau untuk melatih model besar dari kosong. Anda perlu mengukur masa tindak balas dan jumlah kerja yang sebenar.
Lihat AI Server bersaiz kecil pada NVIDIA DGX Spark harga permulaan lebih kurang 300,000 THB. Ini ialah bajet permulaan bagi tawaran Inspektion, bukan harga jualan runcit sejagat NVIDIA. Senarai perkakasan, perisian, pemasangan, cukai, jaminan dan tarikh penghantaran disahkan mengikut sebut harga.
PC dan Workstation: pilih GPU yang sesuai dengan kerja
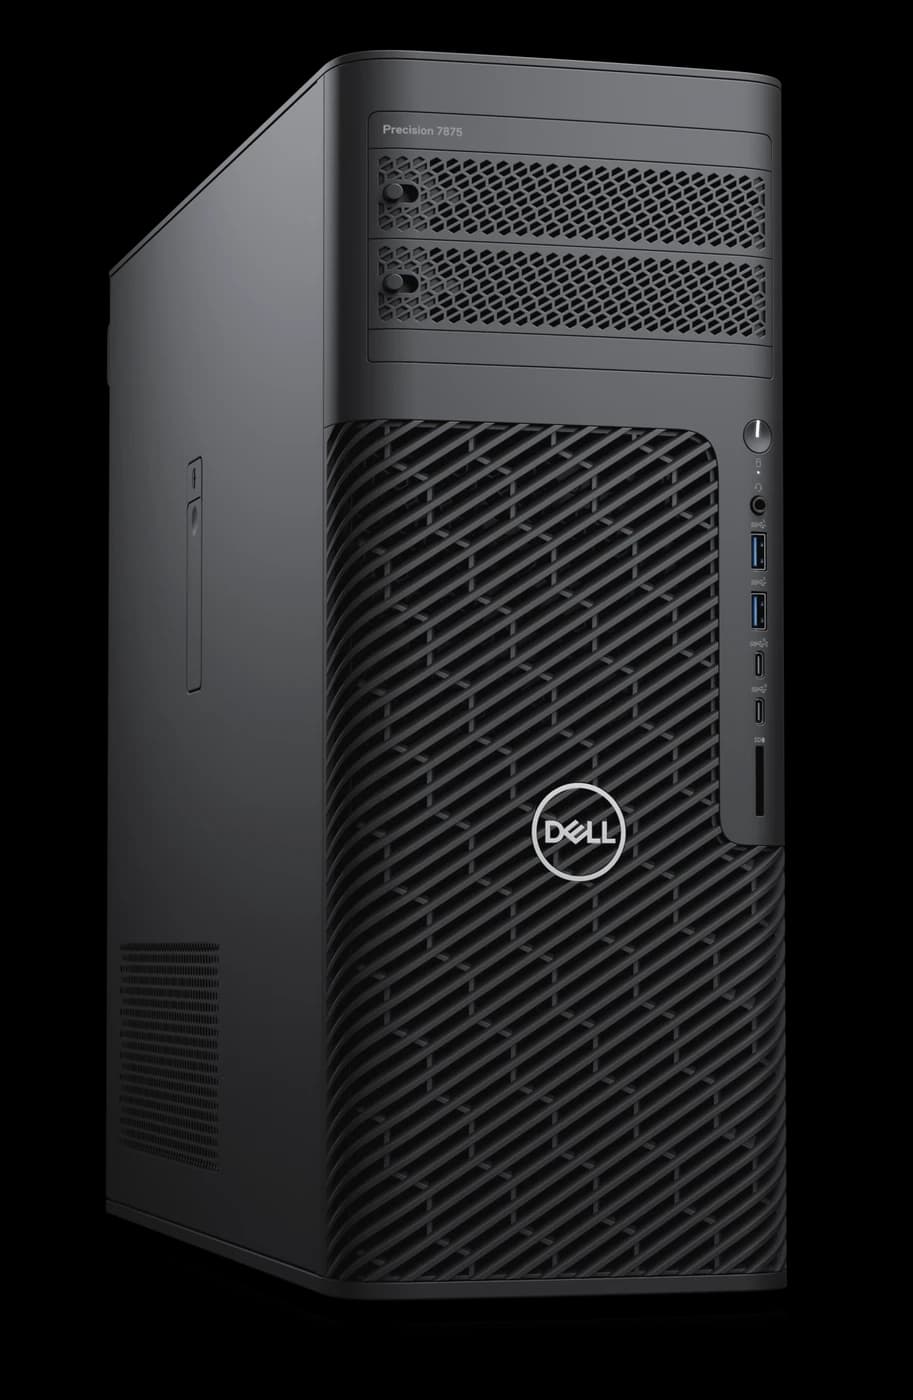
PC sesuai apabila bajet dan keperluan sudah jelas. Workstation menambah pilihan dari segi memori ECC, lane PCIe dan sokongan perkakasan mengikut model. Perbezaan yang perlu diperiksa ialah papan induk, CPU, kes, sistem kuasa dan senarai peranti yang disahkan oleh pengeluar — bukan sekadar kerana ada perkataan Workstation maka semua jenis kad boleh dipasang.
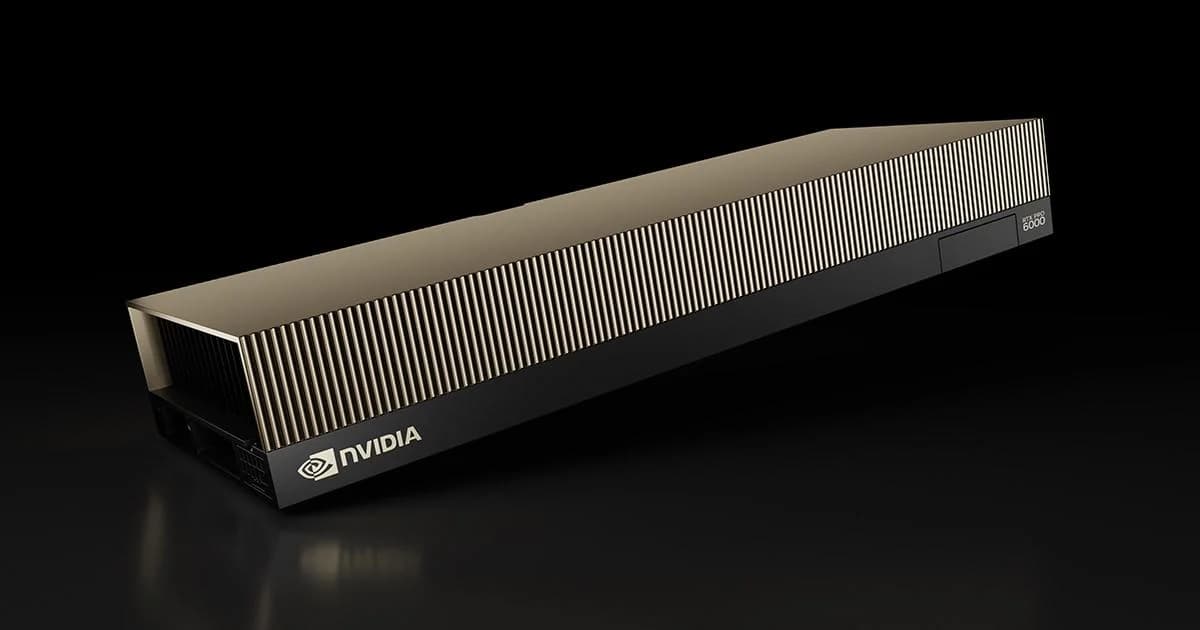
Contohnya, AI Server Workstation pada Dell Precision 7875 menggunakan pendekatan pakej NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, memori 96 GB GDDR7 ECC dan kuasa GPU 300 W mengikut model yang Dell nyatakan disokong. Harga permulaan lebih kurang 700,000 THB. Anda perlu mengesahkan CPU, RAM, SSD, PSU dan skop perkhidmatan dalam sebut harga. Ini bukan RTX 6000 Ada atau model Workstation 600 W [2][3]
Membeli kad sahaja mungkin belum selesai
Sebelum memesan GPU, periksa panjang, ketebalan, bilangan slot yang terlindung, penyambung kuasa, pengaliran udara, BIOS, sistem pengendalian dan driver, termasuk syarat jaminan bagi keseluruhan mesin. Kad yang boleh dimasukkan ke dalam slot tidak bermakna sistem menyokongnya sepenuhnya.
Mula memilih GPU daripada memori, kemudian lihat kelajuan
VRAM umpama meja kerja GPU: ia perlu cukup untuk meletakkan model, data sementara dan kerja yang sedang dilakukan. Manakala bandwidth ialah kelajuan mengambil data di atas meja itu. Kapasiti membantu supaya kerja boleh dimuatkan, tetapi ia bukan angka kelajuan. Perbandingan GPU perlu menggunakan model, precision dan perisian yang sama; jangan bandingkan nilai AI TOPS yang berbeza precision atau berbeza syarat sparsity.
Contoh keluarga GPU untuk membaca spesifikasi, bukan kedudukan kelajuan
| Keluarga/model contoh | Memori mengikut model | Digunakan untuk menimbangkan perkara apa |
|---|---|---|
| GeForce RTX 5060 Ti | Ada model 8 GB dan 16 GB | Pilih SKU yang betul; walaupun nama model hampir sama, kapasitinya mungkin berbeza |
| GeForce RTX 4090 / RTX 5090 | 24 GB / 32 GB | Kad tunggal untuk kerja pembangunan, imej dan LLM yang diukur bahawa ia boleh dimuatkan; periksa kuasa dan saiz kad |
| RTX 6000 Ada | 48 GB ECC | Kad profesional ini model yang berbeza daripada RTX PRO 6000 Blackwell |
| RTX PRO 5000 Blackwell | Ada model 48 GB dan 72 GB ECC | Baca nama sub-model dan datasheet; jangan anggap secara pukal bahawa setiap kad mempunyai kapasiti yang sama |
| RTX PRO 6000 Blackwell | 96 GB ECC | Workstation, Max-Q dan Server Edition mempunyai keperluan kuasa/penyejukan yang berbeza |
| GPU pusat data, contohnya H100 / H200 | H100 ada model 80 GB; H200 141 GB | Pilih keseluruhan sistem dan form factor; NVLink/rangkaian/pengeluar mesin memberi kesan kepada pengembangan |
Contoh spesifikasi yang diperiksa pada 14 November 2569 (kalendar Buddha), bukan senarai barangan sedia dihantar atau jaminan prestasi [3][4][5][6][7][8][20][23]
Berapa banyak VRAM, dan jenis kerja apa yang boleh dimulakan
Panduan untuk mula mencuba; anda perlu memeriksa model card dan benchmark sebelum membeli
| Julat VRAM per GPU | Contoh kerja yang dibawa untuk diuji | Perkara yang perlu diberi perhatian |
|---|---|---|
| 8–12 GB | Mempelajari AI, inference model imej bersaiz kecil, LLM bersaiz kecil secara quantized | context, resolusi imej dan batch mempunyai ruang yang terhad |
| 16–24 GB | Mencuba LLM 7B–8B secara quantized, kerja penghasilan imej bagi sebahagian pipeline, LoRA bagi sebahagian model | LoRA tidak menjadikan semua model boleh dimuatkan; model dan tetapannya memberi kesan yang besar |
| 32–48 GB | Menguji LLM 14B–32B secara quantized atau menambah ruang untuk kerja imej/latihan tambahan | Berat model yang boleh dimuatkan masih perlu menyisihkan ruang untuk KV cache dan runtime |
| 72–96 GB | Menguji LLM 70B secara quantized atau kerja yang memerlukan ruang lebih banyak | Bilangan pengguna dan kelajuan tindak balas masih perlu diukur; context yang panjang menambah penggunaan memori |
| Berbilang GPU / GPU pusat data | Model yang tidak mencukupi dengan satu kad sahaja, kerja training atau beberapa set perkhidmatan | Perisian mesti menyokong pembahagian kerja dan topology mesti sesuai |
Ini merupakan titik permulaan untuk membuat percubaan, bukan spesifikasi minimum yang dijamin. Model yang namanya hampir sama mungkin menggunakan memori yang berbeza, dan offload ke RAM ditukar ganti dengan masa penghantaran dan penerimaan data [10][11][12]
Mengira ruang model LLM dengan cara yang mudah difahami
B bermaksud bilangan parameter dalam unit bilion. Berat model sahaja boleh dianggarkan daripada bilangan parameter × bilangan bit setiap parameter ÷ 8. Contohnya, 8B pada BF16/FP16 menggunakan 8 × 2 = 16 GB, manakala pada 4-bit ia menggunakan kira-kira 8 × 0.5 = 4 GB. Jadual ini menggunakan GB asas sepuluh, dan belum termasuk metadata quantization, KV cache, activation, runtime serta ruang untuk sistem [10][11]
Berat model sahaja: dikira untuk merancang bajet memori
| Model contoh | BF16/FP16: 2 bytes | 8-bit: 1 byte | 4-bit: 0.5 byte |
|---|---|---|---|
| 8B | 16 GB | 8 GB | 4 GB |
| 14B | 28 GB | 14 GB | 7 GB |
| 32B | 64 GB | 32 GB | 16 GB |
| 70B | 140 GB | 70 GB | 35 GB |
Angka-angka ini adalah pengiraan bersifat penerangan, bukan VRAM minimum yang sedia untuk digunakan, dan bukan hasil benchmark bagi model tertentu
Oleh itu, model 70B jenis 4-bit yang beratnya dikira sebagai 35 GB tidak bermakna GPU 40 GB boleh terus memberikan perkhidmatan kepada banyak orang serta-merta. Perlu ada ruang yang tinggal untuk konteks soalan dan jawapan bagi setiap kerja, termasuk juga operasi inference engine. Pengurangan bit membantu mengurangkan ruang, tetapi kualiti jawapan dan kelajuan juga perlu diuji; jangan pilih berdasarkan kapasiti sahaja
Menggunakan model, melatih tambahan, dan melatih semula memerlukan mesin yang tidak sama
Asingkan jenis kerja sebelum memilih spesifikasi
| Pekerjaan | Apa yang berlaku | Perkara yang perlu disediakan lebihan |
|---|---|---|
| Inference | Memuatkan berat kemudian membuat ramalan atau menjawab soalan | Berat + cache + activation + runtime |
| LoRA / QLoRA | Melatih sebahagian parameter tambahan; QLoRA menggunakan berat utama jenis quantized | Masih perlu ada base model, activation dan optimizer bagi bahagian yang dilatih |
| Full fine-tuning | Mengemas kini parameter utama model | gradients, optimizer states, salinan berat dan activation menggunakan ruang tambahan |
| Training from scratch | Mempelajari berat baharu daripada set data | Data berkualiti tinggi, masa compute, sistem checkpoint dan percubaan beberapa pusingan |
Tiada satu pengganda VRAM tunggal yang boleh digunakan untuk setiap framework, optimizer, precision, sequence length atau pembahagian model [12][13]
Bagi kerja imej, kerja pemeriksaan komponen/pengelasan imej perlu diasingkan daripada kerja penghasilan imej dengan diffusion dan kerja penghasilan video. Menambah resolusi, batch atau bilangan frame menyebabkan ruang dan masa pemprosesan meningkat. Oleh itu, penghasilan imej dengan batch yang kecil dan melatih model imej menggunakan spesifikasi pada tahap yang berbeza. Teknik mengurangkan memori seperti offload, tiling atau checkpointing mungkin membantu dengan pertukaran pada kelajuan; perlu merujuk manual pipeline yang digunakan secara sebenar [14]
Berapa banyak RAM utama yang sepatutnya ada
RAM mesin adalah berasingan daripada VRAM pada kad, kecuali platform memori berkongsi seperti DGX Spark. Tugas RAM ialah menyokong sistem pengoperasian, program menyediakan data, database/cache dan data semasa memuatkan model. Mempunyai RAM yang banyak tidak menyebabkan VRAM bertambah secara automatik, dan memindahkan sebahagian model ke RAM mungkin terbatas oleh bandwidth antara CPU/GPU
- Buat akaun memori: sistem dan perkhidmatan asas + data loader/imej yang sedang disediakan + database/cache + tempoh memuatkan model atau offload + kerja lain yang berjalan serentak + ruang simpanan sandaran
- Contoh andaian: sistem 16 GB + penyediaan data 24 GB + cache/database 16 GB + tempoh memuatkan/sandaran kerja 32 GB = 88 GB, maka pertimbangkan kapasiti yang lebih daripada ini, contohnya 128 GB, kemudian ukur peak yang sebenar. Ini bukan peraturan bahawa setiap mesin mesti 128 GB
- Jika menjalankan beberapa perkhidmatan atau memuatkan dataset besar secara serentak, mungkin perlu mempertimbangkan 256 GB atau lebih, tetapi perlu difikirkan berdasarkan senarai penggunaan sebenar, bukan menggunakan formula RAM = VRAM × 2 tanpa melihat kerja
- Periksa versi DDR yang disokong, ECC UDIMM/RDIMM, bilangan slot memori dan cara memasang DIMM mengikut manual. Memasang beberapa bilah RAM pada slot yang salah mungkin tidak memberikan bandwidth seperti yang dijangkakan
Kapasiti dan bilangan slot memori adalah dua perkara yang berbeza
RAM dengan jumlah kapasiti yang sama boleh memberikan lebar jalur berbeza apabila sebahagian saluran memori kosong berbanding pemasangan yang diagihkan mengikut saluran. Semak panduan pemasangan CPU dan papan induk, jenis DIMM, bilangan modul serta kelajuan yang disokong oleh konfigurasi sebenar.
ECC ialah mekanisme yang mengesan dan membetulkan beberapa jenis ralat memori, bukan jaminan bahawa data tidak akan rosak selama-lamanya. UDIMM dan RDIMM ialah jenis memori yang berbeza; anda perlu memilih berdasarkan platform, bukan hanya berdasarkan kapasiti dan versi DDR yang sama sahaja.
Pipeline: data melalui apa sahaja
Bandwidth ialah jumlah data yang boleh dihantar setiap detik, manakala latency ialah masa menunggu bagi setiap tugasan. Kedua-duanya penting. Walaupun jalannya lebar, jika ada langkah menunggu di setiap titik, jawapan masih boleh menjadi lambat. Bagi tugasan LLM, fasa membaca prompt yang panjang dan fasa menghasilkan jawapan satu token demi satu token mempunyai kelakuan yang berbeza, jadi prefill dan decode wajar diukur secara berasingan [11]
Baca unit dengan betul sebelum membandingkan sistem
| Laluan penyambung | Contoh siling teori | Soalan yang perlu ditanya |
|---|---|---|
| PCIe 4.0 ×16 | Kira-kira 31.5 GB/s setiap arah | Dipasang pada slot ×16, tetapi berapa lane yang benar-benar bersambung secara elektrik? |
| PCIe 5.0 ×16 | Kira-kira 63 GB/s setiap arah | Adakah CPU, papan induk dan peranti menyokong versi yang sama? |
| Ethernet 10 / 25 / 100 Gbps | Kira-kira 1.25 / 3.125 / 12.5 GB/s sebelum overhead | Adakah switch, kabel, NIC dan Storage di hujung sana cukup pantas? |
| GPU memory bandwidth | Baca daripada datasheet GPU tersebut | Ini ialah kelajuan dalaman memori, bukan PCIe atau kelajuan rangkaian |
GB/s ialah bait, manakala Gbps ialah bit; 8 bits = 1 byte. Angka PCIe adalah selepas mengambil kira pengekodan pautan, tetapi belum menolak protocol overhead dan bukan kelajuan penggunaan sebenar [16]
Contoh hipotetikal: jika set data yang sedia untuk digunakan bersaiz 100 GB dan laluan penyambung 10 Gbps memberikan siling 1.25 GB/s, masa penghantaran sahaja yang paling rendah secara teori ialah 100 ÷ 1.25 = 80 detik. Pada hakikatnya ia lebih lambat daripada ini kerana overhead, fail-fail kecil, CPU dan cakera; jadi anda tidak sepatutnya membeli NIC yang lebih pantas tanpa memeriksa sama ada titik-titik lain dapat mengikutinya atau tidak.
CPU dan papan induk: lihat lane, bukan hanya slot
CPU membantu membaca fail, menyahkod imej, men-tokenize teks, mengatur batch dan menjaga perkhidmatan lain. Bilangan core yang banyak membantu sebahagian tugasan, tetapi perisian perlu mampu menggunakan core tersebut. Papan induk perlu mempunyai kedua-duanya: slot yang benar-benar kosong dan lane PCIe yang dihantar oleh CPU/chipset — bukan melihat slot panjang ×16 lalu menganggap setiap slot itu mendapat ×16.
- Baca block diagram: slot mana yang bersambung terus ke CPU, slot mana yang melalui chipset, dan peranti mana yang berkongsi lane dengan M.2/NIC
- Contoh perancangan: 4 keping GPU ×16 = 64 lane; 2 unit NVMe ×4 = 8 lane; NIC ×8 = 8 lane, berjumlah 80 lane menurut anggapan ini. Anda perlu memeriksa laluan lane yang sebenar, termasuk peranti yang datang terpasang pada papan induk
- Periksa saiz dan jarak antara kad: kad yang memakan 3 slot mungkin menghalang slot lain, walaupun jumlah lane keseluruhan mencukupi
- PCIe bifurcation dan riser perlu disokong oleh CPU, BIOS, papan induk dan peranti — bukan sekadar membeli kabel pemisah lalu setiap mesin boleh menggunakannya
Tidak semestinya perlu ada 2 CPU untuk menggunakan 4 GPU. Sebagai contoh, Threadripper PRO pada platform WRX90 menyokong sehingga 128 PCIe 5.0 lanes dan memori 8 channels dalam sistem soket tunggal, tetapi bilangan kad yang benar-benar boleh dipasang masih bergantung pada papan induk, kes (casing), kuasa dan pengesahan pengilang [17] Dell Precision 7875 mempunyai susun atur slotnya yang tersendiri; anda tidak sepatutnya membuat kesimpulan bahawa kerana CPU mempunyai banyak lane maka model mesin ini akan menyokong empat keping GPU [22]
Apa yang dibantu oleh dua CPU, dan apakah itu NUMA
Mesin dua soket mungkin menambah bilangan core, kapasiti RAM dan sumber I/O bergantung pada platform, tetapi ini bukan bermakna semua bandwidth boleh dicampur lalu setiap tugasan menjadi dua kali lebih pantas. Setiap CPU mempunyai memori dan peranti yang berada dekat dengannya; akses ke sebelah CPU yang satu lagi perlu melalui pautan antara soket. Konsep ini dipanggil NUMA [15]
CPU A
- RAM sebelah AMemori yang diakses terus oleh CPU A
- GPU 0 dan GPU 1Contoh GPU yang bersambung dengan PCIe root A
CPU B
- RAM sebelah BMemori yang diakses terus oleh CPU B
- GPU 2 dan GPU 3Contoh GPU yang bersambung dengan PCIe root B
Pautan antara CPU: boleh melintas ke sebelah sana, tetapi ada kos masa dan bandwidth
Anda perlu membaca topology mesin yang sebenar. Sebahagian sistem mempunyai PCIe switch dan laluan lane yang berbeza daripada contoh ini. Anda wajar mengikat tugasan dan memori supaya dekat dengan GPU yang digunakan, menurut kesesuaian.
Dua CPU sesuai apabila beban CPU, RAM atau I/O benar-benar memerlukan sumber tambahan, dan sistem pengendalian serta perisian dapat mengatur tugasan dengan sesuai. Jika tugasan kebanyakannya menunggu GPU dan tidak menggunakan banyak kad, sistem CPU tunggal yang mempunyai lane yang mencukupi mungkin lebih mudah diuruskan. Periksa topology dengan alat sistem dan benchmark sebelum membuat keputusan.
Bagaimana cara menggunakan berbilang GPU — bukan sekadar pasang lalu VRAM terus bergabung
Tiga cara menggunakan beberapa unit GPU
| Cara | Gambaran keseluruhan | Perkara yang perlu ditukar ganti |
|---|---|---|
| Pisahkan tugas / buat salinan perkhidmatan | Setiap GPU menjalankan model yang muat pada dirinya sendiri, kemudian permintaan diagihkan | Menambah keupayaan menerima kerja secara keseluruhan, tetapi satu set model masih perlu muat pada setiap unit |
| Data parallel training | Setiap GPU berlatih dengan batch data yang berbeza, kemudian bertukar gradients | Perlu komunikasi antara GPU dan penetapan batch/optimizer yang sesuai |
| Tensor / pipeline parallel | Membahagikan model atau kerja di dalam satu model merentas GPU | Membantu dalam kes satu unit sahaja tidak mencukupi, tetapi menambah komunikasi dan bergantung pada engine |
Dua unit GPU 24 GB tidak secara automatik menjadi satu unit GPU 48 GB; model sharding dan had setiap unit masih perlu diperiksa [18][19]
Periksa sama ada kad itu menyokong NVLink atau tidak, jangan membuat anggapan daripada nama RTX atau harga. Jika menggunakan PCIe, perlu melihat laluan antara GPU dan sokongan peer-to-peer bagi keseluruhan sistem. Bagi persekitaran berbilang mesin, rangkaian menjadi sebahagian daripada pengiraan; perlu melihat NIC, switch, RDMA mengikut perisian, dan penempatan GPU/NIC. Bukan sekadar mempunyai port 100 Gbps lalu terjamin akan scale dengan baik [18]
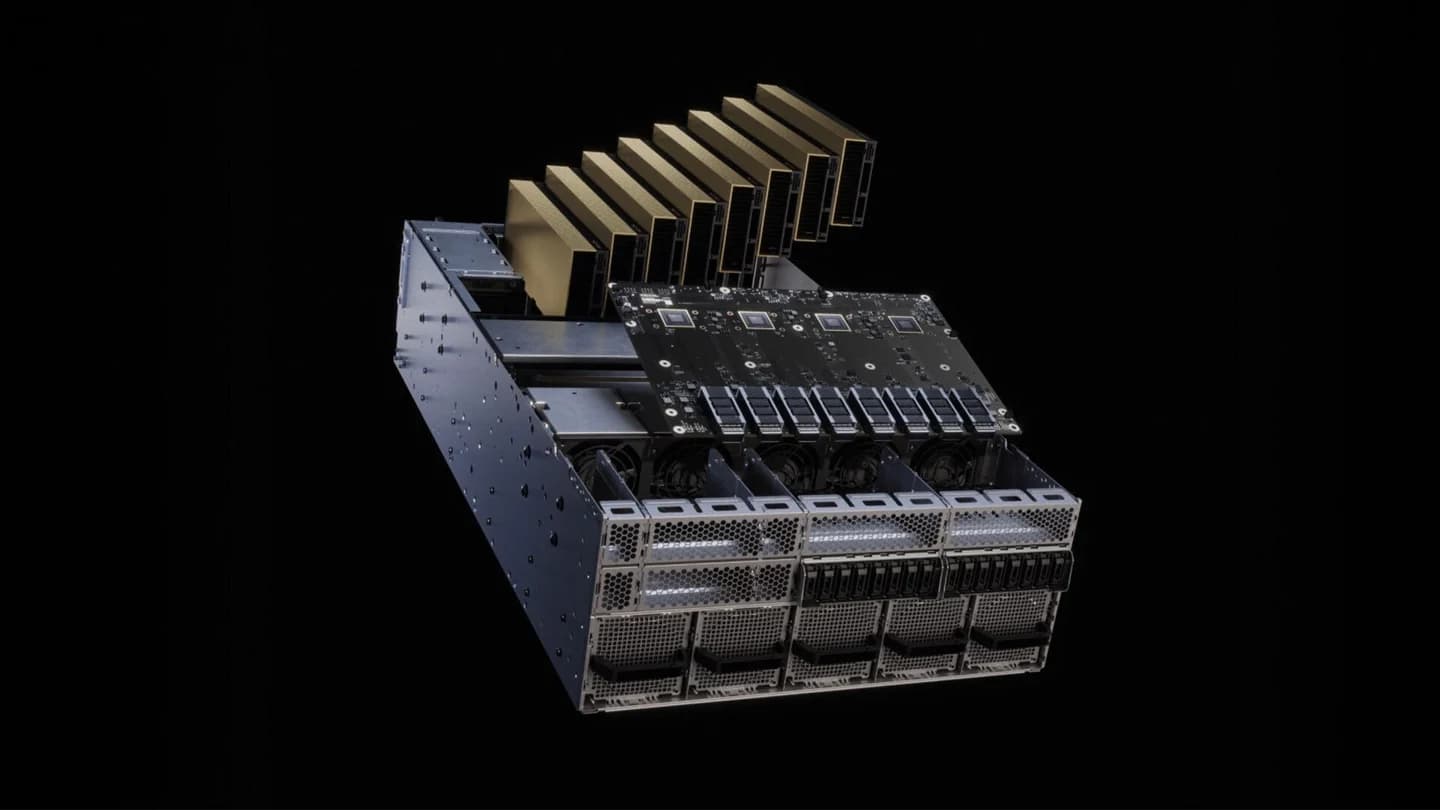
NVLink ialah sambungan berkelajuan tinggi antara GPU dalam sistem yang menyokongnya, manakala RDMA membolehkan mesin yang menyokongnya menghantar dan menerima data melalui rangkaian dengan mengurangkan sebahagian kerja penyalinan oleh CPU. Kedua-duanya memerlukan sokongan pada perkakasan dan juga perisian; ia bukan ciri yang ada pada setiap GPU atau setiap port rangkaian [18]
Menyokong berapa ramai pengguna — apa yang perlu dilihat?
Bezakan “orang yang mempunyai akaun” daripada “permintaan yang sedang diproses”. Contohnya, sebuah organisasi mungkin mempunyai banyak akaun, tetapi orang yang bertanya pada masa yang sama mungkin sedikit; atau penggunanya sedikit tetapi setiap kali menghantar dokumen yang panjang, maka mungkin menggunakan lebih banyak sumber. Bagi LLM, lihat saiz model, precision, panjang input/output, bilangan permintaan serentak, KV cache dan mekanisme batching [11]
- TTFT: masa dari penghantaran soalan sehingga mendapat token pertama, termasuk masa menunggu dalam baris gilir
- Kelajuan jawapan: tokens/s bagi setiap permintaan, dan masa keseluruhan sehingga jawapan selesai — bukan hanya melihat jumlah keseluruhan mesin
- Throughput: jumlah kerja atau token sesaat di bawah beban ujian yang ditetapkan
- P95 latency: nilai tempoh masa di mana 95 daripada 100 permintaan selesai tidak lebih lambat daripada nilai ini; digunakan untuk melihat gejala perlahan ketika ada ramai orang serentak [21]
- Ralat dan kualiti: out-of-memory, timeout, jawapan yang tidak menepati soalan, dan pemisahan kebenaran akses dokumen
Contoh hipotetikal untuk pengiraan: jika diukur 120 output tokens/s secara keseluruhan pada satu beban ujian, dan dikehendaki purata 20 output tokens/s bagi setiap permintaan, maka pembahagian 120 ÷ 20 = 6 hanya digunakan sebagai titik permulaan untuk mencuba kira-kira 6 kerja permintaan serentak. Ini bukan jaminan bahawa ia menyokong 6 orang, kerana prefill, KV cache, batching dan panjang jawapan membuatkan hasilnya berubah. Perlu menguji concurrency pada beberapa tahap dengan prompt sebenar dan kriteria masa menunggu yang telah dipersetujui
Keputusan ujian yang patut diminta bersama sebut harga
Nyatakan nama dan versi model, quantization/context, contoh soalan, panjang jawapan, concurrent requests, TTFT, P95, throughput dan peak memory, berserta versi perisian, supaya mesin boleh dibandingkan dengan kerja yang sama — bukan menggunakan bilangan pengguna tanpa syarat yang menyertainya
Power Supply, panas dan ruang pemasangan
Buat kiraan kuasa bagi keseluruhan sistem: GPU + CPU + RAM + SSD/NIC + papan induk dan kipas, kemudian sediakan margin untuk perubahan beban secara mendadak dan keperluan pengeluar. Angka TDP atau GPU power bukanlah nilai yang diukur di soket kuasa bagi keseluruhan mesin; kecekapan PSU dan jenis beban kerja mempengaruhi kuasa sebenar
Contoh hipotetikal, bukan spesifikasi binaan siap atau spesifikasi Dell 7875: 4 unit GPU × 300 W = 1,200 W; CPU 350 W; RAM/Storage/papan/kipas dianggap berjumlah 200 W, menjadikan beban di sebelah peranti 1,750 W sebelum margin. Perlu memeriksa PSU, penyambung, kabel kuasa dan kuasa yang benar-benar disokong. Tidak sepatutnya membeli PSU 1,750 W terus daripada hasil tambah ini. Empat unit kad 600 W memberikan jumlah GPU sahaja sebanyak 2,400 W, jadi itu soalan yang berbeza sama sekali daripada mesin dengan satu kad
- Periksa penyambung dan kabel yang ditetapkan oleh pengeluar; jangan guna kabel penukar atau pencabang pelbagai tanpa pengesahan
- PSU berlebihan (redundan) perlu dilihat mod redundancy-nya: dua unit tidak bermakna kuasa gabungan boleh digunakan sepenuhnya sambil masih perlu tahan jika satu unit PSU rosak
- Kad passive cooling memerlukan airflow chassis mengikut spesifikasi; jangan dipasang dalam casing biasa lalu mengharapkan kipas PSU
- Periksa soket, sirkit kuasa, UPS — termasuk unit W/VA dan masa sandaran — serta panas, bunyi dan ruang servis mesin bersama pihak pengurusan bangunan
Kos elektrik dikira daripada kuasa purata yang diukur: contoh hipotetikal 1 kW × 8 jam × 30 hari = 240 kWh, kemudian dikalikan dengan kadar elektrik sebenar. Ini belum termasuk sistem penyejukan, jadi eloklah mengukur kedua-dua keadaan idle dan beban kerja yang digunakan secara rutin sebelum membandingkan kos membeli atau menyewa
Storage menyimpan apa, dan perlu secepat mana?
Asingkan data sebelum memilih SSD dan sistem sandaran
| Apa yang disimpan | Ciri penggunaan | Apa yang sesuai dipilih |
|---|---|---|
| Sistem dan program | OS, containers, libraries | Ruang untuk kemas kini dan pemulihan; asingkan daripada data penting apabila sesuai |
| Model dan checkpoint | Fail besar daripada beberapa versi, dimuatkan semasa permulaan atau disimpan semasa latihan | Kapasiti, kadar baca/tulis berterusan, dan ruang untuk versi yang boleh dikembalikan semula |
| Dataset imej/video/dokumen | Fail besar atau banyak fail kecil | Lihat kedua-dua throughput dan IOPS, termasuk pola data-loader |
| Pangkalan data/vector index/log | Bacaan dan tulisan kecil, dan mungkin mengandungi data sensitif | latency, endurance, hak akses, dan polisi penyimpanan |
| Backup | Salinan yang berasingan daripada mesin utama | Versi, penyulitan, ujian pemulihan, dan hak pengguna yang mengakses |
RAID membantu dalam beberapa kes cakera rosak, tetapi tidak menggantikan backup untuk pemadaman tersilap, ransomware, atau kerosakan seluruh mesin
Contoh hipotetikal: dataset 500 GB + model/checkpoint 400 GB + cache 200 GB + sistem dan log 100 GB = 1,200 GB sebelum menyediakan ruang untuk pertumbuhan, jadi anda perlu memilih kapasiti kegunaan sebenar yang lebih daripada ini dan mengira backup secara berasingan juga. Jangan kelirukan kapasiti mentah dengan usable capacity selepas RAID/format, dan jangan gunakan hanya satu nilai kelajuan sequential maksimum untuk menilai kerja fail kecil
Susun spesifikasi permulaan, kemudian uji sebelum membuat pesanan
Draf untuk mula berbincang dengan pentadbir sistem, bukan satu set jaminan prestasi
| Situasi | Pendekatan permulaan | Syarat sebelum membuat pesanan |
|---|---|---|
| Belajar atau membangunkan AI di atas meja | DGX Spark atau PC yang mempunyai GPU 16–24 GB bergantung pada perisian | Periksa Arm64/x86, model, dan kelajuan yang boleh diterima |
| Pasukan yang membuat imej dan LLM dalam organisasi | Workstation GPU 32–96 GB; kira RAM/SSD daripada senarai data | Uji pipeline sebenar dan penggunaan bersama perkhidmatan lain |
| Beberapa pasukan / model besar / kerja latihan berterusan | Sistem berbilang GPU atau berbilang nod yang disahkan oleh pengeluar | Lihat topology, network, power/cooling, penyelenggaraan, dan benchmark keseluruhan sistem |
Saiz VRAM bukan jaminan kesesuaian; anda perlu bermula daripada versi model dan kriteria penerimaan anda sendiri
- 1
Tulis keperluan dan kriteria penerimaan kerja
Nyatakan model, kerja sebenar, pengguna serentak, masa menunggu yang boleh diterima, dan keperluan data
- 2
Buat bajet memori
Asingkan berat model, cache activation, dan RAM untuk kerja sekeliling, kemudian ukur peak dalam ujian
- 3
Lakarkan laluan data
Ikuti Storage → CPU/RAM → PCIe → GPU, termasuk rangkaian dan pangkalan data, dan periksa kesesakan satu demi satu
- 4
Periksa keseluruhan set mesin
Baca manual CPU, papan induk, DIMM, slot, PSU, penyambung, sistem aliran udara, dan senarai yang disokong oleh pengeluar
- 5
Uji dahulu, kemudian baru muktamadkan sebut harga
Gunakan set data dan concurrency sebenar, rekodkan kualiti, masa tindak balas, kuasa, dan memori, bersama rancangan pengembangan dan skop penyelenggaraan
Jika anda ingin membuat penilaian bersama pasukan Inspektion, sediakan nama model atau jenis kerja, contoh data, jumlah permintaan serentak, masa menunggu yang boleh diterima, dan kekangan lokasi, kemudian lihat DGX Spark, Dell AI Workstation atau gambaran keseluruhan Modern Data untuk memilih titik permulaan yang sesuai dengan sistem anda. Untuk kerja carian dokumen, bacaan lanjut ada di Enterprise KM Chatbot
Soalan Sering Ditanya
DGX Spark atau Workstation, yang mana sesuai untuk pemula
Lihat tugas dan perisian yang perlu digunakan. DGX Spark sesuai untuk pembangunan dan eksperimen AI dalam mesin kecil yang mempunyai memori kongsi yang banyak, tetapi perlu memeriksa Arm64. Bagi Workstation, anda boleh memilih GPU dan komponen mengikut platform. Kedua-dua jenis perlu diuji dengan model sebenar sebelum menetapkan jumlah pengguna
Bolehkah dua GPU 24 GB digunakan sebagai ganti satu GPU 48 GB
Tidak secara automatik. Anda perlu menggunakan perisian yang boleh membahagikan model atau tugas merentas GPU, dan memeriksa memori setiap kad serta laluan komunikasi. Cara lain ialah membiarkan setiap GPU menjalankan set perkhidmatan yang berasingan untuk menerima jumlah kerja yang lebih banyak
Adakah menambah RAM membantu LLM yang lebih besar daripada VRAM dapat dijalankan
Sebahagian engine menyokong offload ke RAM, tetapi ada kos pemindahan data dan mungkin menjadi lebih lambat untuk membalas. Perlu memeriksa sokongan dan mengukur secara sebenar. RAM yang banyak tidak menjadikan GPU memory bertambah, kecuali sistem memori kongsi yang perlu dipertimbangkan secara berbeza
Adakah perlu ada dua CPU barulah boleh memasang empat GPU
Tidak semestinya. Sebahagian model platform CPU tunggal mempunyai lane PCIe yang mencukupi. Perlu memeriksa papan induk, kelebaran slot, kad yang disokong, sistem kuasa dan haba. Bagi mesin dua CPU, perlu juga melihat NUMA dan kedudukan GPU/RAM
Harga permulaan 300,000 dan 700,000 THB merangkumi apa sahaja
Ini ialah harga anggaran permulaan bagi tawaran DGX Spark dan Dell AI Workstation masing-masing. Senarai perkakasan, perisian, pemasangan, cukai, jaminan dan penghantaran disahkan dalam sebut harga. Ini bukan harga tetap atau jaminan jumlah pengguna
Rujukan
- [1]
DGX Spark: specifications and workloads — NVIDIA (diakses 2026-11-14)
- [2]
Precision 7875 Tower: graphics options — Dell (diakses 2026-11-14)
- [3]
RTX PRO 6000 Blackwell Max-Q Workstation Edition — NVIDIA (diakses 2026-11-14)
- [4]
GeForce RTX 5060 family — NVIDIA (diakses 2026-11-14)
- [5]
GeForce RTX 5090 — NVIDIA (diakses 2026-11-14)
- [6]
RTX 6000 Ada Generation — NVIDIA (diakses 2026-11-14)
- [7]
RTX PRO 5000 Blackwell — NVIDIA (diakses 2026-11-14)
- [8]
H200 Tensor Core GPU — NVIDIA (diakses 2026-11-14)
- [9]
RTX PRO 6000 Blackwell Server Edition — NVIDIA (diakses 2026-11-14)
- [10]
Quantization with bitsandbytes — Hugging Face (diakses 2026-11-14)
- [11]
Optimization and Tuning — vLLM (diakses 2026-11-14)
- [12]
Memory anatomy of model training — Hugging Face (diakses 2026-11-14)
- [13]
Parameter-efficient fine-tuning: quantization — Hugging Face (diakses 2026-11-14)
- [14]
Reduce memory usage for diffusion pipelines — Hugging Face (diakses 2026-11-14)
- [15]
Performance Tuning Guide: data loading and NUMA — PyTorch (diakses 2026-11-14)
- [16]
PCIe bandwidth per direction after encoding overhead — PCI-SIG (diakses 2026-11-14)
- [17]
AMD Ryzen Threadripper PRO processors — AMD (diakses 2026-11-14)
- [18]
Distributed serving — vLLM (diakses 2026-11-14)
- [19]
DistributedDataParallel — PyTorch (diakses 2026-11-14)
- [20]
GeForce RTX 4090 specifications — NVIDIA (diakses 2026-11-14)
- [21]
LLM Benchmarking: Fundamental Concepts — NVIDIA (diakses 2026-11-14)
- [22]
Precision 7875 Tower: internal slots — Dell (diakses 2026-11-14)
- [23]
HGX GPU memory and platform specifications — NVIDIA (diakses 2026-11-14)