เลือก AI Server ให้เหมาะกับงาน: ตั้งแต่เครื่องเล็กถึงหลาย GPU
ทีมวิศวกร Inspektion · เผยแพร่ 14 พฤศจิกายน 2569 · อัปเดตล่าสุด 14 พฤศจิกายน 2569
คู่มือเลือก AI Server ขนาดเล็กถึงใหญ่ เทียบ DGX Spark กับ Workstation อธิบาย GPU, VRAM, RAM, CPU, PCIe, Storage และไฟ พร้อมวิธีประเมินผู้ใช้พร้อมกัน
สรุปสั้น
- เริ่มจากงานและโมเดล แล้วคำนวณหน่วยความจำก่อนเลือก GPU ไม่เริ่มจากราคาเครื่องอย่างเดียว
- 128 GB unified memory ของ DGX Spark ไม่ใช่ VRAM การ์ดแยก และเพิ่ม GPU แบบ PC ไม่ได้
- GPU หลายใบต้องมีซอฟต์แวร์และ topology ที่รองรับ ไม่ได้รวม VRAM อัตโนมัติ
- จำนวนผู้ใช้ต้องวัดจากคำขอพร้อมกัน context และเวลาตอบ ไม่กำหนดจากขนาด GPU เพียงค่าเดียว
- ตรวจ RAM, Storage, PCIe, network, ไฟ และความร้อนทั้งระบบ พร้อมทดสอบก่อนสั่งซื้อ
เริ่มจากงาน ไม่ใช่ชื่อการ์ดจอ
การเลือก AI Server คล้ายประกอบคอม แต่ต้องดูทั้งขนาดโมเดล ความเร็วส่งข้อมูล และจำนวนงานที่เกิดพร้อมกัน เครื่องที่โหลดโมเดลได้อาจยังตอบไม่ทันผู้ใช้ และการเพิ่ม GPU จะไม่ช่วยมากหากข้อมูลติดอยู่ที่ Storage, CPU หรือเครือข่าย บทความนี้แบ่งเครื่องเล็ก กลาง และใหญ่ตามรูปแบบใช้งาน ไม่ใช่มาตรฐานขนาดของผู้ผลิต
- ระบุงาน: ใช้โมเดลที่มีแล้ว ฝึกเพิ่มจากโมเดลเดิม หรือฝึกโมเดลใหม่ตั้งแต่ต้น
- ระบุข้อมูล: ข้อความ ภาพ วิดีโอ หรือหลายชนิด รวมความยาวคำถาม ความละเอียดภาพ และจำนวนไฟล์
- ระบุเวลาที่รับได้: ต้องตอบทันที งานเข้าคิวได้ หรือประมวลผลเป็นรอบกลางคืน
- ระบุคนและงานพร้อมกัน: จำนวนบัญชีทั้งหมดไม่เท่ากับจำนวนคำขอที่เครื่องกำลังประมวลผล
คำศัพท์ที่ใช้ตลอดบทความ
Inference = ใช้โมเดลตอบหรือทำนาย, Training = ฝึกโมเดล, Fine-tuning = ฝึกเพิ่มจากโมเดลเดิม, VRAM = หน่วยความจำบน GPU, RAM = หน่วยความจำหลัก, Token = หน่วยข้อความที่โมเดลประมวลผล ซึ่งไม่เท่ากับจำนวนคำไทยแบบหนึ่งต่อหนึ่ง CPU คือหน่วยประมวลผลหลักที่จัดเตรียมข้อมูลและควบคุมงาน ส่วน GPU ถนัดคำนวณงานจำนวนมากพร้อมกัน Batch คือกลุ่มข้อมูลที่ประมวลผลร่วมกัน Context คือบริบทที่โมเดลใช้ตอบคำถาม และ Quantization คือการลดจำนวนบิตที่ใช้แทนน้ำหนักโมเดลเพื่อลดพื้นที่ โดยต้องตรวจคุณภาพผลลัพธ์อีกครั้ง
เครื่องเล็ก กลาง ใหญ่ ต่างกันตรงไหน
เลือกรูปแบบเครื่องให้ตรงวิธีใช้
| ขนาดในบทความนี้ | เหมาะกับจุดเริ่มต้น | ข้อดี | ข้อจำกัด |
|---|---|---|---|
| เล็ก: DGX Spark | พัฒนา ทดลองโมเดล และงาน AI ภายในที่ทดสอบขอบเขตแล้ว | เครื่องกะทัดรัด มีหน่วยความจำร่วมขนาดใหญ่และชุดซอฟต์แวร์ AI | เพิ่มการ์ด GPU แบบ PC ไม่ได้; ตรวจ Arm64 และความเร็วกับงานจริง |
| กลาง: PC / Workstation + GPU | งานภาพ LLM และการฝึกเพิ่มที่เลือก GPU ให้พอได้ | เลือกการ์ด RAM และ SSD ได้ตามแพลตฟอร์ม; ดูแลง่ายกว่าเครื่องหลายโหนด | สล็อต เลน PCIe ไฟ และความร้อนจำกัดจำนวนการ์ด |
| ใหญ่: GPU Server / หลายโหนด | งานหลายทีม โมเดลใหญ่ หรือฝึกและให้บริการที่ต้องขยาย | ออกแบบ GPU เครือข่าย ระบบไฟ และการดูแลระดับศูนย์ข้อมูลร่วมกัน | ต้องมีพื้นที่ ระบบระบายความร้อน และทีมดูแล; หลาย GPU ไม่ได้เร็วขึ้นตามจำนวนเสมอ |
ขนาดตัวเครื่อง ราคา หรือจำนวน GPU เพียงอย่างเดียวไม่ใช่ผลทดสอบความสามารถรองรับงาน
DGX Spark เกิดมาเพื่ออะไร
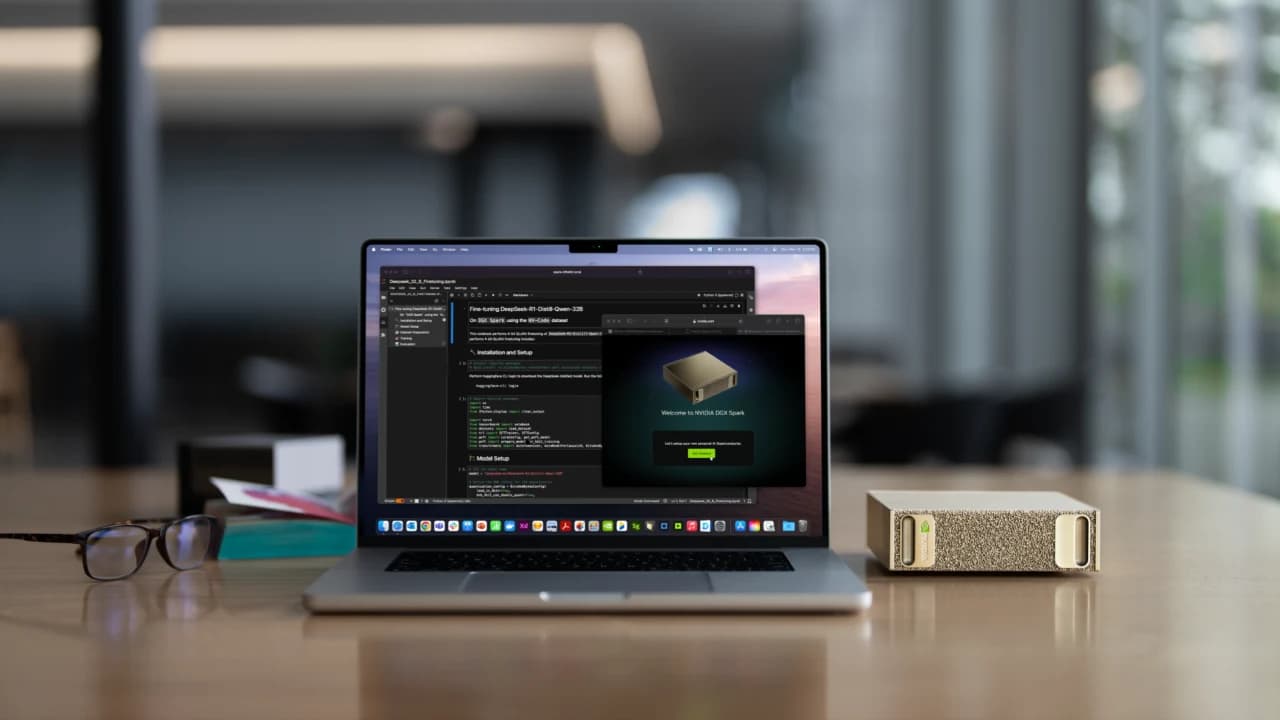
NVIDIA DGX Spark ใช้ GB10 Grace Blackwell Superchip พร้อม CPU แบบ Arm และหน่วยความจำร่วม 128 GB สำหรับ CPU/GPU จุดเด่นคือพัฒนา ทดลอง ปรับแต่ง และนำโมเดลมาใช้งานบนโต๊ะทำงานได้ โดยไม่ต้องเริ่มจากการประกอบเครื่องหลายการ์ด มีแบนด์วิดท์หน่วยความจำตามสเปก 273 GB/s จึงต้องดูทั้งความจุและความเร็ว ไม่ตีความว่า 128 GB เท่ากับการ์ด VRAM 128 GB [1]
- เหมาะกับการทดลอง LLM, ผู้ช่วยค้นเอกสาร, งานพัฒนา AI และการประเมินโมเดลในองค์กร ก่อนขยายไปเครื่องใหญ่
- หน่วยความจำร่วมทำให้ CPU/GPU ใช้พื้นที่เดียวกัน แต่ระบบปฏิบัติการและโปรแกรมอื่นก็ใช้พื้นที่นี้ด้วย ไม่ได้เหลือให้โมเดลครบ 128 GB
- ต้องตรวจว่า framework, container, library และส่วนเสริมรองรับ Arm64 และ GPU รุ่นนี้ ซอฟต์แวร์ x86 เดิมไม่ได้ย้ายมาใช้ได้ทุกตัว
- ไม่ได้เป็นคำตอบอัตโนมัติสำหรับผู้ใช้จำนวนมากหรือการฝึกโมเดลใหญ่จากศูนย์ ต้องวัดเวลาตอบและปริมาณงานจริง
ดู AI Server ขนาดเล็กบน NVIDIA DGX Spark ราคาเริ่มต้นโดยประมาณ 300,000 บาท เป็นงบตั้งต้นของข้อเสนอ Inspektion ไม่ใช่ราคาขายปลีกสากลของ NVIDIA รายการฮาร์ดแวร์ ซอฟต์แวร์ ติดตั้ง ภาษี การรับประกัน และกำหนดส่งมอบยืนยันตามใบเสนอราคา
PC และ Workstation: เลือก GPU ให้ตรงงาน
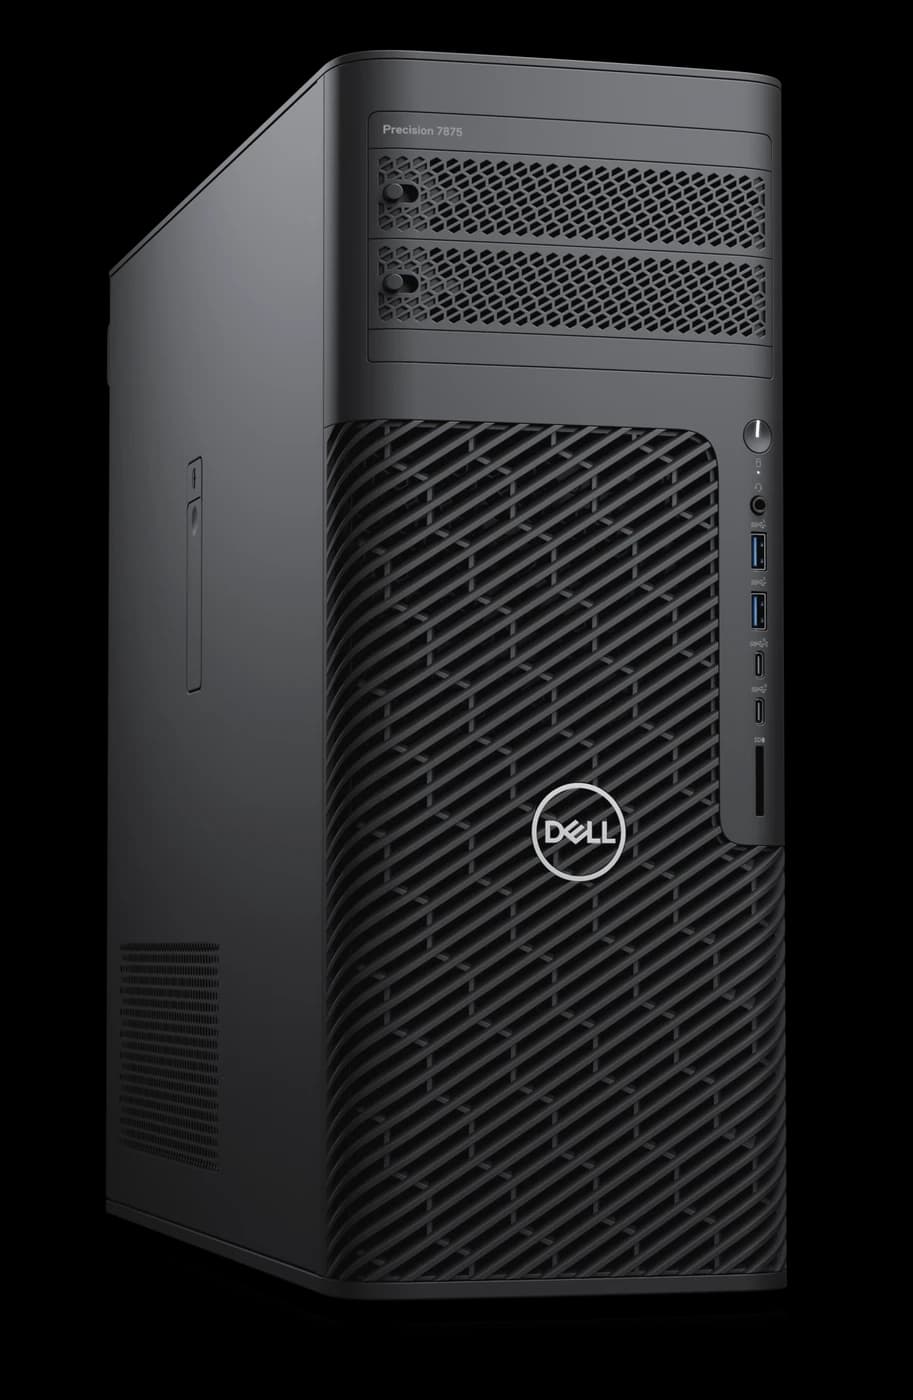
PC เหมาะเมื่อมีงบและข้อกำหนดที่ชัด Workstation เพิ่มทางเลือกด้านหน่วยความจำ ECC เลน PCIe และการรองรับฮาร์ดแวร์ตามรุ่น ความต่างที่ต้องตรวจคือเมนบอร์ด CPU เคส ระบบไฟ และรายการอุปกรณ์ที่ผู้ผลิตรับรอง ไม่ใช่มีคำว่า Workstation แล้วจะใส่การ์ดได้ทุกแบบ
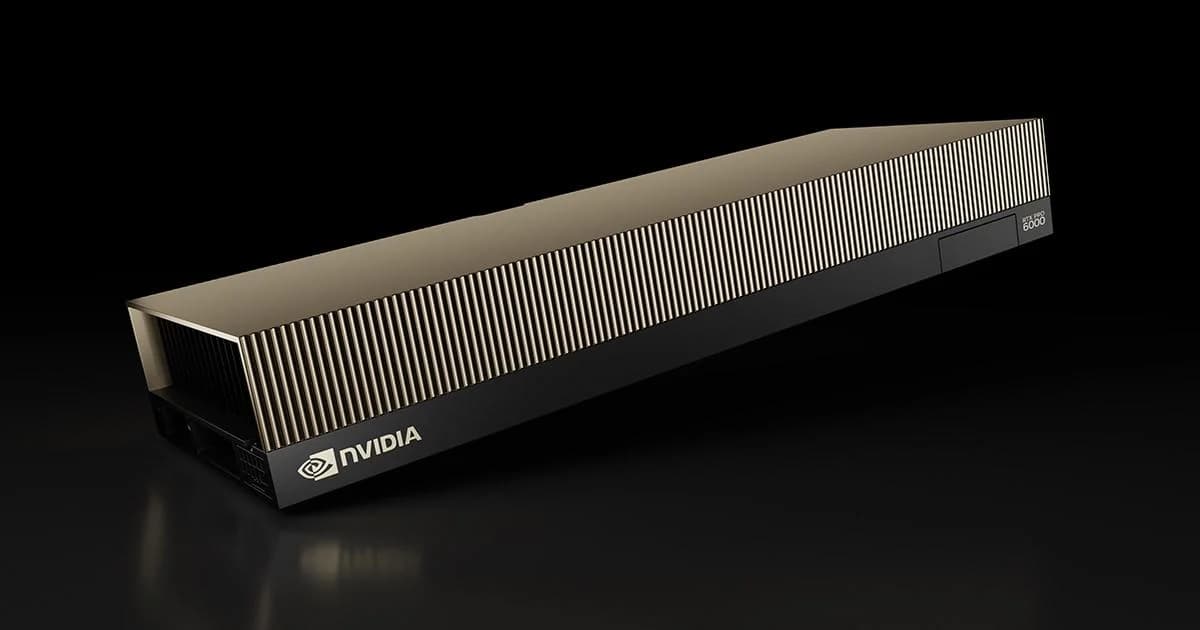
ตัวอย่าง AI Server Workstation บน Dell Precision 7875 ใช้แนวทางจัดชุด NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition หน่วยความจำ 96 GB GDDR7 ECC และกำลังไฟ GPU 300 W ตามรุ่นที่ Dell ระบุรองรับ ราคาเริ่มต้นโดยประมาณ 700,000 บาท ต้องยืนยัน CPU, RAM, SSD, PSU และขอบเขตบริการในใบเสนอราคา ไม่ใช่ RTX 6000 Ada หรือรุ่น Workstation 600 W [2][3]
ซื้อการ์ดอย่างเดียวอาจไม่จบ
ก่อนสั่ง GPU ให้ตรวจความยาว ความหนา จำนวนสล็อตที่บัง หัวต่อไฟ การระบายลม BIOS ระบบปฏิบัติการ และ driver รวมถึงเงื่อนไขรับประกันทั้งเครื่อง การ์ดที่เสียบลงสล็อตได้ไม่ได้แปลว่าระบบรองรับเต็มรูปแบบ
เริ่มเลือก GPU จากหน่วยความจำ แล้วดูความเร็ว
VRAM เปรียบเหมือนโต๊ะทำงานของ GPU: ต้องวางโมเดล ข้อมูลชั่วคราว และงานที่กำลังทำให้พอ ส่วนแบนด์วิดท์คือความเร็วหยิบข้อมูลบนโต๊ะ ความจุช่วยให้ใส่งานได้ แต่ไม่ใช่ตัวเลขความเร็ว การเปรียบเทียบ GPU ต้องใช้โมเดล precision และซอฟต์แวร์เดียวกัน ไม่เทียบค่า AI TOPS ที่คนละ precision หรือเงื่อนไข sparsity
ตัวอย่างตระกูล GPU เพื่ออ่านสเปก ไม่ใช่การจัดอันดับความเร็ว
| ตระกูล/รุ่นตัวอย่าง | หน่วยความจำตามรุ่น | ใช้พิจารณาเรื่องใด |
|---|---|---|
| GeForce RTX 5060 Ti | มีรุ่น 8 GB และ 16 GB | เลือก SKU ให้ถูก แม้ชื่อรุ่นใกล้กันความจุอาจต่างกัน |
| GeForce RTX 4090 / RTX 5090 | 24 GB / 32 GB | การ์ดเดี่ยวสำหรับงานพัฒนา ภาพ และ LLM ที่วัดว่าใส่ได้; ตรวจไฟและขนาดการ์ด |
| RTX 6000 Ada | 48 GB ECC | การ์ดมืออาชีพคนละรุ่นกับ RTX PRO 6000 Blackwell |
| RTX PRO 5000 Blackwell | มีรุ่น 48 GB และ 72 GB ECC | อ่านชื่อรุ่นย่อยและ datasheet ไม่เหมารวมว่าทุกใบมีความจุเท่ากัน |
| RTX PRO 6000 Blackwell | 96 GB ECC | Workstation, Max-Q และ Server Edition มีข้อกำหนดไฟ/ระบายความร้อนต่างกัน |
| GPU ศูนย์ข้อมูล เช่น H100 / H200 | H100 มีรุ่น 80 GB; H200 141 GB | เลือกทั้งระบบและ form factor; NVLink/เครือข่าย/ผู้ผลิตเครื่องมีผลต่อการขยาย |
ตัวอย่างสเปกที่ตรวจเมื่อ 14 พฤศจิกายน 2569 ไม่ใช่รายการสินค้าพร้อมส่งหรือคำรับรองประสิทธิภาพ [3][4][5][6][7][8][20][23]
VRAM เท่าไร เริ่มทำงานแบบไหนได้บ้าง
แนวทางเริ่มทดลอง ต้องตรวจ model card และ benchmark ก่อนซื้อ
| ช่วง VRAM ต่อ GPU | ตัวอย่างงานที่นำไปทดสอบ | สิ่งที่ต้องระวัง |
|---|---|---|
| 8–12 GB | เรียนรู้ AI, inference โมเดลภาพขนาดเล็ก, LLM ขนาดเล็กแบบ quantized | context, ความละเอียดภาพ และ batch มีพื้นที่จำกัด |
| 16–24 GB | ทดลอง LLM 7B–8B แบบ quantized, งานสร้างภาพบาง pipeline, LoRA บางโมเดล | LoRA ไม่ได้ทำให้ทุกโมเดลใส่ได้; รุ่นและการตั้งค่ามีผลมาก |
| 32–48 GB | ทดสอบ LLM 14B–32B แบบ quantized หรือเพิ่มพื้นที่ให้งานภาพ/การฝึกเพิ่ม | น้ำหนักใส่ได้ยังต้องเผื่อ KV cache และ runtime |
| 72–96 GB | ทดสอบ LLM 70B แบบ quantized หรืองานที่ต้องการพื้นที่มากขึ้น | จำนวนผู้ใช้และความเร็วตอบยังต้องวัด; context ยาวเพิ่มหน่วยความจำ |
| หลาย GPU / GPU ศูนย์ข้อมูล | โมเดลที่ใบเดียวไม่พอ งาน training หรือบริการหลายชุด | ซอฟต์แวร์ต้องรองรับการแบ่งงานและ topology ต้องเหมาะสม |
เป็นจุดเริ่มต้นในการทดลอง ไม่ใช่สเปกขั้นต่ำที่รับประกัน โมเดลชื่อใกล้กันอาจใช้หน่วยความจำต่างกัน และการ offload ไป RAM แลกกับเวลารับส่งข้อมูล [10][11][12]
คำนวณพื้นที่โมเดล LLM แบบเข้าใจง่าย
B หมายถึงจำนวนพารามิเตอร์เป็นพันล้าน น้ำหนักโมเดลอย่างเดียวประมาณได้จาก จำนวนพารามิเตอร์ × จำนวนบิตต่อพารามิเตอร์ ÷ 8 ตัวอย่าง 8B ที่ BF16/FP16 ใช้ 8 × 2 = 16 GB ส่วนที่ 4-bit ใช้ประมาณ 8 × 0.5 = 4 GB ตารางนี้ใช้ GB ฐานสิบ ยังไม่รวม metadata ของ quantization, KV cache, activation, runtime และพื้นที่ของระบบ [10][11]
น้ำหนักโมเดลอย่างเดียว: คำนวณเพื่อวางงบหน่วยความจำ
| โมเดลตัวอย่าง | BF16/FP16: 2 bytes | 8-bit: 1 byte | 4-bit: 0.5 byte |
|---|---|---|---|
| 8B | 16 GB | 8 GB | 4 GB |
| 14B | 28 GB | 14 GB | 7 GB |
| 32B | 64 GB | 32 GB | 16 GB |
| 70B | 140 GB | 70 GB | 35 GB |
ตัวเลขคำนวณเชิงอธิบาย ไม่ใช่ VRAM ขั้นต่ำพร้อมใช้งาน และไม่ใช่ผล benchmark ของโมเดลเฉพาะ
ดังนั้นโมเดล 70B แบบ 4-bit ที่คำนวณน้ำหนักได้ 35 GB ไม่ได้แปลว่า GPU 40 GB จะให้บริการหลายคนได้ทันที ต้องเหลือพื้นที่ให้บริบทของคำถามและคำตอบแต่ละงาน รวมถึงการทำงานของ inference engine การลดบิตช่วยลดพื้นที่ แต่ต้องทดสอบคุณภาพคำตอบและความเร็วด้วย ไม่ควรเลือกจากความจุอย่างเดียว
ใช้โมเดล ฝึกเพิ่ม และฝึกใหม่ ใช้เครื่องไม่เท่ากัน
แยกงานก่อนเลือกสเปก
| งาน | เกิดอะไรขึ้น | สิ่งที่ต้องเผื่อ |
|---|---|---|
| Inference | โหลดน้ำหนักแล้วทำนายหรือตอบคำถาม | น้ำหนัก + cache + activation + runtime |
| LoRA / QLoRA | ฝึกพารามิเตอร์เสริมบางส่วน; QLoRA ใช้น้ำหนักหลักแบบ quantized | ยังต้องมี base model, activation และ optimizer ของส่วนที่ฝึก |
| Full fine-tuning | อัปเดตพารามิเตอร์หลักของโมเดล | gradients, optimizer states, สำเนาน้ำหนัก และ activation ใช้พื้นที่เพิ่ม |
| Training from scratch | เรียนรู้น้ำหนักใหม่จากชุดข้อมูล | ข้อมูลคุณภาพสูง เวลา compute ระบบ checkpoint และการทดลองหลายรอบ |
ไม่มีตัวคูณ VRAM เดียวที่ใช้ได้กับทุก framework, optimizer, precision, sequence length หรือการแบ่งโมเดล [12][13]
สำหรับงานภาพ ต้องแยกงานตรวจชิ้นงาน/จำแนกภาพ ออกจากงานสร้างภาพด้วย diffusion และงานสร้างวิดีโอ การเพิ่มความละเอียด batch หรือจำนวนเฟรมทำให้พื้นที่และเวลาประมวลผลเพิ่มขึ้น การสร้างภาพที่ batch เล็กกับการ train โมเดลภาพจึงใช้สเปกคนละระดับ เทคนิคลดหน่วยความจำ เช่น offload, tiling หรือ checkpointing อาจช่วยแลกกับความเร็ว ต้องดูคู่มือ pipeline ที่ใช้จริง [14]
RAM หลักควรมีเท่าไร
RAM ของเครื่องแยกจาก VRAM บนการ์ด ยกเว้นแพลตฟอร์มหน่วยความจำร่วมอย่าง DGX Spark งานของ RAM คือรองรับระบบปฏิบัติการ โปรแกรมเตรียมข้อมูล database/cache และข้อมูลระหว่างโหลดโมเดล การมี RAM มากไม่ได้ทำให้ VRAM เพิ่มอัตโนมัติ และการย้ายบางส่วนของโมเดลไป RAM อาจติดแบนด์วิดท์ข้าม CPU/GPU
- ทำบัญชีหน่วยความจำ: ระบบและบริการพื้นฐาน + data loader/ภาพที่กำลังเตรียม + database/cache + ช่วงโหลดโมเดลหรือ offload + งานอื่นที่รันพร้อมกัน + พื้นที่สำรอง
- ตัวอย่างสมมติ: ระบบ 16 GB + เตรียมข้อมูล 24 GB + cache/database 16 GB + ช่วงโหลด/สำรองงาน 32 GB = 88 GB จึงพิจารณาความจุที่มากกว่านี้ เช่น 128 GB แล้ววัด peak จริง ไม่ใช่กฎว่าทุกเครื่องต้อง 128 GB
- หากทำหลายบริการหรือโหลด dataset ใหญ่พร้อมกัน อาจต้องพิจารณา 256 GB หรือมากกว่า แต่ต้องคิดจากรายการใช้จริง ไม่ใช้สูตร RAM = VRAM × 2 โดยไม่ดูงาน
- ตรวจ DDR รุ่นที่รองรับ, ECC UDIMM/RDIMM, จำนวนช่องหน่วยความจำและวิธีใส่ DIMM ตามคู่มือ การใส่แรมหลายแผงผิดช่องอาจไม่ได้แบนด์วิดท์ตามที่คาด
ความจุ กับจำนวนช่องหน่วยความจำ คนละเรื่อง
RAM ที่มีความจุรวมเท่ากันแต่ใส่ไม่ครบช่องหน่วยความจำ กับการกระจายตาม memory channels อาจให้แบนด์วิดท์ต่างกัน ตรวจ population guide ของ CPU และเมนบอร์ด รุ่น DIMM จำนวนแผง และความเร็วที่ระบบรองรับเมื่อใส่จริง
ECC คือกลไกตรวจจับและแก้ข้อผิดพลาดหน่วยความจำบางประเภท ไม่ใช่การรับประกันว่าข้อมูลจะไม่มีวันเสีย UDIMM กับ RDIMM เป็นหน่วยความจำคนละชนิด ต้องเลือกตามแพลตฟอร์ม ไม่เลือกจากความจุและ DDR รุ่นเดียวกันอย่างเดียว
Pipeline: ข้อมูลเดินผ่านอะไรบ้าง
Bandwidth คือปริมาณข้อมูลที่ส่งได้ต่อวินาที ส่วน latency คือเวลารอของแต่ละงาน ทั้งสองอย่างสำคัญ ต่อให้ถนนกว้าง แต่มีขั้นตอนรอทีละจุดก็อาจตอบช้า งาน LLM ช่วงอ่าน prompt ยาวกับช่วงสร้างคำตอบทีละ token มีพฤติกรรมต่างกัน จึงควรแยกวัด prefill และ decode [11]
อ่านหน่วยให้ถูกก่อนเทียบระบบ
| ทางเชื่อม | ตัวอย่างเพดานเชิงทฤษฎี | คำถามที่ต้องถาม |
|---|---|---|
| PCIe 4.0 ×16 | ประมาณ 31.5 GB/s ต่อทิศทาง | เสียบสล็อต ×16 แต่ต่อไฟฟ้าจริงกี่เลน? |
| PCIe 5.0 ×16 | ประมาณ 63 GB/s ต่อทิศทาง | CPU เมนบอร์ด และอุปกรณ์รองรับรุ่นเดียวกันหรือไม่? |
| Ethernet 10 / 25 / 100 Gbps | ประมาณ 1.25 / 3.125 / 12.5 GB/s ก่อน overhead | สวิตช์ สาย NIC และ Storage ปลายทางเร็วพอหรือไม่? |
| GPU memory bandwidth | อ่านจาก datasheet ของ GPU นั้น | เป็นความเร็วภายในหน่วยความจำ ไม่ใช่ PCIe หรือความเร็วเครือข่าย |
GB/s เป็นไบต์ ส่วน Gbps เป็นบิต; 8 bits = 1 byte ตัวเลข PCIe เป็นหลังคิดการเข้ารหัสของลิงก์ แต่ยังไม่หัก protocol overhead และไม่ใช่ความเร็วใช้งานจริง [16]
ตัวอย่างสมมติ: ถ้าชุดข้อมูลที่พร้อมใช้งานมี 100 GB และทางเชื่อม 10 Gbps ให้เพดาน 1.25 GB/s เวลารับส่งอย่างเดียวต่ำสุดทางทฤษฎีคือ 100 ÷ 1.25 = 80 วินาที ของจริงช้ากว่านี้จาก overhead ไฟล์ย่อย CPU และดิสก์ จึงไม่ควรซื้อ NIC เร็วขึ้นโดยไม่ตรวจว่าจุดอื่นตามทันหรือไม่
CPU และเมนบอร์ด: ดูเลน ไม่ใช่แค่ช่องเสียบ
CPU ช่วยอ่านไฟล์ ถอดรหัสภาพ tokenize ข้อความ จัด batch และดูแลบริการอื่น จำนวนคอร์มากช่วยบางงาน แต่ซอฟต์แวร์ต้องใช้คอร์เหล่านั้นได้ เมนบอร์ดต้องมีทั้งสล็อตที่ว่างจริงและเลน PCIe ที่ CPU/ชิปเซ็ตส่งให้ ไม่ใช่ดูช่องยาว ×16 แล้วนับว่าได้ ×16 ทุกช่อง
- อ่าน block diagram: สล็อตใดต่อ CPU โดยตรง สล็อตใดผ่านชิปเซ็ต และอุปกรณ์ใดแชร์เลนกับ M.2/NIC
- ตัวอย่างวางแผน: GPU 4 ใบ ×16 = 64 เลน; NVMe 2 ตัว ×4 = 8 เลน; NIC ×8 = 8 เลน รวม 80 เลนตามสมมตินี้ ต้องตรวจการเดินเลนจริง รวมอุปกรณ์ที่ติดมากับบอร์ด
- ตรวจขนาดและระยะห่างการ์ด: การ์ดกิน 3 สล็อตอาจบังช่องอื่น แม้จำนวนเลนรวมพอ
- PCIe bifurcation และ riser ต้องรองรับทั้ง CPU, BIOS, เมนบอร์ด และอุปกรณ์ ไม่ใช่ซื้อสายแยกแล้วทุกเครื่องจะใช้ได้
ไม่จำเป็นต้องมี 2 CPU เพื่อใช้ 4 GPU เสมอไป ตัวอย่าง Threadripper PRO บนแพลตฟอร์ม WRX90 รองรับสูงสุด 128 PCIe 5.0 lanes และหน่วยความจำ 8 channels ในระบบซ็อกเก็ตเดียว แต่จำนวนการ์ดที่ติดตั้งได้จริงยังขึ้นกับเมนบอร์ด เคส ไฟ และการรับรองของผู้ผลิต [17] Dell Precision 7875 มีผังสล็อตเฉพาะของตัวเอง ไม่ควรสรุปว่า CPU มีเลนมากแล้วเครื่องรุ่นนี้จะรองรับ GPU สี่ใบ [22]
สอง CPU ช่วยอะไร และ NUMA คืออะไร
เครื่องสองซ็อกเก็ตอาจเพิ่มจำนวนคอร์ ความจุ RAM และทรัพยากร I/O ตามแพลตฟอร์ม แต่ไม่ใช่นำแบนด์วิดท์ทุกอย่างมาบวกกันแล้วทุกงานเร็วขึ้นสองเท่า CPU แต่ละตัวมีหน่วยความจำและอุปกรณ์ที่อยู่ใกล้ตัว การเข้าถึงฝั่งอีก CPU ต้องผ่านลิงก์ระหว่างซ็อกเก็ต แนวคิดนี้เรียกว่า NUMA [15]
CPU A
- RAM ฝั่ง Aหน่วยความจำที่ CPU A เข้าถึงโดยตรง
- GPU 0 และ GPU 1ตัวอย่าง GPU ที่ต่อกับ PCIe root ของ A
CPU B
- RAM ฝั่ง Bหน่วยความจำที่ CPU B เข้าถึงโดยตรง
- GPU 2 และ GPU 3ตัวอย่าง GPU ที่ต่อกับ PCIe root ของ B
ลิงก์ระหว่าง CPU: ข้ามฝั่งได้ แต่มีต้นทุนเวลาและแบนด์วิดท์
ต้องอ่าน topology ของเครื่องจริง บางระบบมี PCIe switch และการเดินเลนต่างจากตัวอย่าง ควรผูกงานและหน่วยความจำให้ใกล้ GPU ที่ใช้งานตามความเหมาะสม
สอง CPU เหมาะเมื่อภาระ CPU, RAM หรือ I/O ต้องการทรัพยากรเพิ่มจริง และระบบปฏิบัติการกับซอฟต์แวร์จัดงานได้เหมาะสม หากงานรอ GPU เป็นหลักและใช้การ์ดไม่มาก ระบบ CPU เดียวที่มีเลนเพียงพออาจจัดการง่ายกว่า ให้ตรวจ topology ด้วยเครื่องมือของระบบและ benchmark ก่อนตัดสินใจ
หลาย GPU ใช้อย่างไร ไม่ใช่เสียบแล้ว VRAM รวมทันที
สามวิธีใช้ GPU หลายใบ
| วิธี | ภาพรวม | สิ่งที่แลกเปลี่ยน |
|---|---|---|
| แยกงาน / ทำสำเนาบริการ | แต่ละ GPU รันโมเดลที่ใส่ได้เอง แล้วกระจายคำขอ | เพิ่มความสามารถรับงานรวม แต่โมเดลหนึ่งชุดยังต้องใส่ต่อใบ |
| Data parallel training | แต่ละ GPU ฝึกด้วยข้อมูลคนละ batch แล้วแลก gradients | ต้องสื่อสารระหว่าง GPU และจัด batch/optimizer ให้เหมาะ |
| Tensor / pipeline parallel | แบ่งโมเดลหรืองานภายในหนึ่งโมเดลข้าม GPU | ช่วยกรณีใบเดียวไม่พอ แต่เพิ่มการสื่อสารและขึ้นกับ engine |
GPU 24 GB สองใบไม่กลายเป็น GPU 48 GB ใบเดียวโดยอัตโนมัติ; model sharding และข้อจำกัดแต่ละใบยังต้องตรวจ [18][19]
ตรวจว่าการ์ดรองรับ NVLink หรือไม่ อย่าอนุมานจากชื่อ RTX หรือราคา ถ้าใช้ PCIe ต้องดูเส้นทางระหว่าง GPU และการรองรับ peer-to-peer ของทั้งระบบ สำหรับหลายเครื่อง เครือข่ายจะกลายเป็นส่วนหนึ่งของการคำนวณ ต้องดู NIC, switch, RDMA ตามซอฟต์แวร์ และการวางตำแหน่ง GPU/NIC ไม่ใช่มีพอร์ต 100 Gbps แล้วรับประกันว่าจะ scale ได้ดี [18]
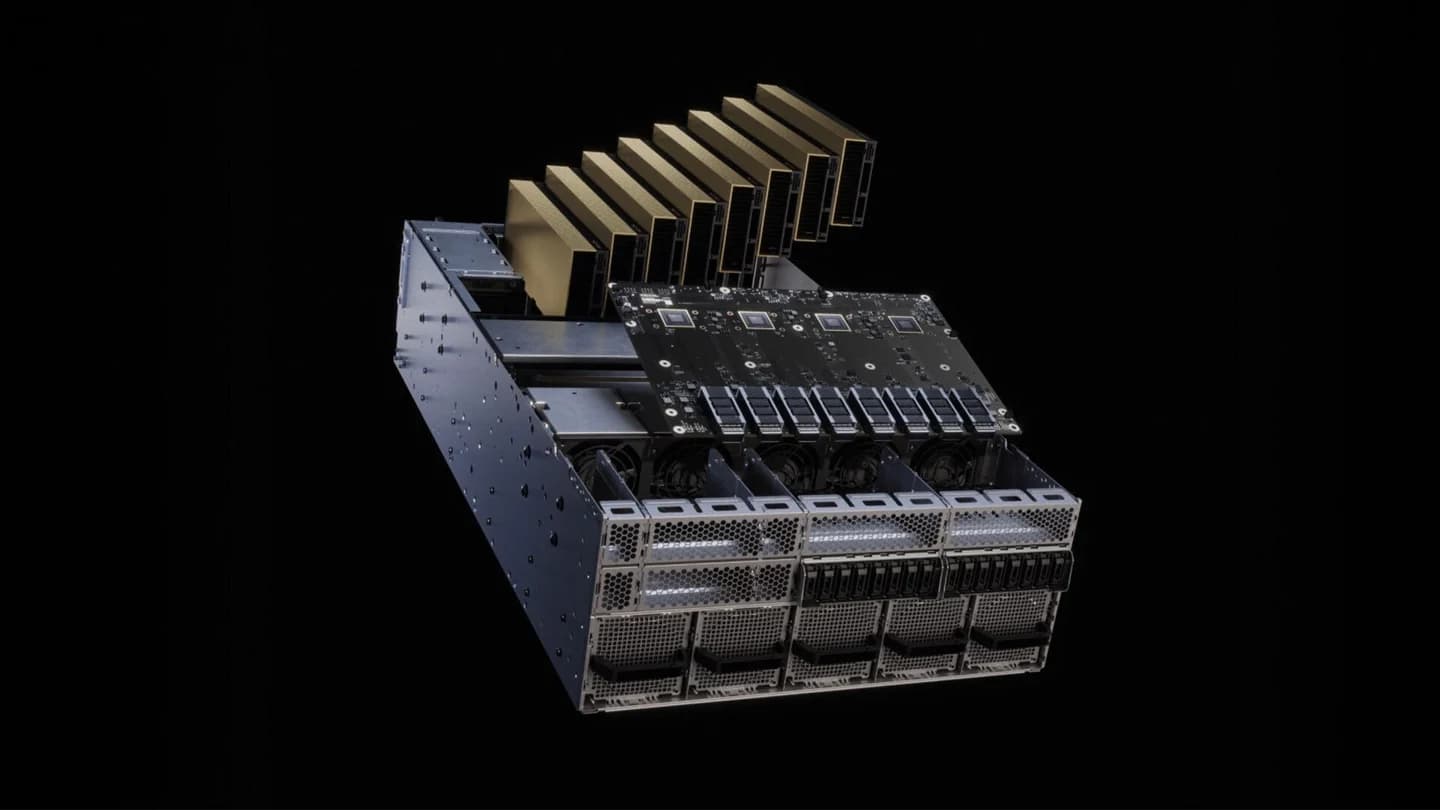
NVLink เป็นทางเชื่อมความเร็วสูงระหว่าง GPU ในระบบที่รองรับ ส่วน RDMA ช่วยให้เครื่องที่รองรับรับส่งข้อมูลผ่านเครือข่ายโดยลดงานคัดลอกบางส่วนของ CPU ทั้งสองอย่างต้องรองรับทั้งฮาร์ดแวร์และซอฟต์แวร์ ไม่ใช่คุณสมบัติที่ทุก GPU หรือทุกพอร์ตเครือข่ายมี [18]
รองรับผู้ใช้กี่คน ต้องดูอะไร
แยก “คนที่มีบัญชี” ออกจาก “คำขอที่กำลังประมวลผล” เช่น องค์กรมีบัญชีจำนวนมาก แต่คนถามพร้อมกันอาจน้อย หรือผู้ใช้น้อยแต่ส่งเอกสารยาวทุกครั้งก็อาจใช้ทรัพยากรมากกว่า สำหรับ LLM ให้ดูขนาดโมเดล precision ความยาว input/output จำนวนคำขอพร้อมกัน KV cache และกลไก batching [11]
- TTFT: เวลาตั้งแต่ส่งคำถามจนได้ token แรก รวมเวลารอคิวด้วย
- ความเร็วคำตอบ: tokens/s ต่อคำขอ และเวลารวมจนตอบจบ ไม่ดูเฉพาะยอดรวมของเครื่อง
- Throughput: งานหรือ token รวมต่อวินาทีภายใต้ภาระทดสอบที่กำหนด
- P95 latency: ค่าระยะเวลาที่ 95 จาก 100 คำขอเสร็จไม่ช้ากว่าค่านี้ ใช้ดูอาการช้าช่วงมีคนพร้อมกัน [21]
- ข้อผิดพลาดและคุณภาพ: out-of-memory, timeout, คำตอบไม่ตรงโจทย์ และการแยกสิทธิ์เอกสาร
ตัวอย่างสมมติสำหรับคำนวณ: หากวัดได้ 120 output tokens/s รวมที่ภาระทดสอบหนึ่ง และต้องการเฉลี่ย 20 output tokens/s ต่อคำขอ การหาร 120 ÷ 20 = 6 ใช้เป็นจุดเริ่มทดลองคำขอพร้อมกันประมาณ 6 งานเท่านั้น ไม่ใช่คำรับรองรองรับ 6 คน เพราะ prefill, KV cache, batching และความยาวคำตอบทำให้ผลเปลี่ยน ต้องทดสอบ concurrency หลายระดับด้วย prompt จริงและเกณฑ์เวลารอที่ตกลง
ผลทดสอบที่ควรขอพร้อมใบเสนอราคา
ระบุชื่อและรุ่นโมเดล quantization/context, ตัวอย่างคำถาม, ความยาวคำตอบ, concurrent requests, TTFT, P95, throughput และ peak memory พร้อมเวอร์ชันซอฟต์แวร์ เพื่อให้เปรียบเทียบเครื่องด้วยงานเดียวกัน ไม่ใช้จำนวนผู้ใช้ที่ไม่มีเงื่อนไขกำกับ
Power Supply ความร้อน และพื้นที่ติดตั้ง
ทำบัญชีไฟของทั้งระบบ: GPU + CPU + RAM + SSD/NIC + เมนบอร์ดและพัดลม แล้วเผื่อโหลดเปลี่ยนฉับพลันและข้อกำหนดผู้ผลิต ตัวเลข TDP หรือ GPU power ไม่ใช่ค่าที่ปลั๊กไฟวัดได้ของทั้งเครื่อง ประสิทธิภาพ PSU และภาระงานมีผลต่อไฟจริง
ตัวอย่างสมมติ ไม่ใช่สเปกประกอบสำเร็จหรือสเปก Dell 7875: GPU 4 ใบ × 300 W = 1,200 W; CPU 350 W; RAM/Storage/บอร์ด/พัดลมรวมสมมติ 200 W ได้โหลดฝั่งอุปกรณ์ 1,750 W ก่อนเผื่อ ต้องตรวจ PSU หัวต่อ สายไฟ และกำลังที่รองรับจริง ไม่ควรซื้อ PSU 1,750 W จากผลบวกนี้โดยตรง การ์ด 600 W สี่ใบมีเฉพาะ GPU รวม 2,400 W จึงเป็นคนละโจทย์กับเครื่องหนึ่งการ์ด
- ตรวจหัวต่อและสายที่ผู้ผลิตกำหนด ไม่ใช้สายแปลงหรือแยกพ่วงโดยไม่มีการรับรอง
- PSU ซ้ำซ้อนต้องดูโหมด redundancy: สองชุดไม่ได้แปลว่าใช้กำลังรวมได้ทั้งหมดขณะต้องทน PSU เสียหนึ่งชุด
- การ์ด passive cooling ต้องมี airflow ของ chassis ตามข้อกำหนด ไม่ใส่ในเคสทั่วไปแล้วหวังพึ่งพัดลม PSU
- ตรวจปลั๊ก วงจรไฟ UPS ทั้งหน่วย W/VA และเวลาสำรอง รวมความร้อน เสียง และพื้นที่บริการเครื่องกับผู้ดูแลอาคาร
ค่าไฟคำนวณจากกำลังเฉลี่ยที่วัดได้: ตัวอย่างสมมติ 1 kW × 8 ชั่วโมง × 30 วัน = 240 kWh แล้วคูณอัตราค่าไฟจริง ยังไม่รวมระบบทำความเย็น จึงควรวัดทั้ง idle และภาระงานที่ใช้งานประจำก่อนเทียบต้นทุนซื้อหรือเช่า
Storage เก็บอะไร และต้องเร็วแค่ไหน
แยกข้อมูลก่อนเลือก SSD และระบบสำรอง
| สิ่งที่เก็บ | ลักษณะการใช้งาน | สิ่งที่เลือกให้เหมาะ |
|---|---|---|
| ระบบและโปรแกรม | OS, containers, libraries | พื้นที่อัปเดตและกู้คืน; แยกจากข้อมูลสำคัญเมื่อเหมาะสม |
| โมเดลและ checkpoint | ไฟล์ใหญ่หลายรุ่น โหลดตอนเริ่มหรือบันทึกระหว่างฝึก | ความจุ อัตราอ่าน/เขียนต่อเนื่อง และพื้นที่สำหรับรุ่นที่ย้อนกลับได้ |
| Dataset ภาพ/วิดีโอ/เอกสาร | ไฟล์ใหญ่หรือไฟล์ย่อยจำนวนมาก | ดูทั้ง throughput และ IOPS รวม data-loader pattern |
| ฐานข้อมูล/vector index/log | อ่านเขียนย่อยและอาจมีข้อมูลอ่อนไหว | latency, endurance, สิทธิ์เข้าถึง และนโยบายเก็บรักษา |
| Backup | สำเนาแยกจากเครื่องหลัก | เวอร์ชัน การเข้ารหัส การทดสอบกู้คืน และสิทธิ์ผู้เข้าถึง |
RAID ช่วยบางกรณีดิสก์เสีย แต่ไม่แทน backup สำหรับการลบผิด ransomware หรือความเสียหายทั้งเครื่อง
ตัวอย่างสมมติ: dataset 500 GB + model/checkpoint 400 GB + cache 200 GB + ระบบและ log 100 GB = 1,200 GB ก่อนเผื่อการเติบโต จึงต้องเลือกความจุใช้งานจริงมากกว่านี้และคิด backup แยกด้วย อย่าสับสนความจุดิบกับ usable capacity หลัง RAID/format และอย่าใช้ความเร็ว sequential สูงสุดเพียงค่าเดียวตัดสินงานไฟล์ย่อย
จัดสเปกตั้งต้น แล้วทดสอบก่อนสั่งซื้อ
แบบร่างเพื่อเริ่มคุยกับผู้จัดระบบ ไม่ใช่ชุดรับประกันประสิทธิภาพ
| สถานการณ์ | แนวทางตั้งต้น | เงื่อนไขก่อนสั่ง |
|---|---|---|
| เรียนรู้หรือพัฒนา AI บนโต๊ะ | DGX Spark หรือ PC ที่มี GPU 16–24 GB ตามซอฟต์แวร์ | ตรวจ Arm64/x86, โมเดล และความเร็วที่ยอมรับได้ |
| ทีมทำภาพและ LLM ในองค์กร | Workstation GPU 32–96 GB; คำนวณ RAM/SSD จากบัญชีข้อมูล | ทดสอบ pipeline จริงและการใช้งานพร้อมบริการอื่น |
| หลายทีม / โมเดลใหญ่ / งานฝึกต่อเนื่อง | ระบบหลาย GPU หรือหลายโหนดที่ผู้ผลิตรับรอง | ดู topology, network, power/cooling, การดูแล และ benchmark รวมระบบ |
ขนาด VRAM ไม่ใช่คำรับรองความเหมาะสม ต้องเริ่มจากรุ่นโมเดลและเกณฑ์ตรวจรับของคุณ
- 1
เขียนโจทย์และเกณฑ์รับงาน
ระบุโมเดล งานจริง ผู้ใช้พร้อมกัน เวลารอที่ยอมรับได้ และข้อกำหนดข้อมูล
- 2
ทำงบหน่วยความจำ
แยกน้ำหนักโมเดล cache activation และ RAM ของงานรอบข้าง แล้ววัด peak ในการทดลอง
- 3
วาดทางเดินข้อมูล
ไล่ Storage → CPU/RAM → PCIe → GPU รวมเครือข่ายและฐานข้อมูล ตรวจคอขวดทีละจุด
- 4
ตรวจเครื่องทั้งชุด
อ่านคู่มือ CPU เมนบอร์ด DIMM สล็อต PSU หัวต่อ ระบบลม และรายการที่ผู้ผลิตรองรับ
- 5
ทดสอบแล้วค่อยสรุปใบเสนอราคา
ใช้ชุดข้อมูลและ concurrency จริง บันทึกคุณภาพ เวลาตอบ ไฟ และหน่วยความจำ พร้อมแผนขยายและขอบเขตดูแล
ถ้าต้องการประเมินร่วมกับทีม Inspektion เตรียมชื่อโมเดลหรือประเภทงาน ตัวอย่างข้อมูล จำนวนคำขอพร้อมกัน เวลารอที่รับได้ และข้อจำกัดสถานที่ แล้วดู DGX Spark, Dell AI Workstation หรือภาพรวม Modern Data เพื่อเลือกจุดเริ่มต้นที่เหมาะกับระบบของคุณ งานค้นเอกสารอ่านต่อได้ที่ Enterprise KM Chatbot
คำถามที่พบบ่อย
DGX Spark กับ Workstation แบบไหนเหมาะกับผู้เริ่มต้น
ดูงานและซอฟต์แวร์ที่ต้องใช้ DGX Spark เหมาะกับการพัฒนาและทดลอง AI ในเครื่องเล็กที่มีหน่วยความจำร่วมมาก แต่ต้องตรวจ Arm64 ส่วน Workstation เลือก GPU และส่วนประกอบตามแพลตฟอร์มได้ ทั้งสองแบบต้องทดสอบโมเดลจริงก่อนกำหนดจำนวนผู้ใช้
GPU 24 GB สองใบใช้แทนใบเดียว 48 GB ได้ไหม
ไม่ได้โดยอัตโนมัติ ต้องใช้ซอฟต์แวร์ที่แบ่งโมเดลหรืองานข้าม GPU ได้ และตรวจหน่วยความจำต่อใบกับเส้นทางสื่อสาร อีกทางคือให้แต่ละ GPU รันบริการคนละชุดเพื่อรับงานรวมมากขึ้น
เพิ่ม RAM แล้วช่วยให้ LLM ที่ใหญ่กว่า VRAM รันได้หรือไม่
บาง engine รองรับ offload ไป RAM แต่มีต้นทุนรับส่งข้อมูลและอาจตอบช้าลง ต้องตรวจการรองรับและวัดจริง RAM มากไม่ได้ทำให้ GPU memory เพิ่มขึ้น ยกเว้นระบบหน่วยความจำร่วมที่ต้องพิจารณาอีกแบบ
ต้องมีสอง CPU จึงใส่ GPU สี่ใบได้หรือไม่
ไม่จำเป็นเสมอไป แพลตฟอร์ม CPU เดียวบางรุ่นมีเลน PCIe เพียงพอ ต้องตรวจเมนบอร์ด ความกว้างสล็อต การ์ดที่รองรับ ระบบไฟและความร้อน ส่วนเครื่องสอง CPU ต้องดู NUMA และตำแหน่ง GPU/RAM ด้วย
ราคาเริ่มต้น 300,000 และ 700,000 บาท รวมอะไรบ้าง
เป็นราคาประเมินเริ่มต้นของข้อเสนอ DGX Spark และ Dell AI Workstation ตามลำดับ รายการฮาร์ดแวร์ ซอฟต์แวร์ ติดตั้ง ภาษี การรับประกัน และส่งมอบยืนยันในใบเสนอราคา ไม่ใช่ราคาตายตัวหรือคำรับรองจำนวนผู้ใช้
อ้างอิง
- [1]
DGX Spark: specifications and workloads — NVIDIA (สืบค้น 2026-11-14)
- [2]
Precision 7875 Tower: graphics options — Dell (สืบค้น 2026-11-14)
- [3]
RTX PRO 6000 Blackwell Max-Q Workstation Edition — NVIDIA (สืบค้น 2026-11-14)
- [4]
GeForce RTX 5060 family — NVIDIA (สืบค้น 2026-11-14)
- [5]
GeForce RTX 5090 — NVIDIA (สืบค้น 2026-11-14)
- [6]
RTX 6000 Ada Generation — NVIDIA (สืบค้น 2026-11-14)
- [7]
RTX PRO 5000 Blackwell — NVIDIA (สืบค้น 2026-11-14)
- [8]
H200 Tensor Core GPU — NVIDIA (สืบค้น 2026-11-14)
- [9]
RTX PRO 6000 Blackwell Server Edition — NVIDIA (สืบค้น 2026-11-14)
- [10]
Quantization with bitsandbytes — Hugging Face (สืบค้น 2026-11-14)
- [11]
Optimization and Tuning — vLLM (สืบค้น 2026-11-14)
- [12]
Memory anatomy of model training — Hugging Face (สืบค้น 2026-11-14)
- [13]
Parameter-efficient fine-tuning: quantization — Hugging Face (สืบค้น 2026-11-14)
- [14]
Reduce memory usage for diffusion pipelines — Hugging Face (สืบค้น 2026-11-14)
- [15]
Performance Tuning Guide: data loading and NUMA — PyTorch (สืบค้น 2026-11-14)
- [16]
PCIe bandwidth per direction after encoding overhead — PCI-SIG (สืบค้น 2026-11-14)
- [17]
AMD Ryzen Threadripper PRO processors — AMD (สืบค้น 2026-11-14)
- [18]
Distributed serving — vLLM (สืบค้น 2026-11-14)
- [19]
DistributedDataParallel — PyTorch (สืบค้น 2026-11-14)
- [20]
GeForce RTX 4090 specifications — NVIDIA (สืบค้น 2026-11-14)
- [21]
LLM Benchmarking: Fundamental Concepts — NVIDIA (สืบค้น 2026-11-14)
- [22]
Precision 7875 Tower: internal slots — Dell (สืบค้น 2026-11-14)
- [23]
HGX GPU memory and platform specifications — NVIDIA (สืบค้น 2026-11-14)