Memilih AI Server yang Sesuai Kebutuhan: dari Unit Kecil hingga Multi-GPU
Tim insinyur Inspektion · Diterbitkan 14 November 2026 · Terakhir diperbarui 14 November 2026
Panduan AI Server: bandingkan DGX Spark dan Workstation. Pilih GPU, VRAM, RAM, CPU, PCIe, storage dan daya, lalu uji pengguna bersamaan.
Ringkasan
- Mulai dari jenis pekerjaan dan model, lalu hitung kebutuhan memori sebelum memilih GPU, jangan hanya mulai dari harga unitnya
- 128 GB unified memory pada DGX Spark bukan VRAM kartu terpisah, dan GPU tidak bisa ditambah seperti pada PC
- Beberapa GPU memerlukan perangkat lunak dan topology yang mendukung, VRAM tidak otomatis digabung
- Jumlah pengguna harus diukur dari permintaan bersamaan, context, dan waktu respons, bukan ditentukan hanya dari satu nilai ukuran GPU
- Periksa RAM, Storage, PCIe, network, daya, dan panas pada keseluruhan sistem, serta lakukan pengujian sebelum membeli
Mulai dari pekerjaannya, bukan dari nama kartu grafisnya
Memilih AI Server mirip merakit komputer, tetapi harus memperhatikan ukuran model, kecepatan transfer data, dan jumlah pekerjaan yang terjadi bersamaan. Unit yang mampu memuat model bisa jadi masih belum sanggup menjawab pengguna secepat yang dibutuhkan, dan menambah GPU tidak banyak membantu jika data tersangkut di Storage, CPU, atau jaringan. Artikel ini membagi unit menjadi kecil, menengah, dan besar menurut pola penggunaan, bukan standar ukuran dari produsen
- Tentukan pekerjaannya: menggunakan model yang sudah ada, melatih lanjutan dari model yang ada, atau melatih model baru dari awal
- Tentukan datanya: teks, gambar, video, atau beberapa jenis, termasuk panjang pertanyaan, resolusi gambar, dan jumlah file
- Tentukan waktu yang dapat diterima: harus menjawab seketika, pekerjaan boleh masuk antrean, atau diproses dalam batch pada malam hari
- Tentukan jumlah orang dan pekerjaan bersamaan: jumlah total akun tidak sama dengan jumlah permintaan yang sedang diproses oleh mesin
Istilah yang dipakai di sepanjang artikel
Inference = menggunakan model untuk menjawab atau memprediksi, Training = melatih model, Fine-tuning = melatih lanjutan dari model yang ada, VRAM = memori pada GPU, RAM = memori utama, Token = satuan teks yang diproses model, yang tidak sama satu banding satu dengan jumlah kata bahasa Thai CPU adalah prosesor utama yang menyiapkan data dan mengatur tugas, sedangkan GPU cocok untuk banyak perhitungan secara paralel. Batch adalah kelompok data yang diproses bersama. Context adalah informasi yang dipakai model untuk menjawab pertanyaan. Quantization mengurangi jumlah bit untuk menyimpan bobot model agar hemat memori, sehingga kualitas hasil perlu diuji kembali.
Apa bedanya unit kecil, menengah, dan besar
Pilih jenis unit yang sesuai dengan cara pemakaian
| Ukuran dalam artikel ini | Cocok sebagai titik awal untuk | Kelebihan | Keterbatasan |
|---|---|---|---|
| Kecil: DGX Spark | Pengembangan, uji coba model, dan pekerjaan AI internal yang batasannya sudah diuji | Unit ringkas, memiliki memori bersama berkapasitas besar dan paket perangkat lunak AI | Tidak bisa menambah kartu GPU seperti pada PC; periksa Arm64 dan kecepatannya dengan pekerjaan nyata |
| Menengah: PC / Workstation + GPU | Pekerjaan gambar, LLM, dan pelatihan lanjutan yang GPU-nya bisa dipilih secukupnya | Kartu, RAM, dan SSD bisa dipilih sesuai platform; lebih mudah dirawat daripada unit multi-node | Slot, lane PCIe, daya, dan panas membatasi jumlah kartu |
| Besar: GPU Server / multi-node | Pekerjaan lintas tim, model besar, atau pelatihan dan layanan yang perlu diskalakan | Merancang GPU, jaringan, sistem kelistrikan, dan perawatan tingkat pusat data secara bersamaan | Perlu ruang, sistem pendingin, dan tim perawatan; beberapa GPU tidak selalu menjadi lebih cepat sebanding jumlahnya |
Ukuran casing, harga, atau jumlah GPU saja bukanlah hasil pengujian kemampuan menangani beban kerja
Untuk apa DGX Spark dibuat
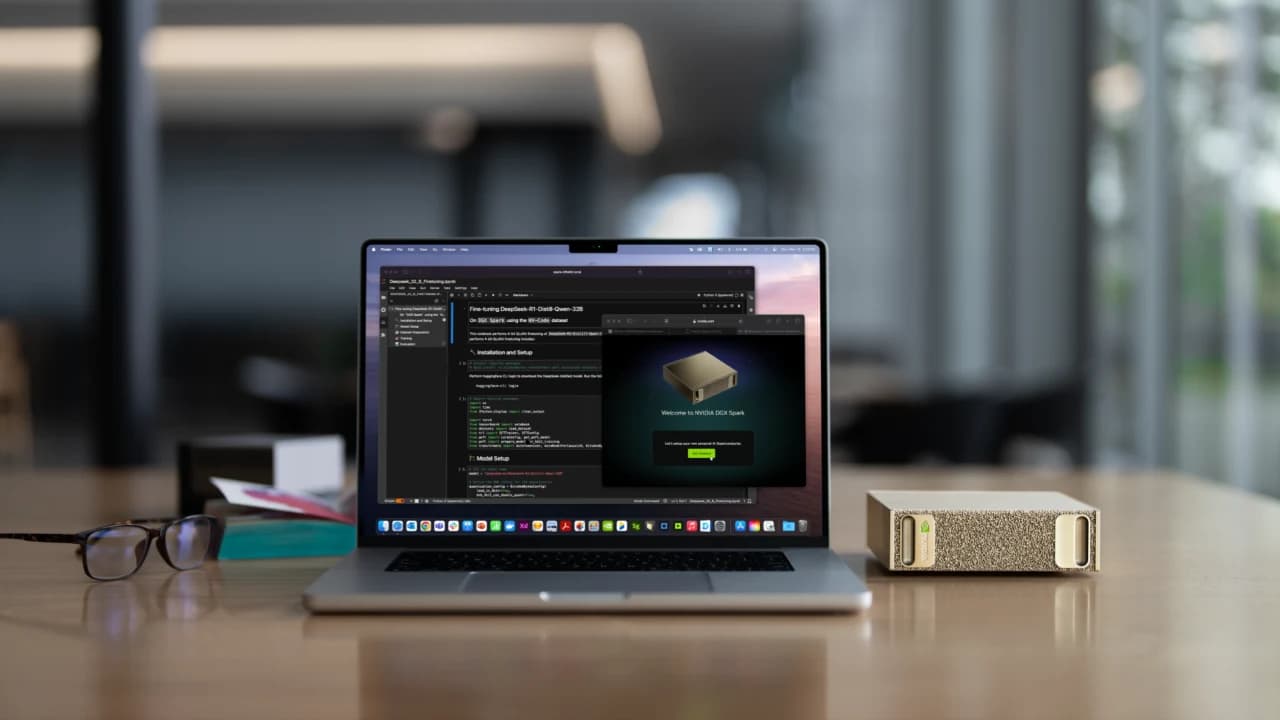
NVIDIA DGX Spark menggunakan GB10 Grace Blackwell Superchip dengan CPU berbasis Arm dan memori bersama 128 GB untuk CPU/GPU. Keunggulannya adalah bisa mengembangkan, bereksperimen, menyetel, dan menjalankan model di meja kerja tanpa harus mulai dari merakit unit multi-kartu. Bandwidth memorinya menurut spesifikasi adalah 273 GB/s, jadi perlu memperhatikan kapasitas sekaligus kecepatannya, jangan diartikan bahwa 128 GB sama dengan kartu dengan VRAM 128 GB [1]
- Cocok untuk uji coba LLM, asisten pencarian dokumen, pekerjaan pengembangan AI, dan evaluasi model di organisasi, sebelum diperbesar ke unit yang lebih besar
- Memori bersama membuat CPU/GPU memakai ruang yang sama, tetapi sistem operasi dan program lain juga memakai ruang ini, sehingga tidak tersisa 128 GB penuh untuk model
- Harus diperiksa bahwa framework, container, library, dan komponen tambahan mendukung Arm64 dan GPU model ini. Perangkat lunak x86 yang lama tidak semuanya bisa dipindahkan untuk dipakai di sini.
- Ini bukan jawaban otomatis untuk pengguna dalam jumlah banyak atau untuk melatih model besar dari nol. Waktu respons dan volume kerja nyata harus diukur.
Lihat AI Server ukuran kecil berbasis NVIDIA DGX Spark, harga mulai sekitar 300,000 THB, yaitu anggaran awal dari penawaran Inspektion, bukan harga ritel global NVIDIA. Rincian perangkat keras, perangkat lunak, pemasangan, pajak, garansi, dan jadwal pengiriman dikonfirmasi sesuai surat penawaran harga.
PC dan Workstation: pilih GPU yang sesuai dengan pekerjaan
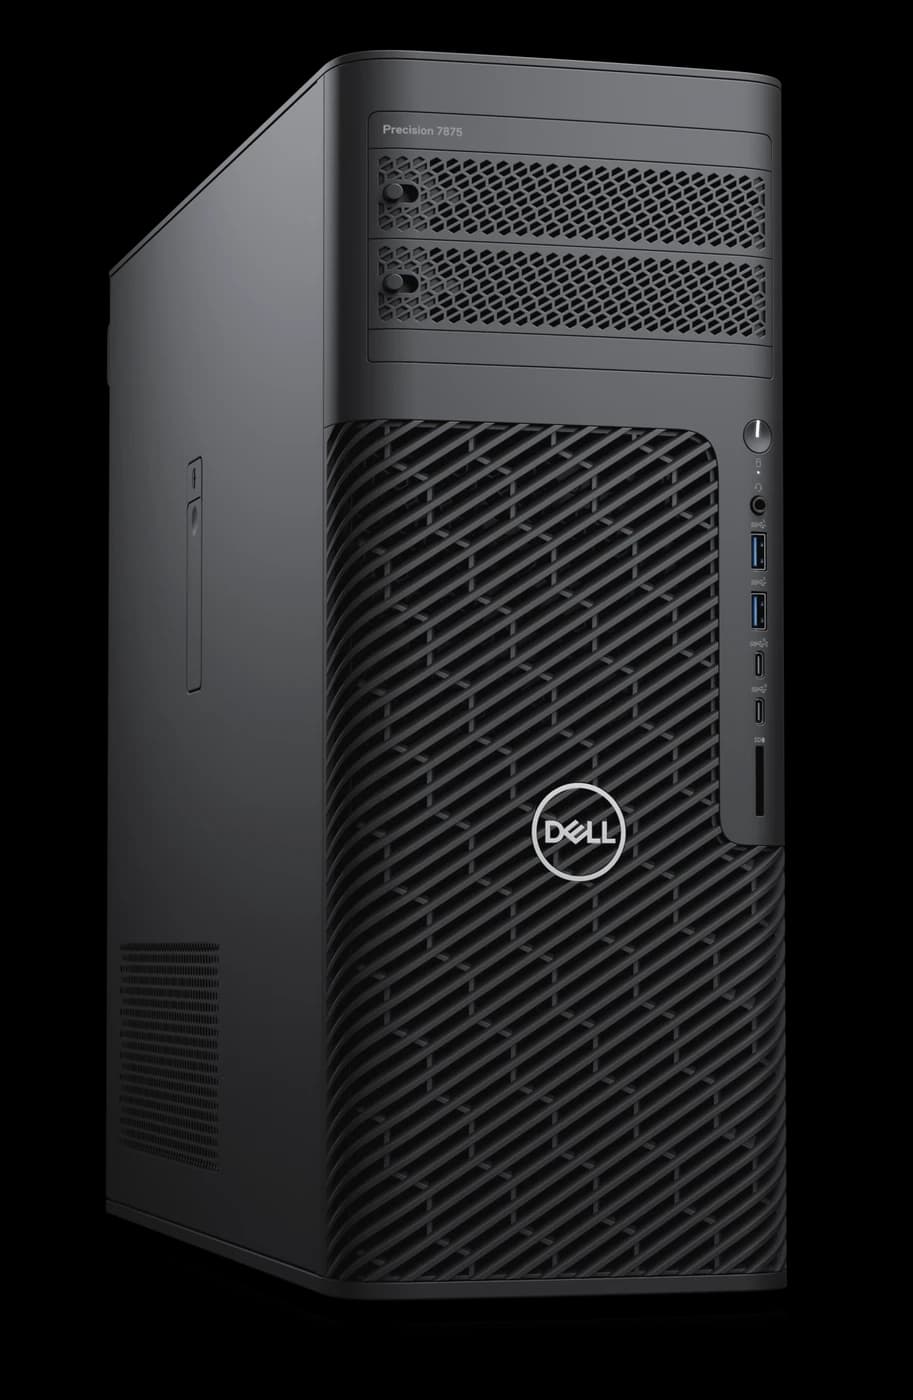
PC cocok bila anggaran dan persyaratannya sudah jelas. Workstation menambah pilihan dari sisi memori ECC, lane PCIe, dan dukungan perangkat keras sesuai modelnya. Perbedaan yang harus diperiksa adalah motherboard, CPU, casing, sistem daya, dan daftar perangkat yang disertifikasi oleh produsen; bukan karena ada kata Workstation lalu kartu apa pun bisa dipasang.
Contohnya, AI Server Workstation berbasis Dell Precision 7875 memakai pendekatan paket NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition dengan memori 96 GB GDDR7 ECC dan daya GPU 300 W, sesuai model yang dinyatakan didukung oleh Dell. Harga mulai sekitar 700,000 THB. CPU, RAM, SSD, PSU, dan ruang lingkup layanan harus dikonfirmasi dalam surat penawaran harga; ini bukan RTX 6000 Ada atau versi Workstation 600 W [2][3]
Membeli kartunya saja mungkin belum selesai
Sebelum memesan GPU, periksa panjang, ketebalan, jumlah slot yang terhalang, konektor daya, aliran pendinginan, BIOS, sistem operasi, dan driver, termasuk syarat garansi untuk seluruh unit. Kartu yang bisa masuk ke slot tidak berarti sistemnya mendukung sepenuhnya.
Mulailah memilih GPU dari memorinya, lalu lihat kecepatannya
VRAM ibarat meja kerja GPU: model, data sementara, dan pekerjaan yang sedang berjalan harus bisa diletakkan dengan cukup ruang. Sedangkan bandwidth adalah kecepatan mengambil data di atas meja itu. Kapasitas membantu agar pekerjaan bisa dimuat, tetapi bukan angka kecepatan. Membandingkan GPU harus memakai model, precision, dan perangkat lunak yang sama; jangan membandingkan nilai AI TOPS pada precision yang berbeda atau pada kondisi sparsity yang berbeda.
Contoh keluarga GPU untuk membaca spesifikasi, bukan peringkat kecepatan
| Keluarga/model contoh | Memori menurut model | Dipakai untuk mempertimbangkan hal apa |
|---|---|---|
| GeForce RTX 5060 Ti | Tersedia versi 8 GB dan 16 GB | Pilih SKU yang tepat; meski nama modelnya mirip, kapasitasnya bisa berbeda |
| GeForce RTX 4090 / RTX 5090 | 24 GB / 32 GB | Kartu tunggal untuk pekerjaan pengembangan, gambar, dan LLM yang sudah diukur bahwa bisa dimuat; periksa daya dan ukuran kartunya |
| RTX 6000 Ada | 48 GB ECC | Kartu profesional ini model yang berbeda dari RTX PRO 6000 Blackwell |
| RTX PRO 5000 Blackwell | Tersedia versi 48 GB dan 72 GB ECC | Baca nama sub-modelnya dan datasheet-nya; jangan menganggap semua kartu punya kapasitas yang sama |
| RTX PRO 6000 Blackwell | 96 GB ECC | Workstation, Max-Q, dan Server Edition punya persyaratan daya/pendinginan yang berbeda |
| GPU pusat data, misalnya H100 / H200 | H100 tersedia versi 80 GB; H200 141 GB | Pilih keseluruhan sistem dan form factor; NVLink/jaringan/produsen unit berpengaruh pada penskalaan |
Contoh spesifikasi yang diperiksa pada 14 November 2569, bukan daftar barang siap kirim atau jaminan performa [3][4][5][6][7][8][20][23]
Berapa VRAM-nya, dan pekerjaan seperti apa yang bisa mulai dijalankan
Panduan untuk mulai bereksperimen; model card dan benchmark harus diperiksa sebelum membeli
| Rentang VRAM per GPU | Contoh pekerjaan yang dipakai untuk diuji | Hal yang perlu diwaspadai |
|---|---|---|
| 8–12 GB | Belajar AI, inference model gambar berukuran kecil, LLM kecil yang sudah di-quantize | context, resolusi gambar, dan batch punya ruang yang terbatas |
| 16–24 GB | Mencoba LLM 7B–8B yang sudah di-quantize, pekerjaan pembuatan gambar pada sebagian pipeline, LoRA pada sebagian model | LoRA tidak membuat semua model bisa dimuat; model dan pengaturannya sangat berpengaruh |
| 32–48 GB | Menguji LLM 14B–32B yang sudah di-quantize, atau menambah ruang untuk pekerjaan gambar/pelatihan tambahan | Bobot model bisa dimuat pun masih perlu menyisakan ruang untuk KV cache dan runtime |
| 72–96 GB | Menguji LLM 70B yang sudah di-quantize atau pekerjaan yang membutuhkan ruang lebih besar | Jumlah pengguna dan kecepatan respons masih harus diukur; context yang panjang menambah kebutuhan memori |
| Multi-GPU / GPU pusat data | Model yang tidak cukup dijalankan dengan satu kartu, pekerjaan training, atau beberapa layanan sekaligus | Perangkat lunak harus mendukung pembagian beban kerja dan topology-nya harus sesuai |
Ini adalah titik awal untuk bereksperimen, bukan spesifikasi minimum yang dijamin. Model dengan nama yang mirip bisa menggunakan memori dalam jumlah yang berbeda, dan melakukan offload ke RAM berarti menukarnya dengan waktu transfer data [10][11][12]
Menghitung kebutuhan ruang model LLM secara mudah dipahami
B berarti jumlah parameter dalam satuan miliar. Bobot model saja dapat diperkirakan dari jumlah parameter × jumlah bit per parameter ÷ 8. Contoh: 8B pada BF16/FP16 menggunakan 8 × 2 = 16 GB, sedangkan pada 4-bit menggunakan sekitar 8 × 0.5 = 4 GB. Tabel ini menggunakan GB basis sepuluh, dan belum termasuk metadata dari quantization, KV cache, activation, runtime, serta ruang untuk sistem [10][11]
Bobot model saja: dihitung untuk menyusun anggaran memori
| Contoh model | BF16/FP16: 2 bytes | 8-bit: 1 byte | 4-bit: 0.5 byte |
|---|---|---|---|
| 8B | 16 GB | 8 GB | 4 GB |
| 14B | 28 GB | 14 GB | 7 GB |
| 32B | 64 GB | 32 GB | 16 GB |
| 70B | 140 GB | 70 GB | 35 GB |
Angka-angka ini adalah perhitungan untuk penjelasan, bukan VRAM minimum yang siap dipakai, dan bukan hasil benchmark dari model tertentu
Jadi, model 70B dalam format 4-bit yang bobotnya dihitung sebesar 35 GB tidak berarti GPU 40 GB bisa langsung melayani banyak orang sekaligus. Harus ada ruang tersisa untuk konteks pertanyaan dan jawaban setiap pekerjaan, termasuk untuk kerja inference engine. Menurunkan jumlah bit memang membantu mengurangi kebutuhan ruang, tetapi kualitas jawaban dan kecepatannya juga harus diuji; jangan memilih hanya berdasarkan kapasitas saja
Menggunakan model, melatih tambahan, dan melatih ulang membutuhkan perangkat yang tidak sama
Pisahkan jenis pekerjaan sebelum memilih spesifikasi
| Pekerjaan | Apa yang terjadi | Hal yang perlu disiapkan cadangannya |
|---|---|---|
| Inference | Memuat bobot lalu melakukan prediksi atau menjawab pertanyaan | bobot + cache + activation + runtime |
| LoRA / QLoRA | Melatih sebagian parameter tambahan; QLoRA menggunakan bobot utama dalam bentuk quantized | Masih memerlukan base model, activation, dan optimizer untuk bagian yang dilatih |
| Full fine-tuning | Memperbarui parameter utama dari model | gradients, optimizer states, salinan bobot, dan activation memakai ruang tambahan |
| Training from scratch | Mempelajari bobot baru dari sebuah set data | Data berkualitas tinggi, waktu compute, sistem checkpoint, dan percobaan berulang kali |
Tidak ada satu pengali VRAM tunggal yang berlaku untuk semua framework, optimizer, precision, sequence length, atau cara pembagian model [12][13]
Untuk pekerjaan berbasis gambar, pekerjaan inspeksi komponen/klasifikasi gambar harus dipisahkan dari pekerjaan pembuatan gambar dengan diffusion dan pekerjaan pembuatan video. Menambah resolusi, batch, atau jumlah frame membuat kebutuhan ruang dan waktu pemrosesan meningkat. Karena itu, membuat gambar dengan batch kecil dan melatih model gambar menggunakan spesifikasi pada tingkat yang berbeda. Teknik pengurangan memori seperti offload, tiling, atau checkpointing mungkin membantu dengan menukarnya dengan kecepatan; perlu melihat panduan pipeline yang benar-benar digunakan [14]
Berapa banyak RAM utama yang sebaiknya dimiliki
RAM pada komputer terpisah dari VRAM pada kartu, kecuali pada platform dengan memori bersama seperti DGX Spark. Tugas RAM adalah mendukung sistem operasi, program penyiapan data, database/cache, dan data selama proses memuat model. Memiliki RAM yang banyak tidak membuat VRAM bertambah secara otomatis, dan memindahkan sebagian model ke RAM bisa terhambat oleh bandwidth antara CPU/GPU
- Buat catatan pembukuan memori: sistem dan layanan dasar + data loader/gambar yang sedang disiapkan + database/cache + fase memuat model atau offload + pekerjaan lain yang berjalan bersamaan + ruang cadangan
- Contoh hipotetis: sistem 16 GB + penyiapan data 24 GB + cache/database 16 GB + fase memuat/cadangan pekerjaan 32 GB = 88 GB, sehingga pertimbangkan kapasitas yang lebih besar dari itu, misalnya 128 GB, lalu ukur peak yang sebenarnya. Ini bukan aturan bahwa setiap komputer harus 128 GB
- Jika menjalankan banyak layanan atau memuat dataset besar secara bersamaan, mungkin perlu mempertimbangkan 256 GB atau lebih, tetapi harus dihitung dari daftar penggunaan yang nyata, jangan memakai rumus RAM = VRAM × 2 tanpa melihat jenis pekerjaannya
- Periksa versi DDR yang didukung, ECC UDIMM/RDIMM, jumlah slot memori, dan cara memasang DIMM sesuai panduan. Memasang beberapa modul RAM pada slot yang salah bisa membuat bandwidth tidak sesuai harapan
Kapasitas dan jumlah slot memori adalah dua hal yang berbeda
RAM dengan kapasitas total sama dapat memberikan bandwidth berbeda ketika sebagian kanal memori kosong dibandingkan pemasangan yang tersebar sesuai kanal. Periksa panduan pemasangan CPU dan motherboard, jenis DIMM, jumlah modul, serta kecepatan yang didukung pada konfigurasi sebenarnya.
ECC adalah mekanisme untuk mendeteksi dan memperbaiki beberapa jenis kesalahan memori, bukan jaminan bahwa data tidak akan pernah rusak. UDIMM dan RDIMM adalah jenis memori yang berbeda; pemilihannya harus mengikuti platform, bukan hanya berdasarkan kapasitas dan generasi DDR yang sama.
Pipeline: data melewati apa saja
Bandwidth adalah jumlah data yang dapat dikirim per detik, sedangkan latency adalah waktu tunggu setiap pekerjaan. Keduanya penting. Meski jalannya lebar, jika ada tahapan yang harus menunggu satu per satu, responsnya bisa tetap lambat. Pada beban LLM, fase membaca prompt yang panjang dan fase menghasilkan jawaban satu token demi satu token memiliki perilaku yang berbeda, jadi sebaiknya ukur prefill dan decode secara terpisah [11]
Pahami satuannya dengan benar sebelum membandingkan sistem
| Jalur penghubung | Contoh batas teoretis | Pertanyaan yang perlu diajukan |
|---|---|---|
| PCIe 4.0 ×16 | Sekitar 31.5 GB/s per arah | Terpasang pada slot ×16, tetapi berapa lane yang benar-benar terhubung secara elektrik? |
| PCIe 5.0 ×16 | Sekitar 63 GB/s per arah | Apakah CPU, motherboard, dan perangkatnya mendukung generasi yang sama? |
| Ethernet 10 / 25 / 100 Gbps | Sekitar 1.25 / 3.125 / 12.5 GB/s sebelum overhead | Apakah switch, kabel, NIC, dan Storage di sisi tujuan sudah cukup cepat? |
| GPU memory bandwidth | Baca dari datasheet GPU tersebut | Ini adalah kecepatan di dalam memori, bukan PCIe atau kecepatan jaringan |
GB/s dalam satuan byte, sedangkan Gbps dalam satuan bit; 8 bits = 1 byte. Angka PCIe sudah memperhitungkan pengodean link, tetapi belum mengurangi protocol overhead dan bukan kecepatan nyata saat digunakan [16]
Contoh hipotetis: jika kumpulan data yang siap digunakan berukuran 100 GB dan jalur penghubung 10 Gbps memberi batas 1.25 GB/s, maka waktu minimum secara teoretis hanya untuk transfer adalah 100 ÷ 1.25 = 80 detik. Kenyataannya lebih lambat dari ini karena overhead, banyaknya berkas kecil, CPU, dan disk. Jadi jangan membeli NIC yang lebih cepat tanpa memeriksa apakah bagian lain mampu mengimbangi.
CPU dan motherboard: lihat lane, bukan hanya slotnya
CPU membantu membaca berkas, mendekode gambar, melakukan tokenize teks, menyusun batch, dan menangani layanan lain. Jumlah core yang banyak membantu pada sebagian pekerjaan, tetapi perangkat lunaknya harus mampu memanfaatkan core tersebut. Motherboard harus memiliki slot yang benar-benar tersedia sekaligus lane PCIe yang diberikan oleh CPU/chipset, bukan sekadar melihat slot panjang ×16 lalu menganggap semua slot mendapat ×16.
- Baca block diagram: slot mana yang terhubung langsung ke CPU, slot mana yang melalui chipset, dan perangkat mana yang berbagi lane dengan M.2/NIC
- Contoh perencanaan: 4 GPU ×16 = 64 lane; 2 NVMe ×4 = 8 lane; NIC ×8 = 8 lane, total 80 lane menurut asumsi ini. Perlu memeriksa perutean lane yang sebenarnya, termasuk perangkat yang sudah terpasang pada board
- Periksa ukuran dan jarak antar kartu: kartu yang memakan 3 slot bisa menutupi slot lain, meskipun jumlah lane totalnya cukup
- PCIe bifurcation dan riser harus didukung oleh CPU, BIOS, motherboard, dan perangkatnya, bukan sekadar membeli kabel pemecah lalu semua mesin bisa menggunakannya
Tidak selalu harus ada 2 CPU untuk menggunakan 4 GPU. Sebagai contoh, Threadripper PRO pada platform WRX90 mendukung hingga 128 PCIe 5.0 lanes dan memori 8 channels dalam sistem soket tunggal, tetapi jumlah kartu yang benar-benar dapat dipasang masih bergantung pada motherboard, casing, daya, dan sertifikasi dari pabrikan [17] Dell Precision 7875 memiliki tata letak slot tersendiri, jadi jangan menyimpulkan bahwa karena CPU memiliki banyak lane maka model mesin ini akan mendukung empat GPU [22]
Apa manfaat dua CPU, dan apa itu NUMA
Mesin dua soket mungkin menambah jumlah core, kapasitas RAM, dan sumber daya I/O tergantung platformnya, tetapi bukan berarti semua bandwidth bisa dijumlahkan lalu setiap pekerjaan menjadi dua kali lebih cepat. Setiap CPU memiliki memori dan perangkat yang berada dekat dengannya. Mengakses sisi CPU yang lain harus melalui link antar soket. Konsep ini disebut NUMA [15]
CPU A
- RAM sisi AMemori yang diakses langsung oleh CPU A
- GPU 0 dan GPU 1Contoh GPU yang terhubung ke PCIe root milik A
CPU B
- RAM sisi BMemori yang diakses langsung oleh CPU B
- GPU 2 dan GPU 3Contoh GPU yang terhubung ke PCIe root milik B
Link antar CPU: bisa menyeberang ke sisi lain, tetapi ada biaya waktu dan bandwidth
Perlu membaca topology mesin yang sebenarnya. Beberapa sistem memiliki PCIe switch dan perutean lane yang berbeda dari contoh ini. Sebaiknya ikat pekerjaan dan memori agar dekat dengan GPU yang digunakan sesuai kebutuhan
Dua CPU cocok ketika beban CPU, RAM, atau I/O memang membutuhkan tambahan sumber daya, dan sistem operasi serta perangkat lunaknya mampu menjadwalkan pekerjaan dengan tepat. Jika pekerjaan sebagian besar menunggu GPU dan kartu yang digunakan tidak banyak, sistem dengan satu CPU yang memiliki cukup lane mungkin lebih mudah dikelola. Periksa topology dengan alat bawaan sistem dan lakukan benchmark sebelum memutuskan.
Bagaimana cara menggunakan beberapa GPU — menancapkannya saja tidak langsung menggabungkan VRAM
Tiga cara menggunakan beberapa GPU
| Cara | Gambaran umum | Hal yang dipertukarkan |
|---|---|---|
| Memisahkan beban kerja / menggandakan layanan | Setiap GPU menjalankan model yang muat di dalamnya sendiri, lalu permintaan didistribusikan | Menambah kapasitas menerima pekerjaan secara keseluruhan, tetapi satu set model tetap harus muat per kartu |
| Data parallel training | Setiap GPU berlatih dengan batch data yang berbeda, lalu bertukar gradients | Perlu komunikasi antar-GPU dan pengaturan batch/optimizer yang sesuai |
| Tensor / pipeline parallel | Membagi model atau pekerjaan di dalam satu model ke beberapa GPU | Membantu jika satu kartu saja tidak cukup, tetapi menambah komunikasi dan bergantung pada engine |
Dua GPU 24 GB tidak otomatis menjadi satu GPU 48 GB; model sharding dan batasan masing-masing kartu tetap harus diperiksa [18][19]
Periksa apakah kartu mendukung NVLink atau tidak, jangan berasumsi dari nama RTX atau harga. Jika menggunakan PCIe, Anda harus melihat jalur antar-GPU dan dukungan peer-to-peer dari keseluruhan sistem. Untuk konfigurasi beberapa mesin, jaringan menjadi bagian dari perhitungan: perlu memperhatikan NIC, switch, RDMA sesuai perangkat lunaknya, serta penempatan GPU/NIC. Memiliki port 100 Gbps bukan jaminan bahwa sistem akan scale dengan baik [18]
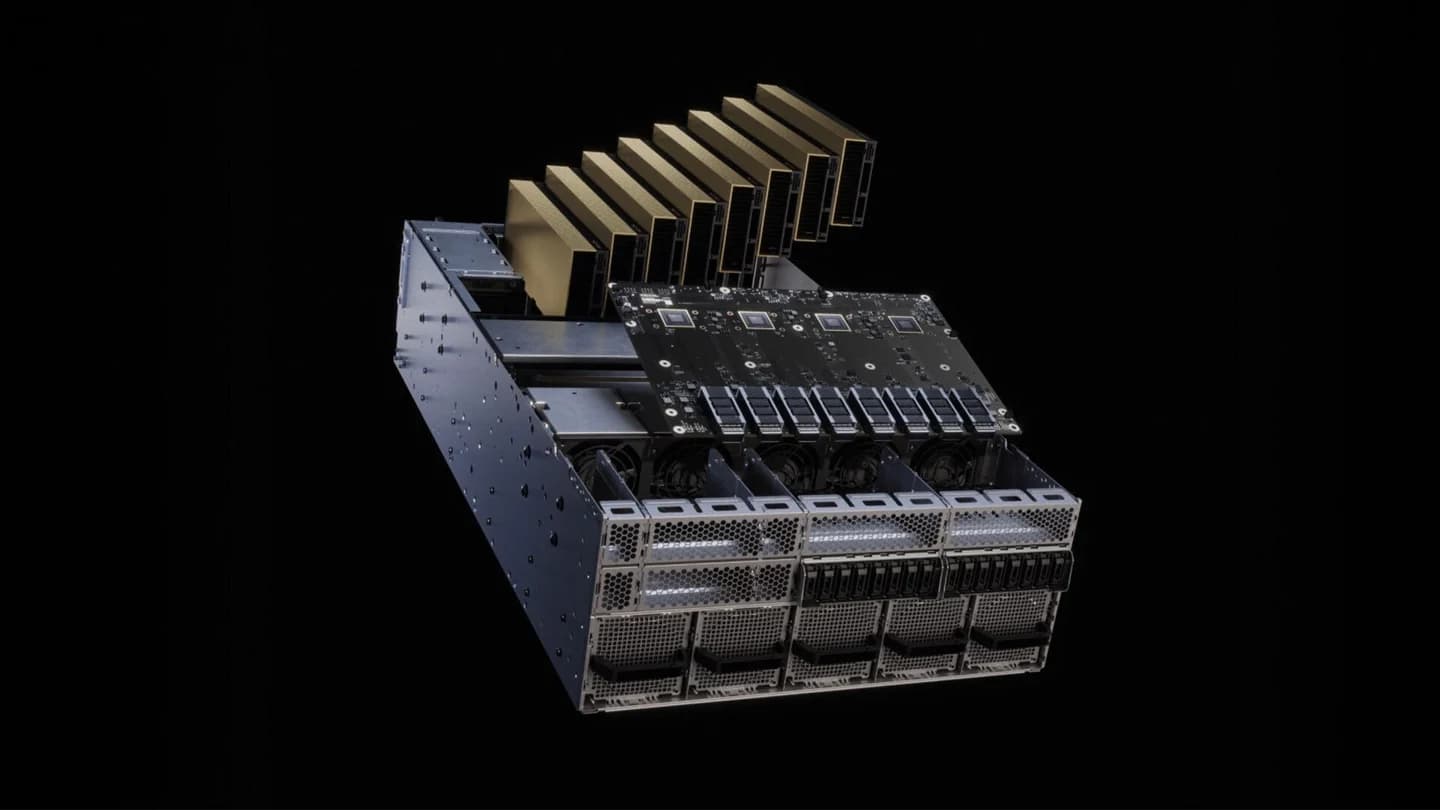
NVLink adalah jalur penghubung berkecepatan tinggi antar-GPU pada sistem yang mendukungnya, sedangkan RDMA membantu mesin yang mendukungnya mengirim dan menerima data melalui jaringan dengan mengurangi sebagian pekerjaan penyalinan oleh CPU. Keduanya memerlukan dukungan baik dari perangkat keras maupun perangkat lunak, dan bukan fitur yang dimiliki setiap GPU atau setiap port jaringan [18]
Mendukung berapa banyak pengguna — apa saja yang perlu diperhatikan
Pisahkan “orang yang memiliki akun” dari “permintaan yang sedang diproses”. Misalnya, sebuah organisasi memiliki banyak akun, tetapi orang yang bertanya secara bersamaan mungkin sedikit; atau penggunanya sedikit tetapi setiap kali mengirim dokumen panjang sehingga bisa memakai lebih banyak sumber daya. Untuk LLM, perhatikan ukuran model, precision, panjang input/output, jumlah permintaan bersamaan, KV cache, dan mekanisme batching [11]
- TTFT: waktu sejak pertanyaan dikirim sampai token pertama diterima, termasuk waktu menunggu di antrean
- Kecepatan jawaban: tokens/s per permintaan dan total waktu sampai jawaban selesai, bukan hanya melihat angka total mesin
- Throughput: total pekerjaan atau token per detik di bawah beban uji yang ditentukan
- P95 latency: nilai durasi di mana 95 dari 100 permintaan selesai tidak lebih lambat dari nilai ini, dipakai untuk melihat gejala lambat saat banyak orang mengakses bersamaan [21]
- Kesalahan dan kualitas: out-of-memory, timeout, jawaban yang tidak sesuai pertanyaan, dan pemisahan hak akses dokumen
Contoh hipotetis untuk perhitungan: jika hasil pengukuran adalah 120 output tokens/s total pada satu beban uji, dan Anda menginginkan rata-rata 20 output tokens/s per permintaan, maka pembagian 120 ÷ 20 = 6 hanya dipakai sebagai titik awal untuk menguji sekitar 6 permintaan bersamaan. Ini bukan jaminan mendukung 6 orang, karena prefill, KV cache, batching, dan panjang jawaban membuat hasilnya berubah. Anda perlu menguji concurrency pada beberapa tingkat dengan prompt nyata dan kriteria waktu tunggu yang telah disepakati
Hasil pengujian yang sebaiknya diminta bersama penawaran harga
Sebutkan nama dan versi model, quantization/context, contoh pertanyaan, panjang jawaban, concurrent requests, TTFT, P95, throughput, dan peak memory beserta versi perangkat lunaknya, agar mesin dapat dibandingkan dengan beban kerja yang sama — jangan memakai jumlah pengguna tanpa syarat yang menyertainya
Power Supply, panas, dan ruang pemasangan
Buat perhitungan daya untuk keseluruhan sistem: GPU + CPU + RAM + SSD/NIC + motherboard dan kipas, lalu sisakan cadangan untuk perubahan beban yang tiba-tiba dan untuk persyaratan produsen. Angka TDP atau GPU power bukan nilai yang terukur di colokan listrik untuk seluruh mesin; efisiensi PSU dan beban kerja berpengaruh pada daya yang sebenarnya
Contoh hipotetis, bukan spesifikasi rakitan siap pakai maupun spesifikasi Dell 7875: 4 kartu GPU × 300 W = 1.200 W; CPU 350 W; RAM/Storage/board/kipas diasumsikan total 200 W, sehingga beban di sisi perangkat adalah 1.750 W sebelum cadangan. Anda harus memeriksa PSU, konektor, kabel daya, dan daya yang benar-benar didukung — jangan membeli PSU 1.750 W langsung berdasarkan hasil penjumlahan ini. Empat kartu 600 W saja sudah menghasilkan total 2.400 W hanya untuk GPU, sehingga itu persoalan yang berbeda dari mesin dengan satu kartu
- Periksa konektor dan kabel yang ditentukan produsen; jangan memakai kabel konverter atau pencabang tanpa sertifikasi
- PSU redundan harus diperiksa mode redundancy-nya: dua unit tidak berarti seluruh daya gabungannya dapat dipakai sambil tetap tahan terhadap kerusakan satu unit PSU
- Kartu dengan passive cooling memerlukan airflow chassis sesuai persyaratan; jangan dipasang di casing biasa lalu berharap mengandalkan kipas PSU
- Periksa colokan, sirkuit listrik, UPS (baik satuan W/VA maupun waktu cadangannya), serta panas, kebisingan, dan ruang untuk servis mesin bersama pengelola gedung
Biaya listrik dihitung dari daya rata-rata yang terukur: contoh hipotetis 1 kW × 8 jam × 30 hari = 240 kWh, lalu dikalikan tarif listrik yang sebenarnya. Angka ini belum termasuk sistem pendingin, jadi sebaiknya ukur baik kondisi idle maupun beban kerja yang rutin digunakan sebelum membandingkan biaya membeli atau menyewa
Storage menyimpan apa, dan harus secepat apa
Pisahkan data sebelum memilih SSD dan sistem pencadangan
| Yang disimpan | Karakteristik penggunaan | Yang sebaiknya dipilih |
|---|---|---|
| Sistem dan program | OS, containers, libraries | Ruang untuk pembaruan dan pemulihan; pisahkan dari data penting bila sesuai |
| Model dan checkpoint | Berkas besar dalam beberapa versi, dimuat saat mulai atau disimpan selama pelatihan | Kapasitas, laju baca/tulis berkelanjutan, dan ruang untuk versi yang bisa dikembalikan |
| Dataset gambar/video/dokumen | Berkas besar atau banyak berkas kecil | Perhatikan baik throughput maupun IOPS, termasuk pola data-loader |
| Basis data/vector index/log | Baca-tulis berukuran kecil dan mungkin memuat data sensitif | latency, endurance, hak akses, dan kebijakan penyimpanan data |
| Backup | Salinan yang terpisah dari mesin utama | Versi, enkripsi, uji pemulihan, dan hak bagi pihak yang mengakses |
RAID membantu pada sebagian kasus disk rusak, tetapi tidak menggantikan backup untuk penghapusan yang salah, ransomware, atau kerusakan seluruh mesin
Contoh hipotetis: dataset 500 GB + model/checkpoint 400 GB + cache 200 GB + sistem dan log 100 GB = 1,200 GB sebelum menyisakan ruang untuk pertumbuhan, sehingga Anda perlu memilih kapasitas pakai nyata yang lebih besar dari ini dan memperhitungkan backup secara terpisah. Jangan mencampuradukkan kapasitas mentah dengan usable capacity setelah RAID/format, dan jangan menilai pekerjaan berkas kecil hanya dari satu angka kecepatan sequential tertinggi
Susun spesifikasi awal, lalu uji sebelum memesan
Rancangan awal untuk mulai berdiskusi dengan penyusun sistem, bukan sekumpulan jaminan performa
| Situasi | Pendekatan awal | Syarat sebelum memesan |
|---|---|---|
| Belajar atau mengembangkan AI di meja kerja | DGX Spark atau PC dengan GPU 16–24 GB sesuai perangkat lunaknya | Periksa Arm64/x86, model, dan kecepatan yang dapat diterima |
| Tim yang mengerjakan gambar dan LLM di dalam organisasi | Workstation GPU 32–96 GB; hitung RAM/SSD dari daftar data | Uji pipeline nyata dan penggunaan bersamaan dengan layanan lain |
| Beberapa tim / model besar / pekerjaan pelatihan berkelanjutan | Sistem multi-GPU atau multi-node yang disertifikasi produsen | Perhatikan topology, network, power/cooling, perawatan, dan benchmark seluruh sistem |
Ukuran VRAM bukan jaminan kesesuaian; Anda harus mulai dari versi model dan kriteria penerimaan Anda sendiri
- 1
Tuliskan kebutuhan dan kriteria penerimaan pekerjaan
Sebutkan model, pekerjaan nyata, jumlah pengguna bersamaan, waktu tunggu yang dapat diterima, dan ketentuan data
- 2
Buat anggaran memori
Pisahkan bobot model, cache activation, dan RAM untuk pekerjaan pendukung, lalu ukur peak dalam percobaan
- 3
Gambarkan jalur data
Telusuri Storage → CPU/RAM → PCIe → GPU, termasuk jaringan dan basis data, lalu periksa titik hambatan satu per satu
- 4
Periksa mesin secara keseluruhan
Baca manual CPU, mainboard, DIMM, slot, PSU, konektor, sistem aliran udara, dan daftar yang didukung produsen
- 5
Uji dulu, baru rampungkan penawaran harga
Gunakan kumpulan data dan concurrency nyata, catat kualitas, waktu respons, daya, dan memori, lengkap dengan rencana perluasan serta cakupan perawatan
Jika Anda ingin melakukan penilaian bersama tim Inspektion, siapkan nama model atau jenis pekerjaan, contoh data, jumlah permintaan bersamaan, waktu tunggu yang dapat diterima, dan batasan lokasi, lalu lihat DGX Spark, Dell AI Workstation atau gambaran umum Modern Data untuk memilih titik awal yang sesuai dengan sistem Anda. Untuk pekerjaan pencarian dokumen, bacaan lanjutannya ada di Enterprise KM Chatbot
Pertanyaan yang Sering Diajukan
DGX Spark atau Workstation, mana yang cocok untuk pemula?
Lihat jenis pekerjaan dan perangkat lunak yang perlu digunakan. DGX Spark cocok untuk pengembangan dan eksperimen AI pada mesin kecil dengan memori bersama yang besar, tetapi perlu memeriksa Arm64. Sedangkan pada Workstation, GPU dan komponennya dapat dipilih sesuai platform. Kedua pilihan tersebut harus diuji dengan model yang sebenarnya sebelum menentukan jumlah pengguna.
Apakah dua GPU 24 GB bisa menggantikan satu GPU 48 GB?
Tidak secara otomatis. Diperlukan perangkat lunak yang dapat membagi model atau beban kerja antar GPU, serta perlu memeriksa memori per kartu dan jalur komunikasinya. Cara lainnya adalah membiarkan setiap GPU menjalankan set layanan yang berbeda agar dapat menerima total beban kerja yang lebih banyak.
Apakah menambah RAM membantu menjalankan LLM yang lebih besar dari VRAM?
Beberapa engine mendukung offload ke RAM, tetapi ada biaya transfer data dan responsnya bisa menjadi lebih lambat. Perlu memeriksa dukungannya dan melakukan pengukuran yang sebenarnya. RAM yang banyak tidak membuat GPU memory bertambah, kecuali pada sistem memori bersama yang harus dipertimbangkan dengan cara yang berbeda.
Apakah harus ada dua CPU agar bisa memasang empat GPU?
Tidak selalu diperlukan. Beberapa model platform dengan satu CPU memiliki lane PCIe yang memadai. Perlu memeriksa motherboard, lebar slot, kartu yang didukung, sistem kelistrikan dan panas. Sedangkan untuk mesin dengan dua CPU, perlu memperhatikan NUMA dan posisi GPU/RAM juga.
Harga mulai 300,000 dan 700,000 THB mencakup apa saja?
Ini adalah harga perkiraan awal untuk penawaran DGX Spark dan Dell AI Workstation secara berurutan. Rincian perangkat keras, perangkat lunak, instalasi, pajak, garansi, dan pengiriman dikonfirmasi dalam surat penawaran harga. Bukan harga tetap maupun jaminan atas jumlah pengguna.
Referensi
- [1]
DGX Spark: specifications and workloads — NVIDIA (diakses 2026-11-14)
- [2]
Precision 7875 Tower: graphics options — Dell (diakses 2026-11-14)
- [3]
RTX PRO 6000 Blackwell Max-Q Workstation Edition — NVIDIA (diakses 2026-11-14)
- [4]
GeForce RTX 5060 family — NVIDIA (diakses 2026-11-14)
- [5]
GeForce RTX 5090 — NVIDIA (diakses 2026-11-14)
- [6]
RTX 6000 Ada Generation — NVIDIA (diakses 2026-11-14)
- [7]
RTX PRO 5000 Blackwell — NVIDIA (diakses 2026-11-14)
- [8]
H200 Tensor Core GPU — NVIDIA (diakses 2026-11-14)
- [9]
RTX PRO 6000 Blackwell Server Edition — NVIDIA (diakses 2026-11-14)
- [10]
Quantization with bitsandbytes — Hugging Face (diakses 2026-11-14)
- [11]
Optimization and Tuning — vLLM (diakses 2026-11-14)
- [12]
Memory anatomy of model training — Hugging Face (diakses 2026-11-14)
- [13]
Parameter-efficient fine-tuning: quantization — Hugging Face (diakses 2026-11-14)
- [14]
Reduce memory usage for diffusion pipelines — Hugging Face (diakses 2026-11-14)
- [15]
Performance Tuning Guide: data loading and NUMA — PyTorch (diakses 2026-11-14)
- [16]
PCIe bandwidth per direction after encoding overhead — PCI-SIG (diakses 2026-11-14)
- [17]
AMD Ryzen Threadripper PRO processors — AMD (diakses 2026-11-14)
- [18]
Distributed serving — vLLM (diakses 2026-11-14)
- [19]
DistributedDataParallel — PyTorch (diakses 2026-11-14)
- [20]
GeForce RTX 4090 specifications — NVIDIA (diakses 2026-11-14)
- [21]
LLM Benchmarking: Fundamental Concepts — NVIDIA (diakses 2026-11-14)
- [22]
Precision 7875 Tower: internal slots — Dell (diakses 2026-11-14)
- [23]
HGX GPU memory and platform specifications — NVIDIA (diakses 2026-11-14)