用途に合ったAIサーバーの選び方:小型機から複数GPU構成まで
Inspektionのエンジニアチーム · 公開 2026年11月14日 · 最終更新 2026年11月14日
小型から大型までのAIサーバー選定ガイド。DGX SparkとWorkstationを比較し、GPU、VRAM、RAM、CPU、PCIe、Storage、電源を解説。同時利用者数の見積もり方法も紹介。
要約
- まず用途とモデルから始め、必要なメモリ量を計算してからGPUを選びます。本体価格だけを出発点にしないでください。
- DGX Sparkの128 GB unified memoryは独立したグラフィックスカードのVRAMではなく、PCのようにGPUを増設することもできません。
- 複数GPUを使うには対応するソフトウェアとtopologyが必要で、VRAMが自動的に合算されるわけではありません。
- 利用者数は同時リクエスト数、context、応答時間から測るべきで、GPUの規模という一つの値だけで決まるものではありません。
- RAM、Storage、PCIe、network、電源、発熱をシステム全体で確認し、発注前にテストを行いましょう。
グラフィックスカードの名前ではなく、用途から始める
AIサーバーの選定はPCの組み立てに似ていますが、モデルのサイズ、データ転送速度、同時に発生する処理の数すべてを見る必要があります。モデルを読み込めるマシンでも、利用者への応答が間に合わないことがあり、データがStorage、CPU、ネットワークで詰まっている場合はGPUを増やしてもあまり役に立ちません。この記事では小型機、中型機、大型機を使い方のパターンに沿って分けており、メーカーによるサイズの標準規格ではありません。
- 用途を定める:既存のモデルを使うのか、既存のモデルに追加学習をするのか、新しいモデルを一から学習させるのか。
- データを定める:テキスト、画像、動画、または複数種類か。質問の長さ、画像の解像度、ファイル数も含めます。
- 許容できる時間を定める:即時に応答する必要があるか、処理を待ち行列に入れられるか、夜間にバッチで処理できるか。
- 同時の人数と処理数を定める:アカウントの総数は、マシンが実際に処理しているリクエスト数と同じではありません。
この記事全体で使う用語
Inference = モデルを使って応答や予測を行うこと、Training = モデルを学習させること、Fine-tuning = 既存のモデルに追加学習をすること、VRAM = GPU上のメモリ、RAM = メインメモリ、Token = モデルが処理するテキストの単位で、タイ語の単語数と一対一で対応するものではありません。 CPUはデータの準備と処理の制御を担う主処理装置で、GPUは多くの計算を並列に行うことに適しています。Batchはまとめて処理するデータの集まり、Contextはモデルが回答に使う文脈です。Quantizationはモデルの重みを表すビット数を減らしてメモリを節約する手法で、出力品質の再確認が必要です。
小型機、中型機、大型機はどこが違うのか
使い方に合ったマシンの形態を選ぶ
| この記事での規模 | 出発点として適した用途 | 利点 | 制約 |
|---|---|---|---|
| 小型:DGX Spark | 開発、モデルの試験、および範囲を検証済みの社内AI業務 | コンパクトな筐体で、大容量の共有メモリとAIソフトウェア一式を備える | PCのようにGPUカードを増設できない。Arm64への対応と実際の業務での速度を確認すること。 |
| 中型:PC / Workstation + GPU | 画像処理、LLM、および十分なGPUを選べる追加学習 | プラットフォームに応じてカード、RAM、SSDを選べる。複数ノードのマシンより管理が容易。 | スロット、PCIeレーン、電源、発熱によりカードの枚数が制限される |
| 大型:GPU Server / 複数ノード | 複数チームでの利用、大規模モデル、または拡張が必要な学習とサービス提供 | GPU、ネットワーク、電源システム、データセンター級の運用管理をまとめて設計できる | 設置スペース、冷却システム、運用チームが必要。複数GPUにしても、必ずしも枚数に比例して速くなるわけではありません。 |
筐体の大きさ、価格、GPUの枚数だけでは、業務を処理できる能力を示すテスト結果にはなりません。
DGX Sparkは何のために生まれたのか
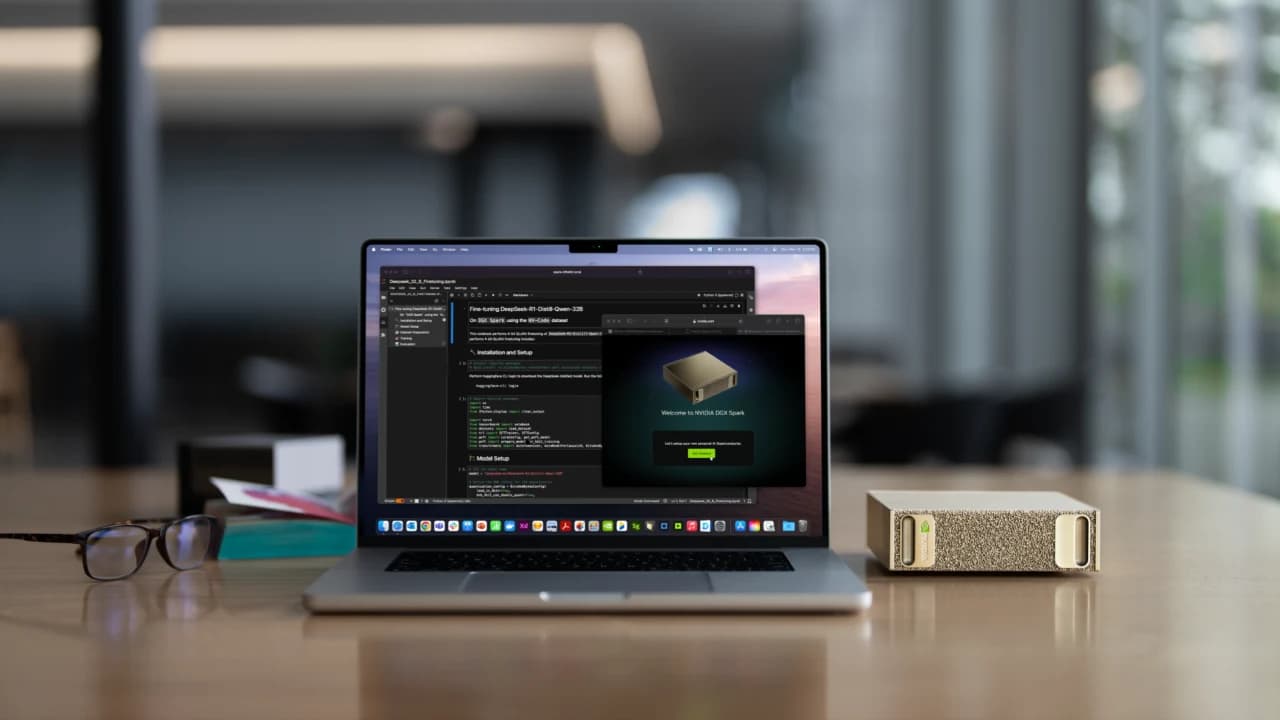
NVIDIA DGX Sparkは GB10 Grace Blackwell Superchip を採用し、ArmベースのCPUと、CPU/GPU向けの128 GBの共有メモリを備えています。特長は、複数カード構成のマシンを組み立てることから始めずに、デスク上でモデルの開発、試験、調整、実運用への適用ができる点です。スペック上のメモリ帯域幅は273 GB/sのため、容量と速度の両方を見る必要があり、128 GBをVRAM 128 GBのカードと同じだと解釈しないでください [1]
- LLMの試験、文書検索アシスタント、AI開発業務、組織内でのモデル評価に適しており、大型機へ拡張する前の段階として使えます。
- 共有メモリによりCPU/GPUが同じ領域を使いますが、オペレーティングシステムや他のプログラムもこの領域を使うため、モデル用に128 GBがそのまま残るわけではありません。
- フレームワーク、コンテナ、ライブラリ、拡張機能がArm64とこのGPUに対応しているか確認する必要があります。従来のx86向けソフトウェアは、すべてがそのまま移行して使えるわけではありません。
- 多数のユーザーへの対応や、大規模モデルをゼロから学習させることに対する自動的な答えになるわけではありません。実際の応答時間と処理量を測定する必要があります。
NVIDIA DGX Spark上の小規模AIサーバーをご覧ください。開始価格は約300,000 THBで、これはInspektionの提案における初期予算であり、NVIDIAの世界共通の小売価格ではありません。ハードウェア、ソフトウェア、設置、税金、保証、納期の各項目は見積書に従って確定します。
PCとワークステーション:用途に合ったGPUを選ぶ
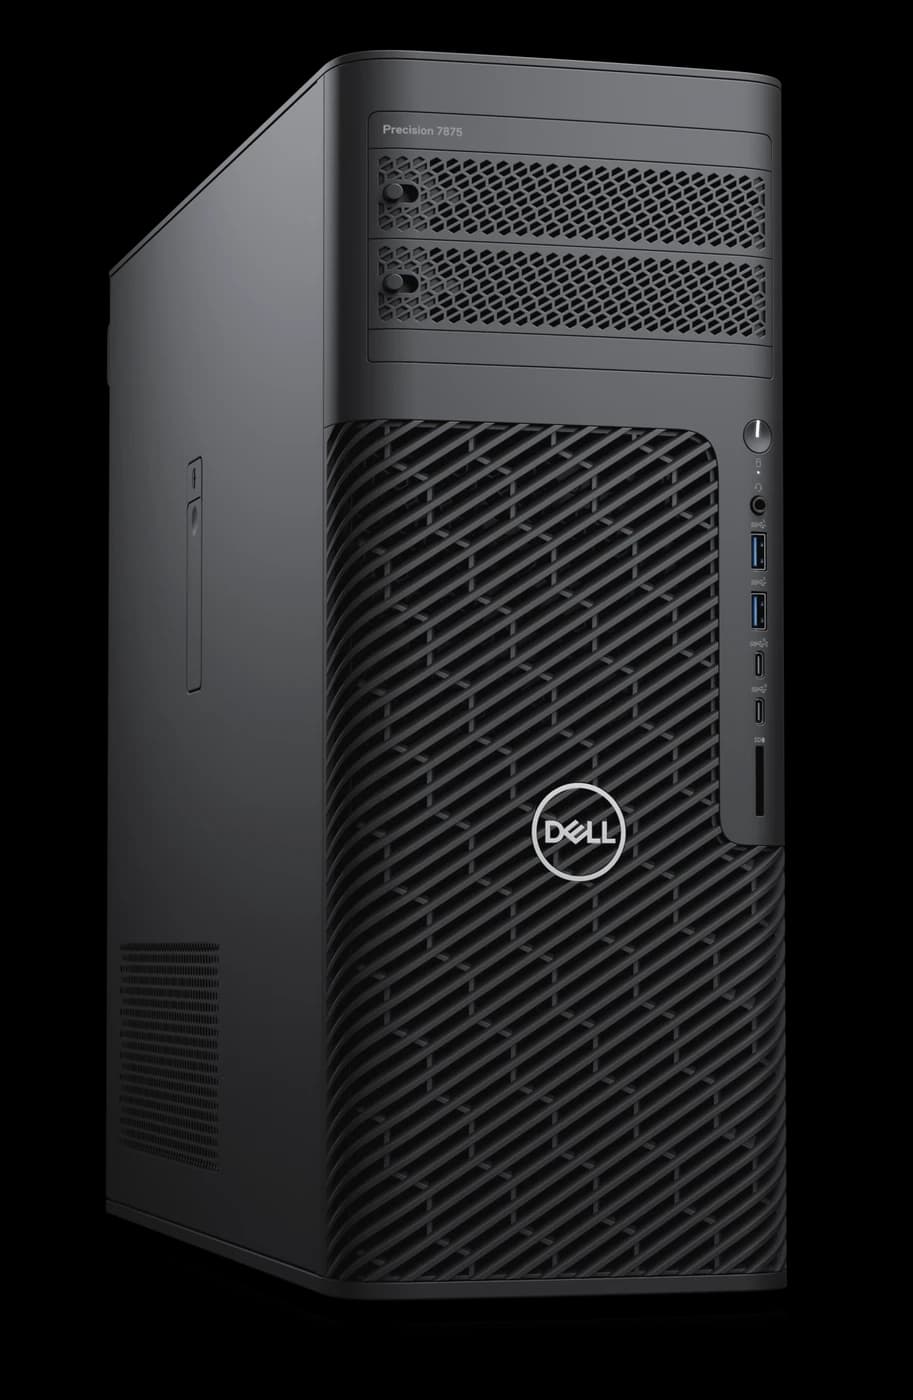
予算と要件が明確な場合はPCが適しています。ワークステーションは、モデルに応じてECCメモリ、PCIeレーン、ハードウェア対応といった選択肢が増えます。確認すべき違いはマザーボード、CPU、ケース、電源システム、そしてメーカーが認定している機器リストであり、「ワークステーション」という名前が付いているからといって、あらゆる種類のカードを搭載できるわけではありません。
例としてDell Precision 7875上のAIサーバーワークステーションは、NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition、96 GB GDDR7 ECCメモリ、GPU電力300 Wという、Dellが対応を明記しているモデルに沿った構成方針を採用しています。開始価格は約700,000 THBで、CPU、RAM、SSD、PSU、およびサービス範囲を見積書で確認する必要があります。RTX 6000 Adaや600 WのWorkstation版ではありません [2][3]
カードを買うだけでは終わらないことがあります
GPUを発注する前に、長さ、厚み、占有するスロット数、電源コネクタ、排熱、BIOS、オペレーティングシステム、ドライバー、さらにマシン全体の保証条件を確認してください。スロットに差し込めるカードだからといって、システムが完全に対応しているとは限りません。
GPU選びはメモリから始め、次に速度を見る
VRAMはGPUの作業机のようなものです。モデル、一時的なデータ、そして現在処理中の作業を十分に置ける広さが必要です。一方、帯域幅は机の上のデータを取り出す速さです。容量は作業を載せるのに役立ちますが、速度を表す数値ではありません。GPUを比較する際は、同じモデル、同じprecision、同じソフトウェアを使う必要があり、precisionやsparsityの条件が異なるAI TOPSの値を比べてはいけません。
スペックを読むためのGPUファミリーの例であり、速度のランキングではありません
| ファミリー/モデル例 | モデルごとのメモリ | どの点を検討するために使うか |
|---|---|---|
| GeForce RTX 5060 Ti | 8 GB版と16 GB版があります | SKUを正しく選ぶこと。モデル名が似ていても容量が異なる場合があります |
| GeForce RTX 4090 / RTX 5090 | 24 GB / 32 GB | 開発作業、画像処理、および搭載可能だと測定済みのLLM向けの単体カード。電源とカードのサイズを確認してください |
| RTX 6000 Ada | 48 GB ECC | RTX PRO 6000 Blackwellとは別モデルのプロフェッショナル向けカードです |
| RTX PRO 5000 Blackwell | 48 GB版と72 GB ECC版があります | サブモデル名とデータシートを読むこと。すべてのカードが同じ容量だと一括りに考えないでください |
| RTX PRO 6000 Blackwell | 96 GB ECC | Workstation、Max-Q、Server Editionでは電源/冷却の要件が異なります |
| データセンター向けGPU、例えばH100 / H200 | H100には80 GB版があります。H200は141 GB | システム全体とフォームファクターの両方を選ぶこと。NVLink/ネットワーク/マシンのメーカーが拡張性に影響します |
2569年11月14日時点で確認したスペックの例であり、即納可能な商品リストや性能の保証ではありません [3][4][5][6][7][8][20][23]
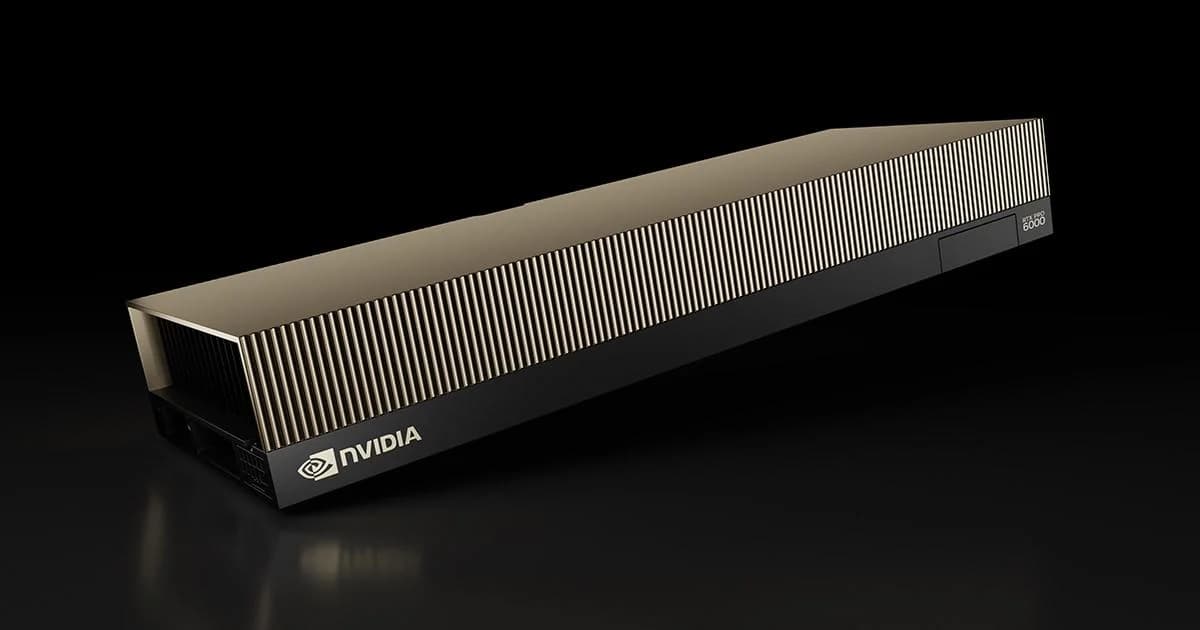
VRAMがどれくらいあれば、どのような作業を始められるか
試用を始めるための指針です。購入前にmodel cardとbenchmarkを確認する必要があります
| GPUあたりのVRAMの範囲 | テストに用いる作業の例 | 注意すべき点 |
|---|---|---|
| 8–12 GB | AIの学習、小規模な画像モデルのinference、quantizedされた小規模LLM | context、画像の解像度、batchに使える領域が限られます |
| 16–24 GB | quantizedされた7B–8BのLLMの試用、一部のpipelineでの画像生成作業、一部のモデルでのLoRA | LoRAはすべてのモデルを搭載可能にするわけではありません。モデルと設定が大きく影響します |
| 32–48 GB | quantizedされた14B–32BのLLMのテスト、または画像処理/追加の学習作業により多くの領域を確保すること | 重みが収まっても、KV cacheとruntimeの分を見込む必要があります |
| 72–96 GB | quantizedされた70BのLLMのテスト、またはより多くの領域を必要とする作業 | ユーザー数と応答速度は実測する必要があります。長いcontextはメモリを増やします |
| 複数GPU/データセンター向けGPU | 一枚では足りないモデル、training(学習)の作業や複数セットのサービス提供 | ソフトウェアが処理の分割に対応している必要があり、topology(接続構成)も適切でなければなりません |
これは試してみるための出発点であり、保証された最低スペックではありません。名前が近いモデルでも使用するメモリ量が異なる場合があり、RAM への offload(退避)はデータ転送の時間と引き換えになります [10][11][12]
LLM モデルの必要容量をわかりやすく計算する
B はパラメータ数が十億単位であることを意味します。モデルの重みだけなら、パラメータ数 × 一パラメータあたりのビット数 ÷ 8 で概算できます。例として 8B を BF16/FP16 で使う場合は 8 × 2 = 16 GB、4-bit の場合は約 8 × 0.5 = 4 GB です。この表は GB を十進法(十のべき乗)で用いており、quantization(量子化)の metadata、KV cache、activation、runtime、そしてシステム用の領域はまだ含んでいません [10][11]
モデルの重みのみ: メモリ予算を立てるための計算
| モデルの例 | BF16/FP16: 2 bytes | 8-bit: 1 byte | 4-bit: 0.5 byte |
|---|---|---|---|
| 8B | 16 GB | 8 GB | 4 GB |
| 14B | 28 GB | 14 GB | 7 GB |
| 32B | 64 GB | 32 GB | 16 GB |
| 70B | 140 GB | 70 GB | 35 GB |
説明のための計算値であり、すぐに使える状態での最低 VRAM でもなく、特定モデルの benchmark(ベンチマーク)結果でもありません
したがって、4-bit の 70B モデルで重みが 35 GB と計算できたとしても、40 GB の GPU があれば直ちに複数人へサービス提供できるという意味ではありません。各処理の質問と回答の文脈(コンテキスト)のための領域、さらに inference engine(推論エンジン)の動作のための領域を残しておく必要があります。ビット数を下げると容量は減りますが、回答の品質と速度も検証しなければならず、容量だけで選ぶべきではありません
モデルを使う、追加で学習させる、新たに学習し直す、それぞれ必要なマシンは同じではありません
スペックを選ぶ前に作業を切り分ける
| 仕事 | 何が起きるか | 余裕を見ておくべきもの |
|---|---|---|
| Inference | 重みを読み込んで予測や質問への回答を行う | 重み + cache + activation + runtime |
| LoRA / QLoRA | 補助的なパラメータの一部だけを学習する; QLoRA は主要な重みを quantized(量子化された)状態で使用する | それでも base model、activation、および学習する部分の optimizer が必要です |
| Full fine-tuning | モデルの主要パラメータを更新する | gradients、optimizer states、重みのコピー、および activation が追加の容量を使用します |
| Training from scratch | データセットから新しい重みを学習する | 高品質なデータ、compute(計算)の時間、checkpoint の仕組み、そして複数回にわたる試行 |
あらゆる framework、optimizer、precision、sequence length、またはモデルの分割方法に通用する単一の VRAM 倍率は存在しません [12][13]
画像関連の作業では、部品の検査/画像の分類と、diffusion による画像生成、そして動画生成とを分けて考える必要があります。解像度、batch、またはフレーム数を増やすと、必要な容量と処理時間が増えます。そのため、batch が小さい画像生成と画像モデルの train(学習)では、必要なスペックの水準がまったく異なります。offload、tiling、checkpointing といったメモリ削減の手法は役立つ場合がありますが、速度との引き換えになることがあり、実際に使う pipeline のマニュアルを確認する必要があります [14]
メインの RAM はどれくらい必要か
マシンの RAM は、DGX Spark のような共有メモリ型のプラットフォームを除き、カード上の VRAM とは別のものです。RAM の役割は、オペレーティングシステム、データ前処理のプログラム、database/cache、そしてモデル読み込み中のデータを支えることです。RAM が多くても VRAM が自動的に増えるわけではなく、モデルの一部を RAM に移すと CPU/GPU 間の帯域幅(バンド幅)が制約になる場合があります
- メモリの収支を書き出す: システムと基本サービス + data loader/前処理中の画像 + database/cache + モデル読み込み時または offload の分 + 同時に実行する他の処理 + 予備の領域
- 仮の例: システム 16 GB + データ前処理 24 GB + cache/database 16 GB + 読み込み時/作業用の予備 32 GB = 88 GB となるため、これより大きい容量、たとえば 128 GB を検討し、実際の peak(ピーク)を測定します。すべてのマシンが 128 GB でなければならないという規則ではありません
- 複数のサービスを動かす場合や、大きな dataset を同時に読み込む場合は、256 GB あるいはそれ以上を検討する必要があるかもしれませんが、実際の使用項目から考えるべきで、作業内容を見ずに RAM = VRAM × 2 という式を使ってはいけません
- 対応している DDR の世代、ECC UDIMM/RDIMM、メモリチャネル数、そしてマニュアルに沿った DIMM の挿し方を確認してください。複数枚のメモリを誤ったスロットに挿すと、期待した帯域幅(バンド幅)が得られない場合があります
容量と、メモリチャネル数は別の話
RAMの合計容量が同じでも、使っていないメモリチャネルがある構成とチャネルに分散して装着した構成では、帯域幅が異なる場合があります。CPUとマザーボードの装着ガイド、DIMMの種類と枚数、実際の構成で対応する速度を確認してください。
ECCは、ある種類のメモリエラーを検出して訂正する仕組みであり、データが決して壊れないことを保証するものではありません。UDIMMとRDIMMは別の種類のメモリなので、プラットフォームに合わせて選ぶ必要があり、容量が同じで同じDDR世代だからという理由だけで選んではいけません。
パイプライン: データはどこを通るのか
Bandwidthは一秒間に送れるデータ量のことで、latencyは各処理の待ち時間のことです。どちらも重要です。道幅が広くても、一か所ずつ待つ工程があれば応答が遅くなることがあります。LLMの処理は、長いpromptを読み込む段階と、tokenを一つずつ生成して回答を作る段階とで挙動が異なるため、prefillとdecodeを分けて測定するとよいでしょう [11]
システムを比較する前に、まず単位を正しく読み取る
| 接続経路 | 理論上の上限の例 | 確認すべき質問 |
|---|---|---|
| PCIe 4.0 ×16 | 片方向あたり約 31.5 GB/s | ×16のスロットに差しても、電気的に実際につながっているレーンは何本か? |
| PCIe 5.0 ×16 | 片方向あたり約 63 GB/s | CPU、マザーボード、各機器は同じ世代に対応しているか? |
| Ethernet 10 / 25 / 100 Gbps | overhead前で約 1.25 / 3.125 / 12.5 GB/s | スイッチ、ケーブル、NIC、そして接続先のStorageは十分に速いか? |
| GPU memory bandwidth | そのGPUのdatasheetで確認する | これはメモリ内部の速度であり、PCIeやネットワークの速度ではありません |
GB/sはバイト、Gbpsはビットです。8 bits = 1 byte。PCIeの数値はリンクのエンコードを考慮した後の値ですが、protocol overheadはまだ差し引かれておらず、実際の実用速度ではありません [16]
仮の例: 使用可能な状態のデータセットが 100 GB あり、接続経路が 10 Gbps で上限 1.25 GB/s だとすると、転送だけにかかる理論上の最短時間は 100 ÷ 1.25 = 80 秒です。実際にはoverhead、細かいファイル、CPU、ディスクの影響でこれより遅くなります。そのため、他の箇所が追いついているかを確認せずに、より速いNICを買うべきではありません。
CPUとマザーボード: スロットだけでなくレーンを見る
CPUはファイルの読み込み、画像のデコード、テキストのtokenize、batchの編成、その他のサービスの管理を担います。コア数が多いと役立つ処理もありますが、ソフトウェアがそれらのコアを使えることが前提です。マザーボードには、実際に空いているスロットと、CPU/チップセットから供給されるPCIeレーンの両方が必要です。長い×16の形状の口を見ただけで、すべての口が×16で使えると数えてはいけません。
- block diagramを読む: どのスロットがCPUに直結し、どのスロットがチップセット経由で、どの機器がM.2/NICとレーンを共有しているか
- 計画の例: GPU 4枚 ×16 = 64レーン、NVMe 2台 ×4 = 8レーン、NIC ×8 = 8レーン、この仮定では合計 80レーンです。オンボード機器も含めて、実際のレーン配線を確認する必要があります
- カードの大きさと間隔を確認する: 3スロットを占めるカードは、レーンの総数が足りていても他の口をふさぐことがあります
- PCIe bifurcationとriserは、CPU、BIOS、マザーボード、機器のすべてが対応している必要があります。分岐ケーブルを買えばどの機械でも使える、というわけではありません
4基のGPUを使うために必ず2基のCPUが必要というわけではありません。例として、WRX90プラットフォーム上のThreadripper PROは、一ソケットのシステムで最大 128 PCIe 5.0 lanes とメモリ 8 channels に対応します。ただし、実際に取り付けられるカードの枚数は、マザーボード、ケース、電源、メーカーの認証にも左右されます [17] Dell Precision 7875 には独自のスロット配置があるため、CPUのレーンが多いからこの機種で四枚のGPUに対応できる、と結論づけるべきではありません [22]
二基のCPUは何に役立つのか、そしてNUMAとは何か
二ソケットの機械は、プラットフォームによってコア数、RAM容量、I/Oリソースを増やせることがあります。しかし、あらゆる帯域幅を単純に足し合わせて、どの処理も二倍速くなるというものではありません。各CPUには自分の近くにあるメモリと機器があり、もう一方のCPU側へのアクセスはソケット間リンクを経由する必要があります。この考え方をNUMAと呼びます [15]
CPU A
- A側のRAMCPU Aが直接アクセスするメモリ
- GPU 0 と GPU 1AのPCIe rootに接続されたGPUの例
CPU B
- B側のRAMCPU Bが直接アクセスするメモリ
- GPU 2 と GPU 3BのPCIe rootに接続されたGPUの例
CPU間リンク: 反対側へアクセスできますが、時間と帯域幅のコストがかかります
実機のtopologyを確認する必要があります。システムによってはPCIe switchがあり、レーン配線も例とは異なります。処理とメモリは、適切な範囲で使用するGPUの近くに結び付けるとよいでしょう
二基のCPUが適しているのは、CPU、RAM、I/Oの負荷が実際に追加のリソースを必要としていて、OSとソフトウェアが適切に処理を割り当てられる場合です。処理が主にGPUを待っていて、使用するカードの枚数も多くないなら、十分なレーンを備えた一 CPUのシステムのほうが扱いやすいこともあります。判断する前に、システムのツールでtopologyを確認し、benchmarkを取ってください。
複数GPUはどう使うのか ― 挿すだけでVRAMがすぐ合算されるわけではありません
複数のGPUを使う三つの方法
| 方法 | 概要 | トレードオフ(引き換えになるもの) |
|---|---|---|
| 仕事を分ける/サービスを複製する | 各GPUが自分に収まるモデルを実行し、リクエストを振り分ける | 全体で受けられる処理量は増えるが、モデル一式は依然として一枚ごとに収まる必要がある |
| Data parallel training | 各GPUが別々のbatchのデータで学習し、gradientsを交換する | GPU間の通信が必要で、batch/optimizerを適切に設定する必要がある |
| Tensor / pipeline parallel | モデル、または一つのモデル内部の処理をGPU間で分割する | 一枚では足りない場合に役立つが、通信が増え、engineに依存する |
24 GBのGPU 二枚が自動的に48 GBのGPU 一枚になるわけではありません。model shardingと一枚ごとの制約は、やはり確認が必要です [18][19]
そのカードがNVLinkに対応しているかを確認してください。RTXという名前や価格から推測してはいけません。PCIeを使う場合は、GPU間の経路と、システム全体のpeer-to-peer対応を確認する必要があります。複数台の構成では、ネットワークが計算の一部になります。NIC、switch、ソフトウェアに応じたRDMA、そしてGPU/NICの配置を確認する必要があります。100 Gbpsのポートがあれば、うまくscaleすることが保証される、というわけではありません [18]
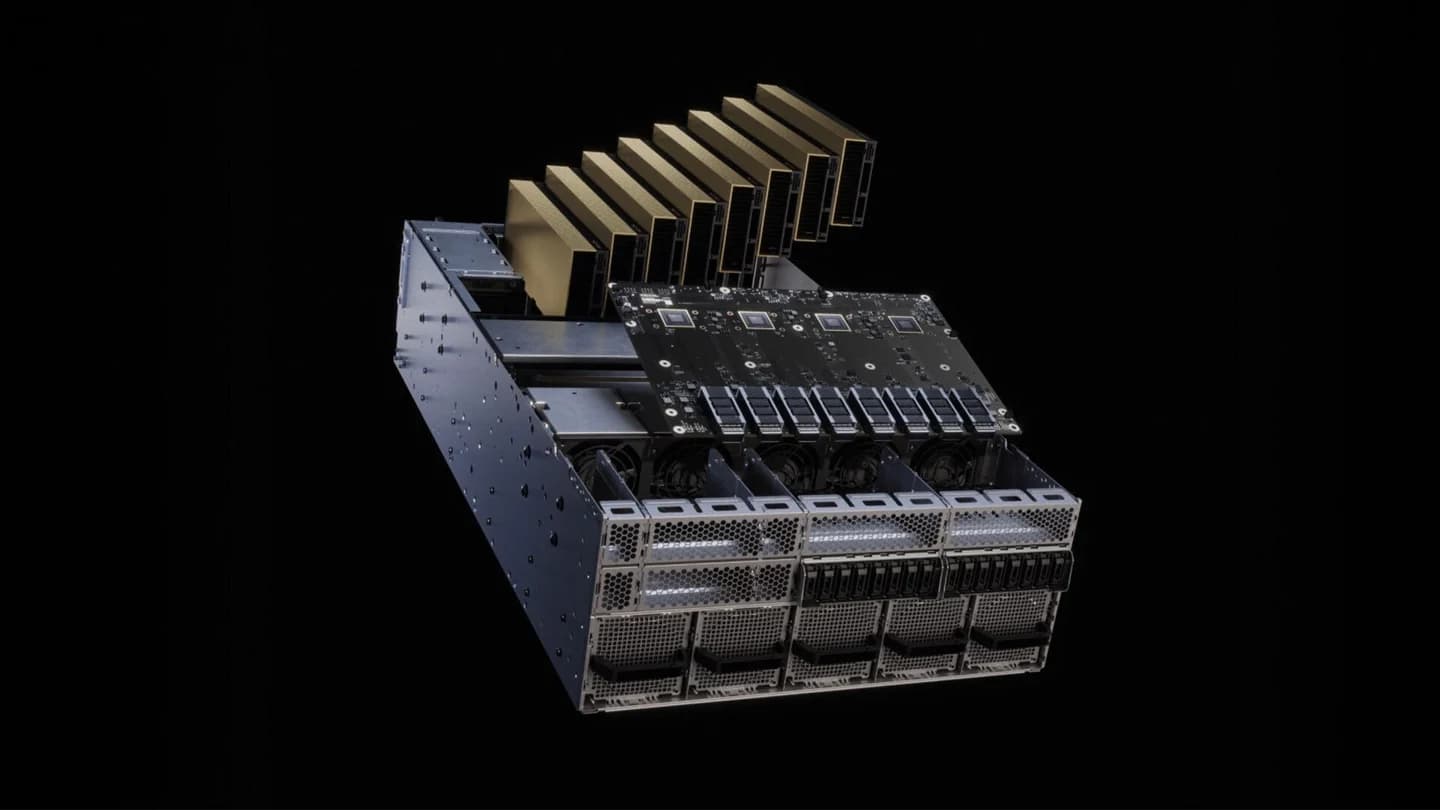
NVLinkは、対応するシステムにおけるGPU間の高速な接続路です。一方RDMAは、対応する機器がネットワーク経由でデータを送受信する際、CPUのコピー作業の一部を軽減するのに役立ちます。どちらもハードウェアとソフトウェアの両方で対応が必要で、すべてのGPUやすべてのネットワークポートが備えている機能ではありません [18]
何人のユーザーに対応できるのか ― 何を見ればよいのか
「アカウントを持っている人」と「いま処理中のリクエスト」を区別してください。たとえば、組織に多数のアカウントがあっても、同時に質問している人は少ないかもしれません。逆に、ユーザーは少なくても毎回長い文書を送るなら、より多くのリソースを使う可能性があります。LLMの場合は、モデルのサイズ、precision、input/outputの長さ、同時リクエスト数、KV cache、そしてbatchingの仕組みを見てください [11]
- TTFT: 質問を送ってから最初のtokenが返るまでの時間。キューでの待ち時間も含みます
- 回答の速さ: リクエストごとのtokens/sと、回答が終わるまでの合計時間。マシン全体の総量だけを見ないでください
- Throughput: 指定した試験負荷のもとでの、一秒あたりの処理件数またはtoken数の合計
- P95 latency: 100件のリクエストのうち95件がこの値より遅くならずに完了する、という時間の値。同時利用者がいるときの遅さの症状を見るのに使います [21]
- エラーと品質: out-of-memory、timeout、質問に合っていない回答、そして文書の権限分離
計算のための仮の例: ある試験負荷で合計120 output tokens/sが測定され、一リクエストあたり平均20 output tokens/sが必要な場合、120 ÷ 20 = 6 という割り算は、同時リクエストを約6件から試す出発点として使うだけのものです。6人に対応できるという保証ではありません。prefill、KV cache、batching、回答の長さによって結果は変わるためです。実際のpromptと、合意した待ち時間の基準を用いて、複数の水準のconcurrencyでテストする必要があります
見積書と一緒に依頼すべきテスト結果
モデルの名称と型、quantization/context、質問の例、回答の長さ、concurrent requests、TTFT、P95、throughput、peak memory を、ソフトウェアのバージョンとともに明記してください。同じ作業内容でマシンを比較できるようにするためです。条件の説明が付いていないユーザー数は使わないでください
Power Supply、熱、そして設置スペース
システム全体の電力を集計してください: GPU + CPU + RAM + SSD/NIC + マザーボードとファン。そのうえで、負荷の急な変動とメーカーの要件に対する余裕を見てください。TDPやGPU powerの数値は、マシン全体についてコンセントで測定される値ではありません。PSUの効率と作業負荷が、実際の電力に影響します
仮の例であり、完成した組み立て仕様やDell 7875の仕様ではありません: GPU 4枚 × 300 W = 1,200 W; CPU 350 W; RAM/Storage/ボード/ファンの合計を仮に200 Wとすると、余裕を見る前の機器側の負荷は1,750 Wになります。PSU、コネクタ、電源ケーブル、そして実際に対応できる電力を確認する必要があります。この足し算の結果からそのまま1,750 WのPSUを買うべきではありません。600 Wのカード四枚ではGPUだけで合計2,400 Wになるため、カード一枚のマシンとはまったく別の課題になります
- メーカーが指定するコネクタとケーブルを確認し、認証のない変換ケーブルや分岐ケーブルは使わないこと
- 冗長構成のPSUでは、redundancyのモードを確認する必要があります: 二台あることは、PSU 一台の故障に耐えながら合計の電力をすべて使える、という意味ではありません
- passive coolingのカードは、要件どおりのchassisのairflowが必要です。一般的なケースに入れてPSUのファンに頼ろうとしないこと
- コンセント、電気回路、UPS(W/VAの単位と予備稼働時間の両方)を確認し、さらに熱、騒音、マシンの保守スペースについて建物の管理者とも確認すること
電気代は、測定された平均電力から計算します: 仮の例として 1 kW × 8時間 × 30日 = 240 kWh、これに実際の電気料金の単価を掛けます。冷却システムはまだ含まれていません。そのため、購入と賃借の費用を比較する前に、idleの状態と日常的に使う作業負荷の両方を測定しておくべきです
Storageには何を保存し、どれだけの速さが必要なのか
SSD と バックアップ体制 を選ぶ前に、データを分類しましょう
| 保存するもの | 使い方の特徴 | 適した選び方 |
|---|---|---|
| システムとアプリケーション | OS, containers, libraries | アップデートと復旧のための領域。必要に応じて重要データとは分けて保存します |
| モデルと checkpoint | 複数バージョンの大きなファイル。起動時に読み込んだり、学習中に保存したりします | 容量、連続読み書き速度、そして前のバージョンに戻せるようにするための余裕 |
| 画像・動画・文書の Dataset | 大きなファイル、または多数の小さなファイル | throughput と IOPS の両方を確認し、data-loader pattern も含めて検討します |
| データベース / vector index / log | 小さな読み書きが多く、機密性の高いデータが含まれる場合もあります | latency、endurance、アクセス権限、そして保存期間のポリシー |
| Backup | メインの機器とは別に保管するコピー | バージョン管理、暗号化、復旧テスト、そしてアクセスできる人の権限 |
RAID はディスク故障の一部のケースでは役立ちますが、誤削除、ransomware、機器全体の損壊に対する backup の代わりにはなりません
仮の例: dataset 500 GB + model/checkpoint 400 GB + cache 200 GB + システムと log 100 GB = 1,200 GB。これは増加分を見込む前の数字なので、実際にはこれより大きい実効容量を選び、backup も別に考える必要があります。また、生の容量(raw capacity)と RAID/format 後の usable capacity を混同しないようにし、sequential の最高速度という一つの数値だけで小さなファイルを扱う処理を判断しないでください
まず初期スペックを組み、発注前にテストしましょう
システム担当者と話を始めるためのたたき台であり、性能を保証するものではありません
| 状況 | 初期の方針 | 発注前の条件 |
|---|---|---|
| デスクで AI を学習・開発する | DGX Spark、またはソフトウェアに応じて GPU 16–24 GB を搭載した PC | Arm64/x86、モデル、そして許容できる速度を確認します |
| 組織内で画像生成と LLM を扱うチーム | GPU 32–96 GB の Workstation。RAM/SSD はデータの一覧から計算します | 実際の pipeline と、他のサービスと同時に使う状況をテストします |
| 複数チーム / 大きなモデル / 継続的な学習作業 | メーカーが認定している複数 GPU、または複数ノードのシステム | topology、network、power/cooling、保守、そしてシステム全体の benchmark を確認します |
VRAM の容量は適合性を保証するものではありません。使うモデルのバージョンと、あなた自身の受け入れ基準から始める必要があります
- 1
課題と受け入れ基準を書き出す
モデル、実際の業務、同時に使う利用者、許容できる待ち時間、そしてデータに関する要件を明記します
- 2
メモリの予算を作る
モデルの重み、cache、activation、そして周辺の処理が使う RAM を分けて考え、実験で peak を測定します
- 3
データの流れを図にする
Storage → CPU/RAM → PCIe → GPU の順にたどり、ネットワークとデータベースも含めて、ボトルネックを一箇所ずつ確認します
- 4
機器一式を確認する
CPU、マザーボード、DIMM、スロット、PSU、コネクタ、エアフローのマニュアルと、メーカーが対応している製品リストを読みます
- 5
テストしてから見積書をまとめる
実際のデータセットと concurrency を使い、品質、応答時間、消費電力、メモリを記録します。あわせて拡張計画と保守の範囲も用意します
Inspektion のチームと一緒に評価したい場合は、モデル名または業務の種類、データのサンプル、同時リクエスト数、許容できる待ち時間、設置場所の制約を用意してください。そのうえで DGX Spark、Dell AI Workstation、または全体像として Modern Data をご覧いただき、あなたのシステムに合った出発点をお選びください。文書検索の業務については Enterprise KM Chatbot で続きをお読みいただけます
よくある質問
DGX Spark とワークステーション、初心者にはどちらが向いていますか
やりたい作業と必要なソフトウェアを基準に判断してください。DGX Spark は、共有メモリが大きい小型マシンで AI の開発や実験を行う用途に向いていますが、Arm64 への対応を確認する必要があります。一方ワークステーションは、プラットフォームに応じて GPU や各構成部品を選べます。どちらの形態でも、同時利用者数を決める前に実際のモデルでテストする必要があります。
24 GB の GPU 二 枚は、48 GB の GPU 一 枚の代わりになりますか
自動的に代わりになるわけではありません。モデルや処理を複数の GPU にまたがって分割できるソフトウェアが必要で、さらに 一 枚あたりのメモリ容量と GPU 間の通信経路を確認する必要があります。もう一つの方法は、各 GPU にそれぞれ別のサービス群を実行させ、全体として処理できる作業量を増やすことです。
RAM を増やせば、VRAM より大きい LLM を実行できるようになりますか
一部の engine は RAM への offload に対応していますが、データの転送コストがかかり、応答が遅くなる場合があります。対応状況を確認し、実際に測定する必要があります。RAM を多く積んでも GPU memory が増えるわけではありません。ただし共有メモリ方式のシステムは別の観点で検討する必要があります。
GPU を 四枚搭載するには CPU が 二 基必要ですか
必ずしも必要ではありません。CPU 一 基のプラットフォームでも、機種によっては十分な PCIe レーン数を備えています。マザーボード、スロットの幅、対応するカード、電源と冷却(熱)の条件を確認する必要があります。CPU 二 基のマシンの場合は、NUMA と GPU/RAM の配置も確認してください。
開始価格 300,000 THB と 700,000 THB には何が含まれますか
これはそれぞれ DGX Spark と Dell AI Workstation の提案における開始時の概算価格です。ハードウェア、ソフトウェア、設置、税、保証、納品の各項目は見積書で確定します。固定価格ではなく、同時利用者数を保証するものでもありません。
参考文献
- [1]
DGX Spark: specifications and workloads — NVIDIA (参照 2026-11-14)
- [2]
Precision 7875 Tower: graphics options — Dell (参照 2026-11-14)
- [3]
RTX PRO 6000 Blackwell Max-Q Workstation Edition — NVIDIA (参照 2026-11-14)
- [4]
GeForce RTX 5060 family — NVIDIA (参照 2026-11-14)
- [5]
GeForce RTX 5090 — NVIDIA (参照 2026-11-14)
- [6]
RTX 6000 Ada Generation — NVIDIA (参照 2026-11-14)
- [7]
RTX PRO 5000 Blackwell — NVIDIA (参照 2026-11-14)
- [8]
H200 Tensor Core GPU — NVIDIA (参照 2026-11-14)
- [9]
RTX PRO 6000 Blackwell Server Edition — NVIDIA (参照 2026-11-14)
- [10]
Quantization with bitsandbytes — Hugging Face (参照 2026-11-14)
- [11]
Optimization and Tuning — vLLM (参照 2026-11-14)
- [12]
Memory anatomy of model training — Hugging Face (参照 2026-11-14)
- [13]
Parameter-efficient fine-tuning: quantization — Hugging Face (参照 2026-11-14)
- [14]
Reduce memory usage for diffusion pipelines — Hugging Face (参照 2026-11-14)
- [15]
Performance Tuning Guide: data loading and NUMA — PyTorch (参照 2026-11-14)
- [16]
PCIe bandwidth per direction after encoding overhead — PCI-SIG (参照 2026-11-14)
- [17]
AMD Ryzen Threadripper PRO processors — AMD (参照 2026-11-14)
- [18]
Distributed serving — vLLM (参照 2026-11-14)
- [19]
DistributedDataParallel — PyTorch (参照 2026-11-14)
- [20]
GeForce RTX 4090 specifications — NVIDIA (参照 2026-11-14)
- [21]
LLM Benchmarking: Fundamental Concepts — NVIDIA (参照 2026-11-14)
- [22]
Precision 7875 Tower: internal slots — Dell (参照 2026-11-14)
- [23]
HGX GPU memory and platform specifications — NVIDIA (参照 2026-11-14)