一般製造向け、カメラとAIによるワークの色調検査プログラム(IKS2 Shading)
IKS2 Shadingは、カメラでワークの色調を検査するプログラムです。良品と不良品の画像から基準を学習し、AIが色調をグループ分けして、良品(OK)または不良品(NG)として結果を表示します。当社はこのプロトタイプのプログラムを自社で開発し、2018年に知的財産局へ著作権情報を届け出ました。
- 業界
- 一般製造業
- 年
- 2018年(著作権届出年)
- 業務範囲
- 入力データ: カメラで撮影した良品ワークと不良品ワークの画像 · 処理: 画像のフィルタリング、ヒストグラムに基づくRGB値の並べ替え、画像の特徴抽出(Feature Extraction)、K-means Clusteringによる色調のグループ分け、Fuzzy Logicによる判定基準の選択 · 結果表示: 良品(OK)または不良品(NG)とサマリーレポート · ソフトウェア: 基準学習部、検査・結果表示部、履歴参照用の色データベース、プログラミングなしで新しい標準色調を追加する画面 · 当社が構築したもの: 当社が自社開発した試作プログラムIKS2 Shading
要約
- IKS2 Shadingは、当社が自社開発したカメラによるワーク色調検査の試作プログラムで、2018年に知的財産局へ著作権情報を届け出ました。
- ユーザーは良品ワークと不良品ワークの画像で基準を学習させます。新しい標準色調が必要になった場合は、プログラミングなしで新しいサンプル画像セットを追加できます。
- AIはK-means Clusteringによる色データのグループ分けを担い、Fuzzy Logicが判定基準を選択し、どのサンプル画像を良品または不良品とするかはユーザーが決定します。
- 検査結果は良品(OK)または不良品(NG)としてサマリーレポートとともに表示され、色データは後から参照できるようデータベースに保存されます。
- IKS2 Shadingはサンプル画像から基準を設定する試作プログラムです。そのため、どのワークに適用する場合も、そのワークと現場の照明で基準を学習させ、テストする必要があります。
現場の課題
多くの工場では、今なおワークの色調を目視で選別しています。作業者によって「このワークの色は合格か不合格か」の回答が一致しないことがあり、人手による選別には多くの労力と時間がかかります。
当社の取り組み
当社は、画像内の色を数値に変換する意思決定支援システム(Decision Support System)としてIKS2 Shadingを開発しました。K-means Clustering(データを自動でグループ分けする手法)で良品と不良品のグループを分け、Fuzzy Logic(ファジィ論理)で判定基準を選択します。検査結果はOKまたはNGとしてサマリーレポートとともに表示し、色データは後から参照できるよう保存します。
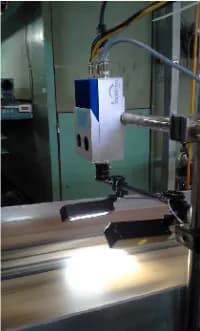
- 良品・不良品ワークの撮影マシンビジョン
- ヒストグラムに基づく色の値の並べ替えRGB Histogram + Feature Extraction
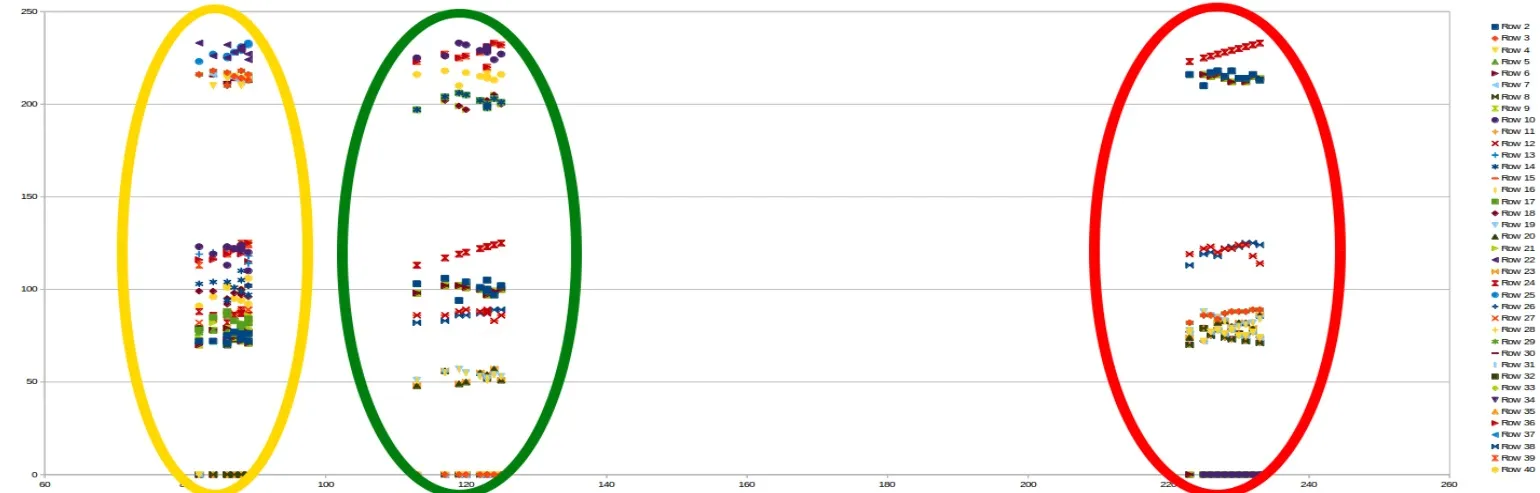
- AIによる色調のグループ分けK-means Clustering
- 判定基準の選択Fuzzy Logic
- OK/NG結果とサマリーレポート
実ワークでの試験結果
画像の数値から毎回同じ基準で色調を判定する試作プログラムが得られ、当社は2018年に知的財産局へ著作権情報を届け出ました。どのワークに適用する場合も、そのワークと現場の照明条件で基準を学習させ、テストする必要があります。
課題の背景
この取り組みの課題は、検査者に左右されない基準でワークの色の合否を判定することです。多くの工場では今なお色調を目視で選別しており、作業者によって同じワークの判定が一致しないことがあり、人手による選別には多くの労力と時間がかかります。
当社はIKS2 Shadingを試作プログラムとして自社開発しました。当社のプレゼンテーション資料では、応用例としてラベル、タイル、カーペットの色調検査を挙げています。
要件と制約
プログラムは実際のワーク画像から基準を設定でき、ユーザー自身が新しい標準色調を追加できる必要があります。試作の主な要件は次のとおりです。
- 良品ワークと不良品ワークの画像を基準設定のデータとして使用します。
- 新しいサンプル画像セットでモデルを学習させることで、プログラミングなしで画面から新しい標準色調を追加できます。
- 検査結果を良品(OK)または不良品(NG)としてサマリーレポートとともに表示します。
- 色データをデータベースに保存し、履歴の参照と基準の調整に使用します。
主な制約は画像に起因します。画像内の色の値は照明によって変化し、得られる基準の良し悪しは学習に使うサンプル画像次第です。そのため、サンプル画像は実際に発生する色調の範囲を網羅する必要があり、どのようなワークを良品とするかをチームで事前に合意しておく必要があります。
良品ワークと不良品ワークの画像からプログラムに基準を学習させる方式を選んだ理由
この方式を選んだのは、現場の問いが「色は合格か不合格か」であり、その答えはチームがすでに選別したサンプルワークの中にあるためです。そこでプログラムは、サンプル画像の色を数値に変換し、その数値から良品と不良品をグループ分けします。新しい標準色調が必要になった場合、チームはプログラムを修正せずに新しいサンプル画像セットを追加できます。
AIが担うのは色データのグループ分けのみです。基準の選択にはFuzzy Logic(ファジィ論理。はい・いいえで明確に分けられない値を扱って推論する手法)を使用します。良品と不良品のサンプル画像はユーザーが指定し、OK / NGの結果は判断の材料として使用します。処理手順は次のとおりです。
- 1
良品と不良品のサンプル画像を撮影
ユーザーは色調が合格のワークと不合格のワークを撮影し、サンプルとして保存します。この画像セットが、プログラムが基準の設定に使用するデータです。
- 2
画像のフィルタリングと色の値の並べ替え
プログラムは画像をフィルタリングし、赤、緑、青の値をヒストグラム(Histogram: 画像内の色の値の分布を示すグラフ)に基づいて並べ替え、重要な色データのみを選択します。
- 3
画像の特徴の統合
すべての色チャンネルの色データを、画像の特徴を表す数値セットに統合します(Feature Extraction: 画像の重要な特徴を数値として抽出すること)。これにより、各画像を比較できるようになります。
- 4
AIによる色調のグループ分け
AIがK-means Clusteringでデータをグループ分けして良品ワークと不良品ワークのグループを分け、各グループの代表値を保存して次のワークの判定に使用します。
- 5
基準の選択と結果の出力
Fuzzy Logicが統計的に良好な結果を示すグループを判定基準として選択します。プログラムは良品(OK)または不良品(NG)の結果を表示し、サマリーレポートを出力して、色データをデータベースに保存します。
K-means Clusteringとは
K-means Clusteringは、データを自動でグループ分けする手法です。システムが各グループの中心点を求め、各データを最も近いグループに割り当てます。この取り組みでのデータは画像から得た色の数値であるため、色調の近いワークが同じグループに入ります。
システムの構成要素
IKS2 Shadingは、基準の学習、検査、データ保存を単一のプログラムにまとめた意思決定支援システム(Decision Support System)のソフトウェアです。IKS2 Shadingは各ワークを良品(OK)または不良品(NG)の2つの結果のいずれかに判定し、色データをデータベースに保存します。試作の構成要素は次のとおりです。
- 基準学習部: 良品ワークと不良品ワークの画像を受け取り、色調のグループと各グループの代表値を作成します。
- 検査・結果表示部: 新しいワークの画像を基準と比較し、結果をOKまたはNGで表示します。
- サマリーレポート: ワークの選別結果をOKとNGのグループにまとめます。
- 色データベース: ワークの色データを保存し、後から参照できるようにします。
- 新しい標準色調の追加画面: プログラミングなしでサンプル画像セットを追加し、モデルを再学習できます。
当社が構築したもの
当社はIKS2 Shadingを、画像からの基準学習からOK / NGの結果表示までの工程を備えた試作プログラム(PoC: 概念実証)として開発し、色調自動検査プログラム(IKS2 Shading)の著作権情報を2018年に知的財産局へ届け出ました。著作権情報の届出は著作物の情報を記録するものであり、登録やプログラムの品質認証ではありません。
色調判定の精度は、ワーク、照明、学習に使うサンプル画像セットによって異なります。評価に使う指標は不良検出率と誤報率で、各工場のワークと撮影ポイントで測定する必要があります。
私たちが学んだこと
この取り組みから得られた、カメラによる色調検査の原則は次のとおりです。
- 色の基準は、チームが合意したサンプル画像から始まります。プログラムが良品と不良品の画像から学習する場合、得られる基準の一貫性はサンプル画像の選別の一貫性と同程度になります。そのため、チームはモデルを学習させる前に良品の定義を一致させておく必要があります。
- AIを動かす前に色を数値に変換し、AIがどの部分を担うかを明確にします。この取り組みでは、AIが色データをグループ分けし、Fuzzy Logicが基準を選択し、人がサンプル画像を指定します。また、基準を見直す際に参照できる色データをデータベースに保持しています。
- 照明は基準の一部です。画像内の色の値は照明によって変化するため、ある照明条件で設定した基準は、その地点の照明でテストするまで別の撮影ポイントには適用できません。
この手法をお客様の工場に適用する方法
貴社の工場で梱包や顧客への出荷の前にワークの色調を選別する必要がある場合、この事例の手法を利用できます。良品ワークと不良品ワークの画像から基準を学習させ、色を数値に変換し、グループ分けしてOK / NGを判定する手法です。調整が必要なのは照明、カメラ、貴社のワークのサンプル画像セットで、まず貴社の実際のワークでテストする必要があります。
再利用できる部分と調整が必要な部分
| システムの部分 | 再利用可能 | 調整が必要になる場合 |
|---|---|---|
| 基準の設定 | 良品ワークと不良品ワークの画像からの基準学習 | 貴社のワークの色調や色の範囲が既存のサンプル画像と異なる場合は、新しいサンプル画像セットの撮影が必要です。 |
| 色の数値変換 | ヒストグラムに基づく色の値の並べ替えとFeature Extraction | ワーク表面の模様、光沢、光の反射が異なる場合は、読み取った色の値で引き続き良品と不良品を分けられるかテストする必要があります。 |
| グループ分けと基準の選択 | K-means ClusteringとFuzzy Logic | 貴社チームの良品・不良品の定義が従来と異なる場合は、モデルの再学習が必要です。 |
| 撮影 | 検査ポイントでワークをカメラ撮影するという考え方 | 貴社の検査ポイントで照明条件が異なる場合は、カメラと照明を選定し、照明を一定に保つ制御が必要です。 |
| 結果とデータ | OK / NGの結果、サマリーレポート、色データベース | 結果を工場の他システムへ送る必要がある場合は、連携作業の追加評価が必要です。 |
使用する技術
よくある質問
標準色の値を数値で手入力する必要がありますか?
IKS2 Shadingの主な基準は、良品と不良品のサンプル画像の色データをグループ分けした結果から得られます。詳細な設定方法は、プログラムのバージョンとテストに使うワークによって異なります。
AIはどの部分を担い、誰が結果を判定しますか?
AIはK-means Clusteringで色データをグループ分けし、良品と不良品のグループを分けます。その後、Fuzzy Logicが判定基準を選択します。このプログラムは意思決定支援システムとして設計されており、ユーザーがサンプル画像を指定し、OK / NGの結果を判断の材料として使用します。
検査ポイントの照明は色調検査の結果にどのように影響しますか?
画像内の色の値は照明によって変化するため、ある照明条件で設定した基準は、その地点の照明でテストするまで別の撮影ポイントには適用できません。そのため、基準学習用のサンプル画像を撮影する前に、検査ポイントでカメラと照明を選定し、照明を一定に保つ制御を行う必要があります。
どのような種類のワークに使用できますか?
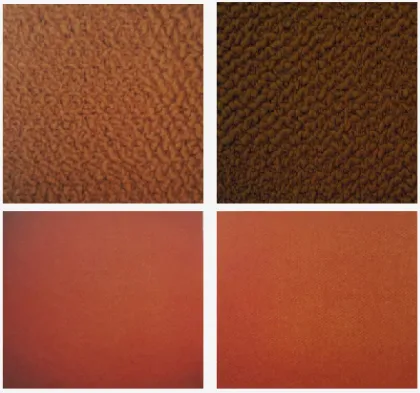
当社のプレゼンテーション資料ではラベル、タイル、カーペットを例に挙げていますが、ワークの種類ごとに表面や光沢が異なるため、確認するには貴社工場のサンプルワークで事前にテストする必要があります。
自社のワークでテストする場合、何を準備する必要がありますか?
実際に発生する色調を網羅した良品と不良品の両方のサンプルワーク、チームで合意した良品の基準、照明条件など撮影予定箇所の情報をご準備ください。標準価格はありません。当社はサンプルワークでのテスト後に価格と期間を見積もります。