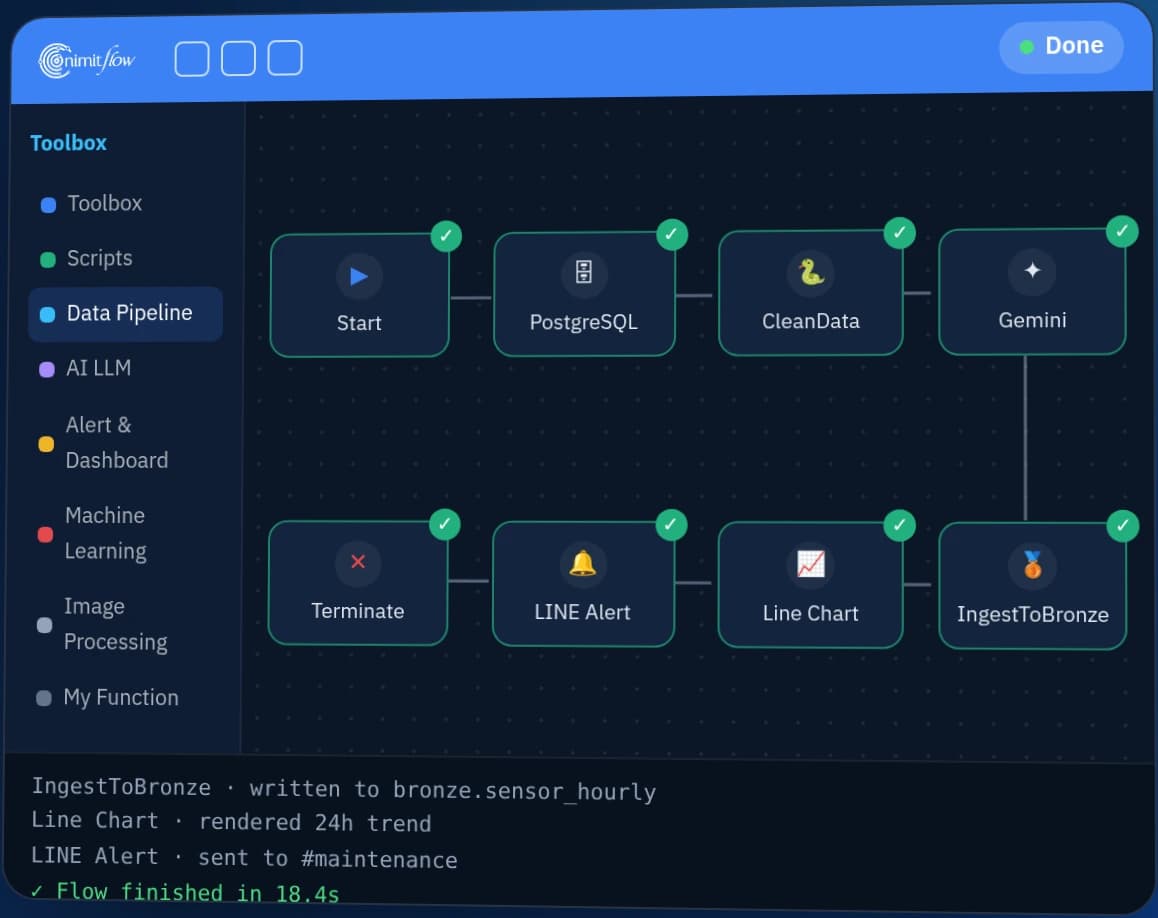
Hubungkan alur kerja dan pantau sistem
Kelola alur kerja, lihat status operasional, dan kirim peringatan kepada administrator.
- nimitFlow
- Prometheus
- Grafana

 Bahasa Indonesia
Modern Data · Repositori data perusahaan
Satukan data ERP/MES, basis data, berkas, dan IoT ke dalam lapisan Bronze–Silver–Gold untuk pelaporan, analitik, dan AI, dengan nimitFlow menghubungkan alur kerja dan memantau sistem.
 Hubungkan alur kerja · Pantau status · Kirim peringatan
Pertahankan data dalam format sumber agar dapat diproses ulang nanti.
Bersihkan, hapus duplikasi, dan susun struktur data sesuai aturan kualitas.
Ringkas data sesuai sudut pandang bisnis agar tim dapat menggunakannya dalam laporan dan analitik.
Kontrol akses · Kualitas data · Katalog · Asal-usul data · Log audit
Tim IT dan tim data yang membutuhkan integrasi data dari beberapa sistem
Daftar sistem sumber, format data, dan izin akses yang diperlukan
Data Lakehouse menyimpan data mentah dan data siap analisis dalam satu sistem. Data Lakehouse & Pipeline kami menyatukan data dari sistem yang ada, berkas, dan perangkat pengumpul data ke repositori pusat ini. Data melewati pemeriksaan kualitas per lapisan, aksesnya dapat dikontrol, dan asalnya dapat ditelusuri. Data yang sama kemudian digunakan untuk pelaporan, analitik, dan AI, termasuk Predictive Analytics dan Enterprise KM Chatbot.
Banyak organisasi menyimpan data di tempat terpisah: basis data ERP/MES, berkas Excel, perangkat NAS, dan peralatan lini produksi. Integrasi sering bergantung pada skrip terjadwal yang sulit dipelihara, sehingga laporan lambat dan asal angkanya sulit ditelusuri. Setiap memulai proyek AI, data harus dikumpulkan dan dibersihkan kembali.
Apa perbedaan Data Lakehouse, Data Lake, dan Data Warehouse?
Data Lakehouse menggabungkan keunggulan Data Lake (data mentah dalam berbagai format dengan biaya penyimpanan rendah) dan Data Warehouse (tabel terstruktur serta kueri SQL cepat). Data disimpan dalam format terbuka (Parquet dan Apache Iceberg) pada penyimpanan objek S3, sehingga tidak bergantung pada satu vendor.
Pendekatan lama
Data Lakehouse
Ringkasan: Data yang sama digunakan untuk pelaporan, analitik, dan AI
Data Lakehouse & Pipeline bekerja dalam 5 langkah: menghubungkan sumber, menyimpan data mentah, memvalidasi dan membersihkan, menyiapkan data untuk digunakan, serta memungkinkan pengguna mencari data. Perangkat lunak lapisan data bersifat Open Source, sementara nimitFlow bersama Prometheus/Grafana memantau sistem.
Hubungkan sumber data
Terima data dari basis data SQL (seperti Oracle, PostgreSQL, dan MS SQL), API, berkas, Google Sheets, serta perangkat IoT menggunakan Apache Airflow untuk pekerjaan berkala dan Apache Kafka untuk aliran berkelanjutan atau pengambilan perubahan (CDC).
Bronze — simpan data mentah
Simpan data dalam format sumber (Schema-on-read) agar dapat diproses ulang saat aturan berubah.
Silver — validasi dan bersihkan
Apache Spark memvalidasi, membersihkan, dan menghapus duplikasi sesuai aturan kualitas data (Data Quality Rule), lalu menyimpannya dalam tabel Iceberg.
Gold — data siap digunakan
Agregasikan dan perkaya data sesuai kebutuhan bisnis agar siap untuk laporan BI, analitik, dan AI/ML.
Gunakan data dan pantau sistem
Pengguna mencari data dengan SQL melalui Trino / Dremio dan menghubungkan Tableau, Power BI, atau Jupyter Notebook. Tim TI memantau semua lapisan dalam satu tampilan melalui nimitFlow bersama Prometheus/Grafana serta menerima peringatan melalui LINE atau email.
Penyimpanan (Storage) dipisahkan dari komputasi (Compute), sehingga kapasitas dan sumber daya pemrosesan dapat ditambah secara terpisah sesuai beban kerja tanpa menghentikan sistem. Tabel Iceberg mendukung pembaruan ACID (transaksi disimpan sepenuhnya atau tidak sama sekali), Time Travel untuk melihat kondisi data sebelumnya, dan perubahan skema tanpa membuat ulang tabel.
Dalam arsitektur ini, data berada pada server organisasi Anda (On-Premise), dan pengguna hanya dapat mengakses sesuai izin perannya. Data terpusat memerlukan kontrol akses yang lebih ketat, sehingga autentikasi, otorisasi, enkripsi, dan pencatatan akses dirancang sejak awal, sebagaimana dijelaskan di bawah.
Contoh izin berdasarkan peran (disesuaikan bersama Anda saat perancangan)
| Peran | Bronze | Silver | Gold |
|---|---|---|---|
| Insinyur data | Baca/tulis | Baca/tulis | Tulis melalui pipeline |
| Analis data / BI | Tidak ada akses | Baca data departemen sendiri saja | Baca |
| Ilmuwan data | Baca (data pribadi disamarkan) | Baca | Baca |
| Auditor / Kepatuhan | Baca log audit | Baca log audit | Baca + Asal-usul data |
Data Lakehouse cocok bagi organisasi dengan data di banyak sistem yang membutuhkan laporan dari data yang sama dan harus menyimpannya secara internal. Jika volume atau sumber data masih terbatas, basis data pusat atau nimitFlow mungkin sudah cukup untuk memulai. Jika mesin belum mengumpulkan data, perangkat pengumpul atau sistem sumber harus tersedia terlebih dahulu, misalnya InSensor untuk data sensor. Kami menilai volume data dan jumlah sistem sumber sebelum mengusulkan pendekatan.
Penggunaan yang cocok dan tidak cocok untuk Data Lakehouse
| Pekerjaan | Apakah Data Lakehouse cocok? | Alasan atau hal-hal yang perlu dilakukan |
|---|---|---|
| Data tersebar di beberapa sistem (ERP, MES, basis data, berkas), dan laporan memerlukan kumpulan data yang sama. | Tepat | Satukan data secara terpusat dan periksa kualitas per lapisan sebelum membuat laporan. |
| Data harus tetap di dalam organisasi dengan izin terperinci dan akses yang dapat diaudit. | Tepat | Pasang On-Premise, kelola izin dengan Ranger, dan simpan log audit. |
| Siapkan data produksi, mesin, dan kualitas untuk Predictive Analytics atau AI. | Tepat | Pekerjaan AI menggunakan data lapisan Gold yang telah divalidasi. |
| Tim TI membutuhkan sistem berstandar terbuka tanpa bergantung pada satu vendor. | Tepat | Data disimpan sebagai Parquet / Iceberg menggunakan standar S3 API |
| Volume data masih kecil atau sumbernya sedikit. | Mungkin belum diperlukan | Mulai dengan basis data pusat atau nimitFlow, lalu kembangkan. |
| Kebijakan data mewajibkan penggunaan Cloud. | Dinilai per proyek | Arsitektur ini dirancang untuk server di dalam organisasi. |
| Mesin belum memiliki sistem pengumpulan data. | Perangkat pengumpul data atau sistem sumber diperlukan terlebih dahulu. | Data Lakehouse menerima data dari sistem atau perangkat yang ada; tidak membaca sinyal mesin secara langsung. |
Kami pernah mengintegrasikan data produksi dan manajemen untuk produsen komponen otomotif di Thailand serta menyiapkan data transaksi untuk melatih model Machine Learning bagi organisasi sektor keuangan Thailand. Belum ada proyek dengan arsitektur Data Lakehouse pada halaman ini yang diserahkan; arsitekturnya berasal dari proposal terbaru kami. Pekerjaan berikut adalah pengalaman data terkait, bukan proyek Data Lakehouse yang telah diserahkan.
Baca studi kasus proyek data kami
Kebijakan keamanan TI menentukan lokasi data dan jaringan yang boleh mengaksesnya. Dalam kedua proyek integrasi data produsen komponen otomotif, tim TI pelanggan menetapkan jaringan, izin pemasangan, dan pemeriksaan keamanan sistem cloud. Karena itu, perancangan harus melibatkan tim TI sejak awal.
Angka dari laporan lama harus diperiksa terhadap sumber aslinya sebelum digunakan untuk mengambil keputusan. Validasi data dan perubahan berdasarkan masukan pengguna berlanjut setelah penyerahan pertama, sehingga perlu direncanakan sejak awal. Pekerjaan AI dimulai dengan pembersihan data sebelum pelatihan model, dan sistem baru sebaiknya dipisahkan dari operasi utama agar layanan tidak terganggu.
Proyek Data Lakehouse Anda dimulai dengan meninjau sistem sumber dan kebijakan keamanan bersama tim TI. Kami kemudian membangun pipeline Bronze hingga Gold dengan data percontohan. Anda membandingkan angka pada lapisan Gold dengan laporan yang digunakan, lalu memperluas ke sumber lain setelah angkanya sesuai.
Kami merencanakan proyek Data Lakehouse dalam 5 tahap: desain terperinci; pemasangan server dan platform; integrasi data serta konfigurasi keamanan; pengujian dan mulai operasional; serta dukungan setelah peluncuran dan transfer pengetahuan. Dukungan intensif setelah peluncuran (Hypercare) dan transfer pengetahuan dapat dimasukkan dalam ruang lingkup yang disepakati agar tim TI Anda dapat mengambil alih operasional.
Desain terperinci
Konfirmasikan kebutuhan; siapkan desain tingkat tinggi dan terperinci (HLD/LLD), matriks izin, kebijakan retensi data, dan rencana pengujian.
Pasang server dan platform
Pasang perangkat keras dan Linux, perkuat keamanan sesuai CIS Benchmark, lalu pasang komponen platform.
Integrasikan data dan konfigurasikan keamanan
Bangun pipeline Bronze hingga Gold dengan data percontohan, hubungkan SSO, dan atur izin, enkripsi, serta audit.
Uji dan mulai operasional
Lakukan pengujian penerimaan pengguna (UAT), perbaiki kekurangan, lalu terapkan ke lingkungan produksi.
Dukungan setelah peluncuran dan transfer pengetahuan
Tetapkan masa dukungan setelah peluncuran dan lokakarya untuk setiap tim dalam ruang lingkup yang disepakati.
Dokumen serah terima dibuat dalam bahasa Thai dengan istilah teknis bahasa Inggris: desain sistem, panduan pemasangan, panduan administrasi, panduan operasi harian, panduan pemantauan, dokumen konfigurasi peringatan, panduan pemecahan masalah, dokumen UAT, dokumentasi As-Built, dan materi pelatihan.
Contoh jadwal
Proposal terbaru kami merencanakan sekitar 22 minggu, dengan Hypercare selama 60 hari setelah peluncuran yang dapat melampaui jadwal tersebut, serta transfer pengetahuan minimal 30 jam. Durasi aktual bergantung pada jumlah sumber data dan kesiapan sistem sumber.
| Nama platform | Enterprise Data Lakehouse Platform (tanpa kode model — dikonfigurasi per proyek) |
|---|---|
| Arsitektur | Open Data Lakehouse dengan lapisan Medallion (Bronze–Silver–Gold), memisahkan Storage dan Compute |
| Format tabel / berkas | Apache Iceberg (ACID, penelusuran versi terdahulu, evolusi skema) · Parquet |
| Penyimpanan | MinIO (S3-Compatible) dengan Erasure Coding dan Object Versioning |
| Pemasukan data | Apache Airflow (Batch: JDBC / API / berkas) · Apache Kafka (Streaming, CDC) |
| Pemrosesan | Apache Spark dengan kerangka kerja kualitas data |
| Pencarian data | Trino / Dremio — SQL untuk BI dan analitik |
| Katalog / Asal-usul data | OpenMetadata — katalog data, glosarium bisnis, dan asal-usul data tingkat kolom |
| Keamanan | Apache Ranger (RBAC baris/kolom, Masking) · Keycloak (SSO, MFA) |
| Enkripsi | AES-256 saat disimpan · TLS 1.2 atau lebih baru saat ditransfer |
| Pemantauan sistem | nimitFlow + Prometheus / Grafana — peringatan LINE / email |
| Format Pemasangan | On-Premise pada server Linux organisasi |
Komponen mengikuti arsitektur dalam proposal proyek terbaru Inspektion (Juli 2569 BE). Kapasitas perangkat dan komponen disesuaikan dengan volume data serta ruang lingkup setiap organisasi.
Alur data organisasi
Ikuti alurnya secara berurutan, lalu lihat peran setiap teknologi di bawah. Aturan kualitas data, kontrol akses, dan pemantauan status menghubungkan setiap lapisan.
Hubungkan alur kerja · Pantau status · Kirim peringatan
ERP/MES, basis data SQL, berkas, API, dan IoT
Data dari berbagai sistemAirflow menangani pemasukan data berkala, sedangkan Kafka menangani aliran berkelanjutan dan perubahan dari sistem sumber.
Berkala · Aliran data · CDCSpark memvalidasi dan mentransformasi data, lalu menyusunnya menjadi tabel Iceberg pada penyimpanan S3.
Bronze → Silver → GoldCari data dengan SQL melalui Trino / Dremio, lalu hubungkan ke laporan BI, analitik, dan AI.
Pelaporan · Analitik · AInimitFlow menghubungkan alur kerja dan memantau sistem secara menyeluruh bersama Prometheus / Grafana, sedangkan Airflow, Kafka, dan Spark menangani pekerjaan data sesuai perannya masing-masing.
Pertahankan data dalam format sumber agar dapat diproses ulang nanti.
Data mentah ERP / IoTBersihkan, hapus duplikasi, dan susun struktur data sesuai aturan kualitas.
Data yang telah divalidasi dan dihubungkanRingkas data sesuai sudut pandang bisnis agar tim dapat menggunakannya dalam laporan dan analitik.
Kumpulan data untuk BI / AIKontrol akses · Kualitas data · Katalog · Asal-usul data · Log audit
Komponen mengikuti arsitektur yang diusulkan. Pemilihan dan kapasitas disesuaikan dengan sumber data, beban kerja, dan kebijakan organisasi.
Kelola alur kerja, lihat status operasional, dan kirim peringatan kepada administrator.
Masukkan data secara berkala atau berkelanjutan, lalu validasi dan transformasikan sebelum digunakan.
Pisahkan penyimpanan dari komputasi dengan format tabel dan berkas data terbuka.
Cari data dengan SQL dan hubungkan ke tampilan laporan atau alat analis.
Buat katalog data, glosarium bisnis, dan jejak asal-usul data.
Hubungkan akun organisasi, atur izin, samarkan data, dan audit akses.
nimitFlow, API, dan antarmuka untuk tim
Sumber daya Spark dan Trino dipisahkan dari penyimpanan
Penyimpanan kompatibel S3 beserta rencana pencadangan
Ini adalah arsitektur yang diusulkan untuk proyek, bukan gambaran sistem yang sudah diserahkan kepada pelanggan. Kapasitas Server, pencadangan, dan High Availability harus dirancang serta diuji sesuai ruang lingkup aktual.
Perangkat lunak lapisan data bersifat Open Source; biaya nimitFlow, perangkat keras, sistem operasi, dan layanan mengikuti penawaran harga.
Perangkat lunak lapisan data bersifat Open Source; lisensi nimitFlow mengikuti penawaran harga. Biaya mencakup perangkat keras, sistem operasi, pemasangan, integrasi data, dan dukungan sesuai ruang lingkup.
Mulailah dengan diskusi kebutuhan. Kami meninjau sistem sumber, format data, dan kebijakan keamanan organisasi, menentukan kapasitas sistem berdasarkan volume data, lalu mengusulkan ruang lingkup beserta penawaran harga.
Tidak. Data Lakehouse mengambil data melalui basis data (JDBC), API, berkas, atau CDC, sehingga ERP/MES yang ada tetap dapat beroperasi seperti biasa.
Perangkat lunak lapisan data tidak memiliki biaya lisensi tahunan karena bersifat Open Source. nimitFlow untuk pemantauan adalah perangkat lunak Inspektion dan harganya berdasarkan penawaran. Biaya utama meliputi perangkat keras, sistem operasi, lisensi nimitFlow, pemasangan, integrasi data, dan dukungan sistem.
Tidak. Arsitektur ini dirancang untuk server di dalam organisasi (On-Premise). Jika kebijakan data mengharuskan Cloud, kami menilai setiap proyek berdasarkan kebijakan dan anggaran organisasi.
Hingga tingkat baris. Apache Ranger mendukung izin tingkat tabel, kolom, dan baris, penyamaran data pribadi per kolom, serta log audit setiap akses.
Ya. Perangkat lunak lapisan data bersifat Open Source dan data menggunakan format terbuka. Lokakarya transfer pengetahuan sesuai peran beserta panduan bahasa Thai dapat dimasukkan dalam ruang lingkup. Setelah transfer pengetahuan, tim TI Anda dapat mengelola dan mengembangkan sistem sendiri.
Bergantung pada jumlah sumber data, volume data, dan perangkat keras yang diperlukan. Hubungi tim kami untuk menentukan ruang lingkup dan mendapatkan penawaran. Contoh proposal terbaru merencanakan sekitar 22 minggu, dengan dukungan setelah peluncuran yang dapat berlanjut melewati jadwal tersebut.