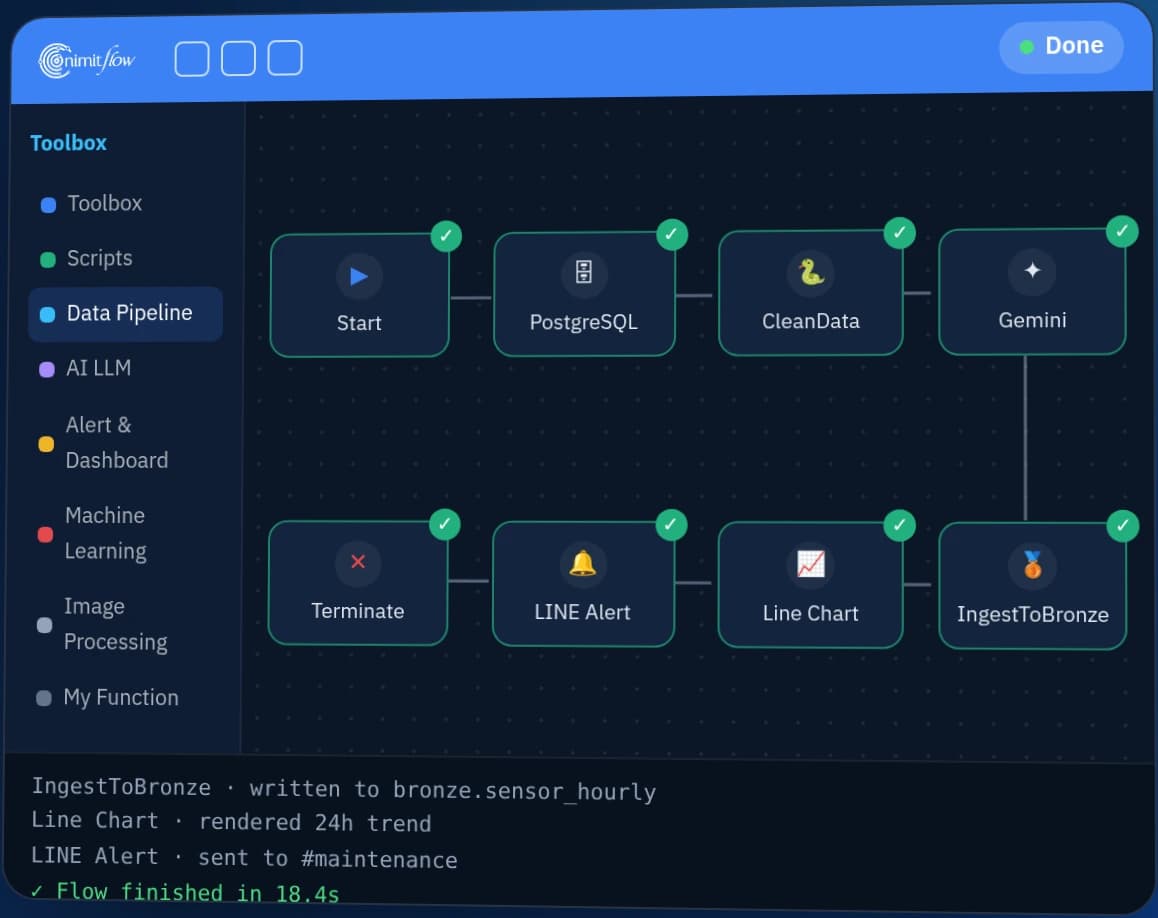
ワークフロー連携とシステム監視
ワークフローを管理し、稼働状況を確認して管理者に通知します。
- nimitFlow
- Prometheus
- Grafana
Modern Data · 組織の統合データ基盤
ERP/MES、データベース、ファイル、IoTのデータをBronze–Silver–Goldの各層に整理し、レポート、分析、AIに活用します。nimitFlowがワークフローの連携とシステム監視を担います。
 ワークフロー連携 · 状態監視 · 通知
元の形式でデータを保持し、後から再処理できるようにします。
品質ルールに従ってデータをクリーニングし、重複を除去して構造化します。
業務の観点でデータを集約し、チームがレポートや分析に使えるようにします。
アクセス制御 · データ品質 · カタログ · リネージ · 監査ログ
複数のシステムからデータを統合する必要があるITチームやデータチーム
ソースシステム、データ形式、必要なアクセス権限の一覧
Data Lakehouseは生データと分析用データを同じシステムに保存する基盤です。当社のData Lakehouse & Pipelineは、既存の業務システム、ファイル、データ収集機器の情報を統合します。データを層ごとに品質検証し、アクセスを制御し、由来を追跡できます。同じデータをレポート、分析、Predictive AnalyticsやEnterprise KM ChatbotなどのAIに活用できます。
多くの組織では、ERP/MESのデータベース、Excelファイル、NAS、生産ライン機器にデータが分散しています。管理しにくい定期実行スクリプトによる統合は、レポート作成を遅らせ、数値の由来の確認も難しくします。AIを始めるたびに、データの収集とクリーニングをやり直すことになります。
Data LakehouseとData Lake・Data Warehouseの違い
Data Lakehouseは、Data Lake(低い保存単価で各種形式の生データを保持)とData Warehouse(構造化テーブルと高速SQL検索)の利点を統合します。S3(オブジェクトストレージの標準)上にParquetやApache Icebergなどのオープン形式で保存するため、特定ベンダーに依存しません。
従来の方式
Data Lakehouse
概要: 同じデータをレポート・分析・AIに活用
Data Lakehouse & Pipelineは5段階で動作します。データソース接続、生データ保存、検証・クリーニング、利用向け整備、ユーザーによる検索です。データ層はOpen Sourceソフトウェアを使い、nimitFlowとPrometheus/Grafanaがシステムを監視します。
データソースを接続
SQLデータベース(Oracle、PostgreSQL、MS SQLなど)、API、ファイル、Google Sheets、IoT機器からデータを取り込みます。バッチ処理にはApache Airflow、継続的なストリームや変更分の取得(CDC)にはApache Kafkaを使用します。
Bronze — 生データを保持
元の形式でデータを保持(Schema-on-read)し、ルール変更時に再処理できるようにします。
Silver — 検証とクリーニング
Apache Sparkがデータ品質ルール(Data Quality Rule)に従って検証、クリーニング、重複除去を行い、Icebergテーブルに保存します。
Gold — 利用可能なデータ
業務の観点でデータを集約・拡充し、BIレポート、分析、AI/MLに使える形に整えます。
データ利用とシステム監視
ユーザーはTrino / Dremio経由でSQL検索し、Tableau、Power BI、Jupyter Notebookに接続します。IT部門はnimitFlowとPrometheus/Grafanaを使ってすべての層を一つの画面で監視し、LINEやメールで通知を受け取れます。
StorageとComputeを分離し、システムを停止せずに処理量に合わせて容量と処理リソースを個別に拡張できます。IcebergテーブルはACID更新(変更をすべて確定するか、まったく確定しない)、過去のデータ状態を参照するTime Travel、テーブル再作成を伴わないスキーマ変更に対応します。
この構成ではデータを組織内サーバー(On-Premise)に保存し、ユーザーは役割に応じて許可されたデータだけにアクセスします。一元化されたデータには厳格な管理が必要なため、下記の認証、権限制御、暗号化、アクセス記録を設計段階から組み込みます。
役割別権限の例(設計時にお客様と調整)
| 役割 | Bronze | Silver | Gold |
|---|---|---|---|
| データエンジニア | 読み書き | 読み書き | パイプライン経由で書き込み |
| データアナリスト / BI | アクセス不可 | 所属部門のデータのみ閲覧 | 読み取り |
| データサイエンティスト | 読み取り(個人情報をマスキング) | 読み取り | 読み取り |
| 監査担当 / コンプライアンス | 監査ログを閲覧 | 監査ログを閲覧 | 読み取り + 来歴 |
Data Lakehouseは、複数のシステムのデータから共通のレポートを作り、データを組織内に保持する必要がある組織に適しています。データ量やソースが少ない場合は、統合データベースやnimitFlowだけで始められることがあります。機械にデータ収集機能がなければ、まずセンサーデータを収集するInSensorなどの機器や元システムが必要です。データ量とソースシステム数を評価して構成を提案します。
Data Lakehouseに適する用途・適さない用途
| 仕事 | Data Lakehouseは適しているか | 理由または行うべきこと |
|---|---|---|
| ERP、MES、データベース、ファイルなどに分散したデータから共通のレポートを作りたい | 適切 | 統合基盤に集約し、各層で品質を検証してからレポートを作成 |
| 組織内でデータを保持し、詳細な権限制御とアクセス監査が必要 | 適切 | On-Premiseに設置し、Rangerで権限を管理して監査ログを保存 |
| 生産・機械・品質のデータをPredictive AnalyticsやAI向けに準備したい | 適切 | AIが検証済みのGold層データを利用 |
| IT部門が特定ベンダーに依存しないオープン標準のシステムを求めている | 適切 | S3 API標準を使いParquet / Iceberg形式で保存 |
| データ量やソースが少ない | 現時点では不要な場合あり | まず統合データベースやnimitFlowで始め、後から拡張 |
| データ方針でCloud利用が必須 | プロジェクトごとに評価 | この構成は組織内サーバー向け |
| 機械にデータ収集の仕組みがない | まずデータ収集機器または元システムが必要 | Data Lakehouseは既存のシステムや機器からデータを受け取り、機械の信号を直接読み取るものではありません。 |
タイの自動車部品メーカー向けに生産・経営データを統合し、タイの金融分野の組織向けにMachine Learningモデルの学習用取引データを整備してきました。このページのData Lakehouse構成による納入実績はまだなく、当社の最新提案に基づく構成です。以下は関連するデータ業務の実績であり、Data Lakehouseの納入事例ではありません。
データ関連の事例を読む
IT部門のセキュリティ方針によって、データの配置先とアクセス可能なネットワークが決まります。自動車部品メーカーの両統合案件では、顧客のIT部門がネットワーク、インストール権限、クラウドシステムのセキュリティ確認項目を定めました。そのため設計段階からIT部門と協働する必要があります。
既存レポートから取り込んだ数値は、意思決定に使う前に原本との照合が必要です。初回納入後もデータ検証とユーザー意見に応じた修正が続くため、最初から計画に含めます。AIではモデル学習前のデータクリーニングが必要であり、サービスへの影響を避けるため新システムを基幹業務から分離することが望まれます。
Data Lakehouseプロジェクトは、お客様のIT部門と元システム・セキュリティ方針を調査することから始まります。まず試験用データでBronzeからGoldまでのパイプラインを構築します。Gold層の数値を既存レポートと照合し、一致してから他のデータソースへ拡張します。
Data Lakehouseを5段階で計画します。詳細設計、サーバー・プラットフォーム設置、データ連携・セキュリティ設定、テスト・運用開始、開始後の支援と知識移管です。IT部門が運用を引き継げるよう、運用開始後の集中支援(Hypercare)と知識移管を合意する業務範囲に含められます。
詳細設計
要件を確認し、基本・詳細設計(HLD/LLD)、権限表、データ保持方針、テスト計画を作成します。
サーバーとプラットフォームを設置
ハードウェアとLinuxを設置し、CIS Benchmarkに基づくセキュリティ設定後、プラットフォームの各要素を導入します。
データ連携とセキュリティ設定
試験用データでBronzeからGoldまでのパイプラインを構築し、SSO連携、権限、暗号化、監査を設定します。
テストと運用開始
ユーザー受入テスト(UAT)を行い、不具合を修正して本番環境へ移行します。
運用開始後の支援と知識移管
合意する業務範囲で、運用開始後の支援期間と各チーム向けワークショップを定めます。
納品文書は英語の技術用語を残したタイ語で作成します。システム設計書、設置手順書、管理マニュアル、日常運用ガイド、監視マニュアル、通知設定書、障害対応ガイド、UAT文書、実際の構成を記録したAs-Built文書、研修資料が含まれます。
期間の例
最新提案の計画例は約22週間で、運用開始後のHypercareは60日間(計画期間を超えて続く場合あり)、知識移管は最低30時間です。実際の期間はソース数と元システムの準備状況によって変わります。
| プラットフォーム名 | Enterprise Data Lakehouse Platform(型番なし — プロジェクトごとに構成) |
|---|---|
| アーキテクチャ | StorageとComputeを分離したMedallion構成(Bronze–Silver–Gold)のOpen Data Lakehouse |
| テーブル/ファイル形式 | Apache Iceberg(ACID、過去時点の参照、スキーマ変更)· Parquet |
| ストレージ | Erasure CodingとObject Versioningを備えたMinIO(S3-Compatible) |
| データ取り込み | Apache Airflow(Batch:JDBC / API / ファイル)· Apache Kafka(Streaming, CDC) |
| 処理 | Data Quality Frameworkを備えたApache Spark |
| データ検索 | Trino / Dremio — BI・分析向けSQL |
| カタログ / データの来歴 | OpenMetadata — Data Catalog、Business Glossary、列レベルのLineage |
| セキュリティ | Apache Ranger(行・列レベルのRBAC、Masking)· Keycloak(SSO, MFA) |
| 暗号化 | 保存時はAES-256 · 転送時はTLS 1.2以上 |
| システム監視 | nimitFlow + Prometheus / Grafana — LINE/メール通知 |
| インストール形式 | 組織のLinuxサーバー上にOn-Premise設置 |
Inspektionの最新プロジェクト提案(仏暦2569年の七月)の構成要素です。機器の規模と構成は各組織のデータ量・業務範囲に合わせて調整します。
組織のデータの流れ
図を順にたどり、下の各技術の役割をご覧ください。すべての層をデータ品質ルール、アクセス制御、状態監視でつなぎます。
ワークフロー連携 · 状態監視 · 通知
ERP/MES、SQLデータベース、ファイル、API、IoT
複数システムのデータAirflowが定期的な取り込みを、Kafkaが継続的な取り込みと元データの変更の受信を担います。
バッチ · ストリーミング · CDCSparkでデータを検証・変換し、S3ストレージ上のIcebergテーブルに整理します。
Bronze → Silver → GoldTrino / Dremio経由でSQL検索し、BIレポート、分析、AIへ接続します。
レポート · 分析 · AInimitFlowがワークフローを連携し、Prometheus / Grafanaとともに全体を監視します。Airflow、Kafka、Sparkは、それぞれの役割に応じたデータ処理を担います。
元の形式でデータを保持し、後から再処理できるようにします。
ERP / IoTの生データ品質ルールに従ってデータをクリーニングし、重複を除去して構造化します。
検証・統合済みのデータ業務の観点でデータを集約し、チームがレポートや分析に使えるようにします。
BI / AI向けデータセットアクセス制御 · データ品質 · カタログ · リネージ · 監査ログ
提案構成に基づく要素です。データソース、処理量、組織の方針に応じて選定・サイジングします。
ワークフローを管理し、稼働状況を確認して管理者に通知します。
データをバッチまたは継続的に取り込み、利用前に検証・変換します。
ストレージと処理リソースを分離し、オープンなテーブル形式とファイル形式を使います。
SQLでデータを検索し、レポート画面や分析ツールに接続します。
データカタログ、業務用語集、データリネージを整備します。
組織のアカウントを連携し、権限設定、データマスキング、アクセス監査を行います。
nimitFlow、API、チーム向け画面
SparkとTrinoのリソースをストレージから分離
バックアップ計画を備えたS3互換ストレージ
これはプロジェクト向けの提案構成であり、顧客への納入済みシステムを示すものではありません。Serverの規模、バックアップ、High Availabilityは実際の業務範囲に合わせて設計・検証します。
データ層のソフトウェアはOpen Sourceです。nimitFlow、ハードウェア、OS、サービスの費用は見積もりに従います。
データ層のソフトウェアはOpen Sourceで、nimitFlowのライセンスは見積もりに従います。費用には業務範囲に応じたハードウェア、OS、設置、データ連携、保守サービスが含まれます。
まず課題をご相談ください。元システム、データ形式、組織のセキュリティ方針を調査し、データ量からシステム規模を評価したうえで業務範囲と見積もりを提案します。
必要ありません。Data Lakehouseはデータベース(JDBC)、API、ファイル、CDCを通じてデータを取得するため、既存ERP/MESはそのまま稼働できます。
データ層のソフトウェアはOpen Sourceのため年間ライセンス料はありません。監視に使うnimitFlowはInspektionのソフトウェアで、見積もりに基づき課金します。主な費用はハードウェア、OS、nimitFlowライセンス、設置、データ連携、システム保守です。
必要ありません。この構成は組織内サーバー(On-Premise)への設置を前提としています。データ方針上Cloudが必要な場合は、組織の方針と予算に応じてプロジェクトごとに適合性を評価します。
行単位まで設定できます。Apache Rangerはテーブル・列・行単位の権限、列単位での個人情報マスキングに対応し、すべてのアクセスを監査ログに記録します。
はい。データ層のソフトウェアはOpen Sourceで、データはオープン形式で保存します。役割別の知識移管ワークショップとタイ語マニュアルを業務範囲に含められます。知識移管後は、お客様のIT部門で運用・拡張できます。
データソース数、データ量、必要なハードウェアによって変わります。業務範囲の評価と見積もりについてご相談ください。最新提案の例では約22週間を計画しており、運用開始後の支援はその期間を超えて続く場合があります。