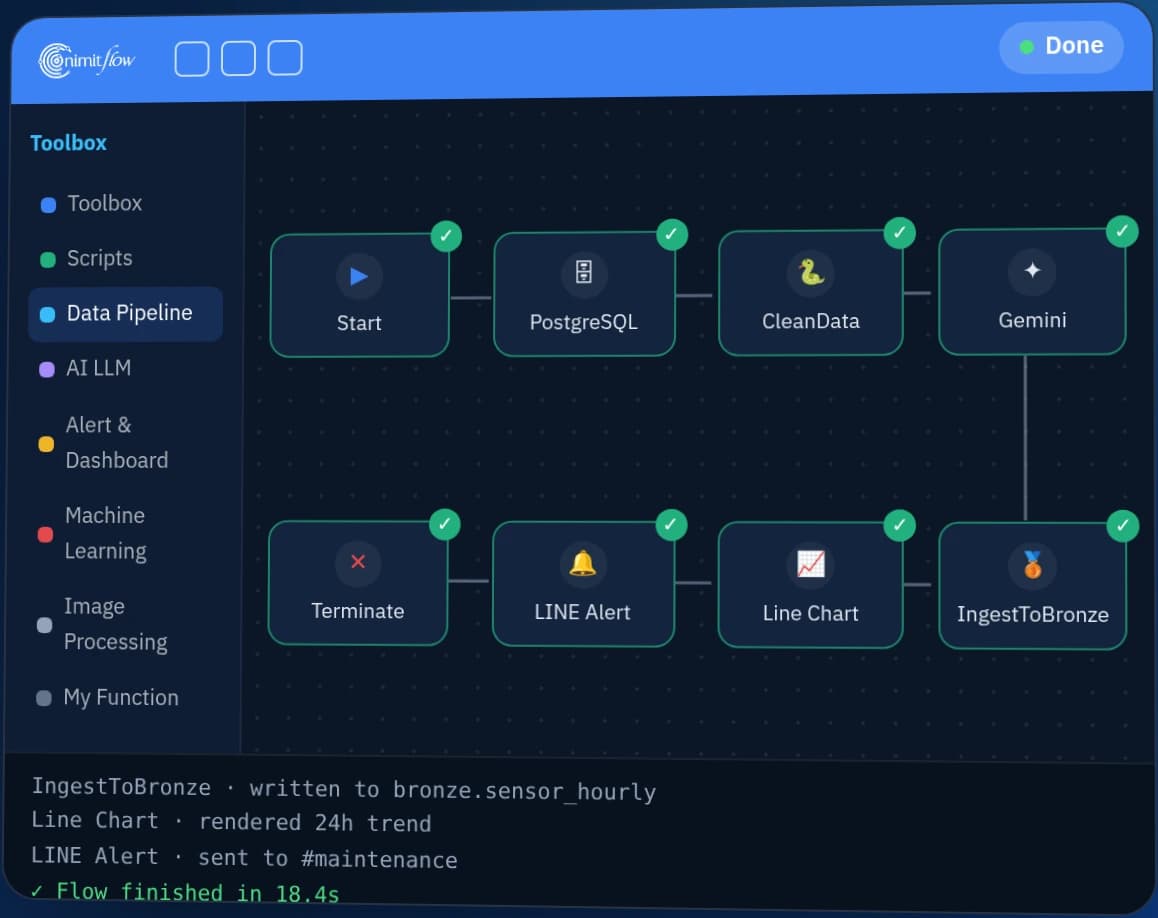
เชื่อมงานและติดตามระบบ
จัดเวิร์กโฟลว์ ดูสถานะการทำงาน และแจ้งเตือนให้ผู้ดูแล
- nimitFlow
- Prometheus
- Grafana
Modern Data · คลังข้อมูลกลางองค์กร
รวมข้อมูลจาก ERP/MES ฐานข้อมูล ไฟล์ และ IoT จัดเป็นชั้น Bronze–Silver–Gold เพื่อทำรายงาน วิเคราะห์ และต่อยอด AI โดยมี nimitFlow เชื่อมเวิร์กโฟลว์และติดตามระบบ
 เชื่อมเวิร์กโฟลว์ · ติดตามสถานะ · แจ้งเตือน
ทีมไอทีและทีมข้อมูลที่ต้องรวมข้อมูลจากหลายระบบ
รายชื่อระบบต้นทาง รูปแบบข้อมูล และสิทธิ์การเข้าถึงที่ต้องใช้
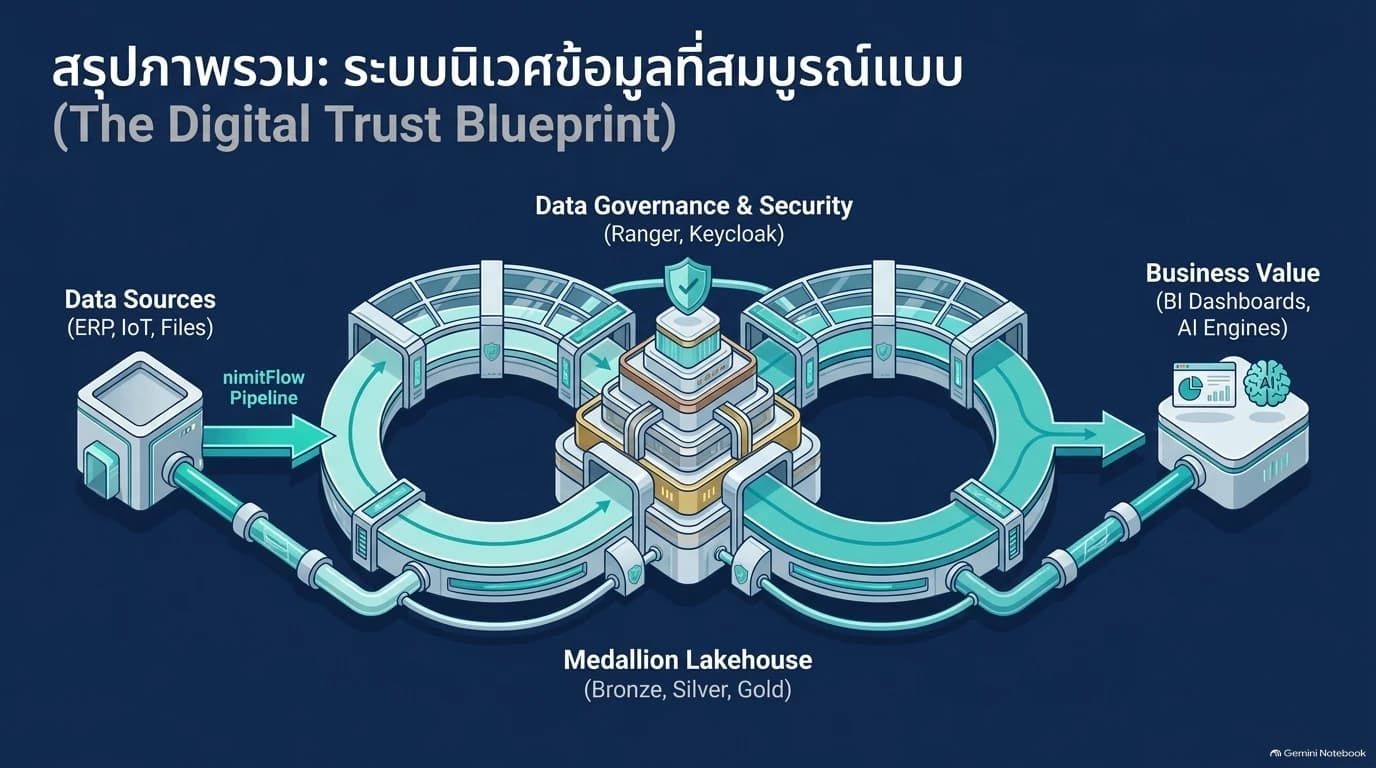
Data Lakehouse คือคลังข้อมูลที่เก็บทั้งข้อมูลดิบและข้อมูลพร้อมวิเคราะห์ไว้ในระบบเดียว Data Lakehouse & Pipeline ของเรารวมข้อมูลจากระบบเดิมขององค์กร ไฟล์ และอุปกรณ์ที่เก็บข้อมูลอยู่แล้ว เข้าคลังกลางนี้ ข้อมูลผ่านการตรวจคุณภาพเป็นชั้น คุมสิทธิ์ได้ และตรวจย้อนกลับได้ว่ามาจากแหล่งใด จากนั้นข้อมูลชุดเดียวกันใช้ได้ทั้งรายงาน งานวิเคราะห์ และ AI เช่น Predictive Analytics และ Enterprise KM Chatbot
หลายองค์กรเก็บข้อมูลไว้คนละที่ ทั้งฐานข้อมูลของระบบ ERP/MES ไฟล์ Excel เครื่อง NAS และข้อมูลจากอุปกรณ์ในไลน์ผลิต การรวมข้อมูลมักใช้สคริปต์ตั้งเวลาที่ดูแลยาก รายงานจึงช้า และตรวจที่มาของตัวเลขได้ยาก เมื่อจะเริ่มงาน AI ก็ต้องรวบรวมและทำความสะอาดข้อมูลใหม่ทุกครั้ง
Data Lakehouse ต่างจาก Data Lake และ Data Warehouse อย่างไร
Data Lakehouse รวมข้อดีของ Data Lake (เก็บข้อมูลดิบได้ทุกรูปแบบในราคาต่อพื้นที่ต่ำ) กับ Data Warehouse (ตารางที่มีโครงสร้าง ค้นด้วย SQL ได้เร็ว) ไว้ในระบบเดียว ข้อมูลเก็บเป็นไฟล์รูปแบบเปิด (Parquet และ Apache Iceberg) บนพื้นที่เก็บข้อมูลแบบ S3 (มาตรฐานพื้นที่เก็บข้อมูลแบบออบเจกต์) จึงไม่ผูกกับผู้ขายรายใด
แบบเดิม
Data Lakehouse
สรุป: ข้อมูลชุดเดียวกันใช้ได้ทั้งรายงาน งานวิเคราะห์ และ AI
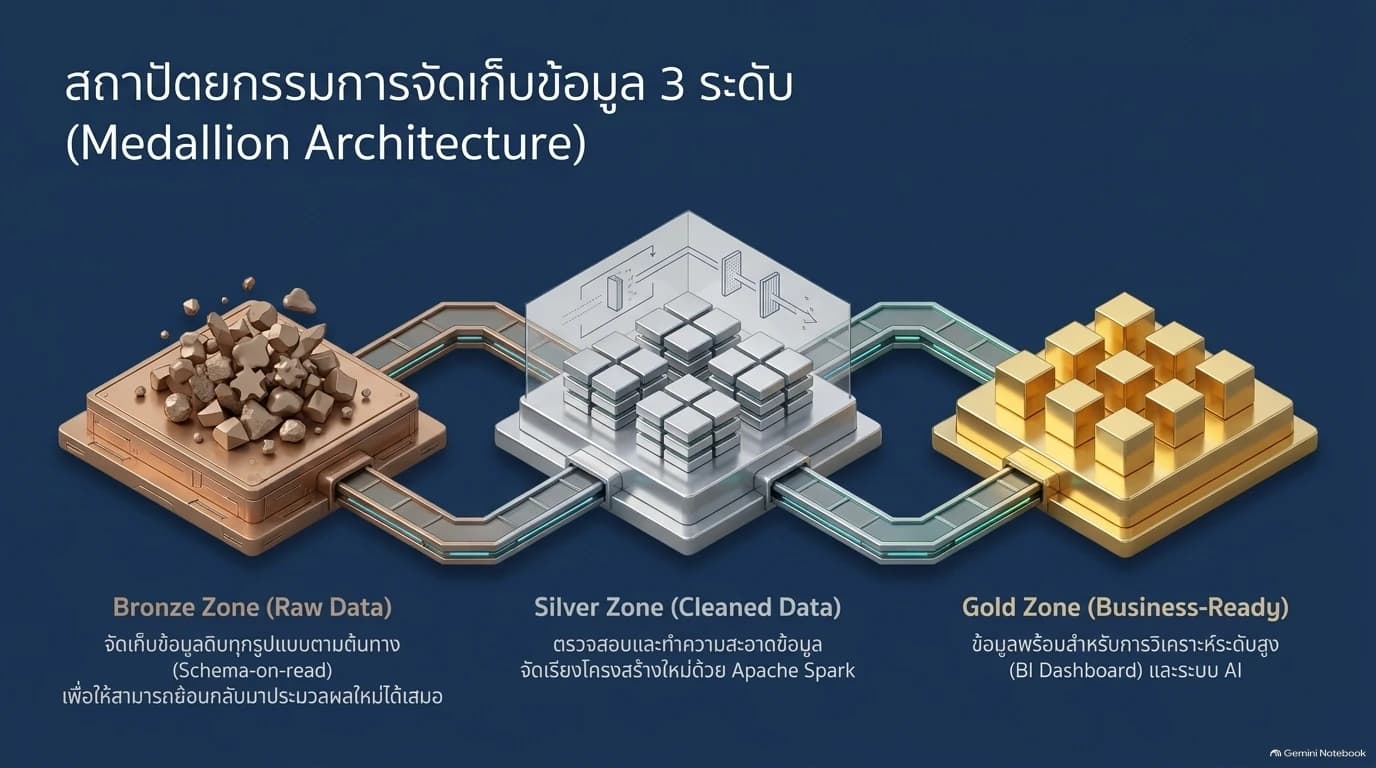
Data Lakehouse & Pipeline ทำงานเป็น 5 ขั้น คือ เชื่อมแหล่งข้อมูล เก็บข้อมูลดิบ ตรวจและทำความสะอาด จัดข้อมูลพร้อมใช้ และเปิดให้ผู้ใช้ค้นข้อมูล ซอฟต์แวร์ในชั้นข้อมูลเป็น Open Source ส่วนการติดตามระบบใช้ nimitFlow ร่วมกับ Prometheus/Grafana
เชื่อมต่อแหล่งข้อมูล
รับข้อมูลจากฐานข้อมูล SQL (เช่น Oracle, PostgreSQL, MS SQL) API ไฟล์ Google Sheets และอุปกรณ์ IoT ด้วย Apache Airflow สำหรับงานเป็นรอบ และ Apache Kafka สำหรับข้อมูลต่อเนื่องหรือดึงเฉพาะส่วนที่เปลี่ยน (CDC)
Bronze — เก็บข้อมูลดิบ
เก็บข้อมูลตามรูปแบบต้นทางไว้ก่อน (Schema-on-read) จึงย้อนกลับมาประมวลผลใหม่ได้เมื่อกติกาเปลี่ยน
Silver — ตรวจและทำความสะอาด
Apache Spark ตรวจความถูกต้อง ทำความสะอาด และตัดข้อมูลซ้ำ ตามกฎคุณภาพข้อมูล (Data Quality Rule) แล้วเก็บเป็นตาราง Iceberg
Gold — ข้อมูลพร้อมใช้
สรุปและเสริมข้อมูลตามมุมมองธุรกิจ พร้อมสำหรับรายงาน BI งานวิเคราะห์ และ AI/ML
ใช้งานและติดตามระบบ
ผู้ใช้ค้นข้อมูลด้วย SQL ผ่าน Trino / Dremio ต่อ Tableau, Power BI หรือ Jupyter Notebook ส่วนฝ่ายไอทีเห็นสถานะทุกชั้นในจอเดียวผ่าน nimitFlow ร่วมกับ Prometheus/Grafana และรับแจ้งเตือนทาง LINE หรืออีเมล
ชั้นเก็บข้อมูล (Storage) แยกจากชั้นประมวลผล (Compute) คุณจึงเพิ่มพื้นที่หรือเพิ่มเครื่องประมวลผลแยกกันได้ตามปริมาณงาน โดยไม่ต้องหยุดระบบ ตาราง Iceberg รองรับการแก้ไขข้อมูลแบบ ACID (แต่ละครั้งบันทึกสำเร็จครบ หรือไม่บันทึกเลย) ย้อนดูข้อมูล ณ เวลาก่อนหน้า (Time Travel) และปรับโครงสร้างตารางได้โดยไม่ต้องสร้างใหม่
ในสถาปัตยกรรมนี้ ข้อมูลเก็บบนเซิร์ฟเวอร์ในองค์กรของคุณ (On-Premise) และผู้ใช้เข้าถึงได้ตามสิทธิ์ของบทบาทเท่านั้น ข้อมูลที่รวมไว้ที่เดียวต้องคุมการเข้าถึงให้รัดกุมกว่าเดิม เราจึงออกแบบการยืนยันตัวตน การคุมสิทธิ์ การเข้ารหัส และการบันทึกการเข้าถึงไว้ตั้งแต่ต้น ตามรายการด้านล่าง
ตัวอย่างการแบ่งสิทธิ์ตามบทบาท (ปรับร่วมกับคุณในขั้นออกแบบ)
| บทบาท | Bronze | Silver | Gold |
|---|---|---|---|
| Data Engineer | อ่าน/เขียน | อ่าน/เขียน | เขียนผ่าน Pipeline |
| Data Analyst / BI | ไม่มีสิทธิ์ | อ่านเฉพาะส่วนงาน | อ่าน |
| Data Scientist | อ่าน (ข้อมูลส่วนบุคคลถูกปิดบัง) | อ่าน | อ่าน |
| Auditor / Compliance | อ่าน Audit Log | อ่าน Audit Log | อ่าน + Lineage |
Data Lakehouse เหมาะกับองค์กรที่มีข้อมูลอยู่หลายระบบ ต้องการรายงานจากข้อมูลชุดเดียวกัน และต้องเก็บข้อมูลไว้ในองค์กร Data Lakehouse ไม่เหมาะกับองค์กรที่ข้อมูลยังน้อยหรือมาจากไม่กี่แหล่ง เพราะฐานข้อมูลกลางหรือ nimitFlow อาจพอสำหรับเริ่มต้น ถ้าเครื่องจักรยังไม่มีระบบเก็บข้อมูล ต้องมีอุปกรณ์เก็บข้อมูลหรือระบบต้นทางก่อน เช่น อุปกรณ์เก็บข้อมูลจากเซนเซอร์ InSensor เราประเมินจากปริมาณข้อมูลและจำนวนระบบต้นทางก่อนเสนอแนวทาง
งานที่เหมาะและไม่เหมาะกับ Data Lakehouse
| งาน | เหมาะกับ Data Lakehouse ไหม | เหตุผลหรือสิ่งที่ต้องทำ |
|---|---|---|
| ข้อมูลอยู่หลายระบบ (ERP, MES, ฐานข้อมูล, ไฟล์) และต้องการรายงานจากข้อมูลชุดเดียวกัน | เหมาะ | รวมเข้าคลังกลางและตรวจคุณภาพเป็นชั้นก่อนออกรายงาน |
| ต้องเก็บข้อมูลไว้ในองค์กร คุมสิทธิ์ละเอียด และตรวจการเข้าถึงย้อนหลัง | เหมาะ | ติดตั้ง On-Premise คุมสิทธิ์ด้วย Ranger และเก็บ Audit Log |
| เตรียมข้อมูลการผลิต เครื่องจักร และคุณภาพ ให้ Predictive Analytics หรือ AI | เหมาะ | งาน AI ดึงข้อมูลชั้น Gold ที่ผ่านการตรวจแล้วไปใช้ |
| ฝ่ายไอทีต้องการระบบมาตรฐานเปิด ไม่ผูกกับผู้ขายรายเดียว | เหมาะ | ข้อมูลเก็บเป็น Parquet / Iceberg บนมาตรฐาน S3 API |
| ข้อมูลยังน้อยหรือมาจากไม่กี่แหล่ง | อาจยังไม่จำเป็น | เริ่มจากฐานข้อมูลกลางหรือ nimitFlow ก่อน แล้วค่อยขยาย |
| นโยบายข้อมูลกำหนดให้ใช้ Cloud | ประเมินเป็นรายโครงการ | สถาปัตยกรรมนี้ออกแบบสำหรับเซิร์ฟเวอร์ในองค์กร |
| เครื่องจักรยังไม่มีระบบเก็บข้อมูล | ต้องมีอุปกรณ์เก็บข้อมูลหรือระบบต้นทางก่อน | Data Lakehouse รับข้อมูลจากระบบหรืออุปกรณ์ที่มีอยู่ ไม่ได้อ่านสัญญาณจากเครื่องจักรเอง |
เราเคยรวมข้อมูลการผลิตและข้อมูลบริหารให้ผู้ผลิตชิ้นส่วนยานยนต์ในไทย และเคยเตรียมข้อมูลธุรกรรมเพื่อสอนโมเดล Machine Learning ให้องค์กรในภาคการเงินของไทย Data Lakehouse ตามสถาปัตยกรรมในหน้านี้ยังไม่มีโครงการที่ส่งมอบแล้ว สถาปัตยกรรมนี้มาจากข้อเสนอโครงการล่าสุดของเรา งานด้านล่างจึงเป็นงานข้อมูลที่ใกล้เคียงที่สุด ไม่ใช่โครงการ Data Lakehouse
อ่านเคสงานข้อมูลที่เราทำ
นโยบายความปลอดภัยของฝ่ายไอทีเป็นตัวกำหนดว่าข้อมูลวางที่ไหน และเปิดให้เข้าถึงจากเครือข่ายใดได้ ในงานรวมข้อมูลทั้งสองงานของผู้ผลิตชิ้นส่วนยานยนต์ ฝ่ายไอทีของลูกค้าเป็นผู้กำหนดเครือข่าย สิทธิ์การติดตั้ง และแบบตรวจความปลอดภัยของระบบบนคลาวด์ การออกแบบจึงต้องทำร่วมกับฝ่ายไอทีตั้งแต่ต้น
ตัวเลขจากไฟล์รายงานเดิมต้องตรวจเทียบกับรายงานต้นฉบับก่อนให้ผู้ใช้ใช้ตัดสินใจ งานตรวจความถูกต้องของข้อมูลและปรับตามความเห็นของผู้ใช้ดำเนินต่อหลังส่งมอบเฟสแรก จึงต้องวางไว้ในแผนตั้งแต่ต้น ส่วนงาน AI ต้องเริ่มจากทำความสะอาดข้อมูลก่อนสอนโมเดล และควรแยกระบบใหม่ออกจากระบบงานหลัก เพื่อไม่กระทบการให้บริการ
โครงการ Data Lakehouse ของคุณจึงเริ่มจากสำรวจระบบต้นทางและนโยบายความปลอดภัยร่วมกับฝ่ายไอทีของคุณ แล้วสร้างเส้นทางส่งข้อมูลจาก Bronze ถึง Gold กับข้อมูลชุดนำร่องก่อน คุณตรวจตัวเลขในชั้น Gold เทียบกับรายงานเดิมที่ใช้อยู่ เมื่อตัวเลขตรงกันจึงขยายไปแหล่งข้อมูลอื่น
เราวางโครงการ Data Lakehouse เป็น 5 ขั้น ได้แก่ ออกแบบรายละเอียด ติดตั้งเซิร์ฟเวอร์และแพลตฟอร์ม เชื่อมข้อมูลและตั้งค่าความปลอดภัย ทดสอบและเริ่มใช้งาน และดูแลหลังเริ่มใช้งานพร้อมถ่ายทอดความรู้ ช่วงดูแลเข้มข้นหลังเริ่มใช้งาน (Hypercare) และการถ่ายทอดความรู้ กำหนดไว้ในขอบเขตงานได้ เพื่อให้ฝ่ายไอทีของคุณดูแลระบบต่อเอง
ออกแบบรายละเอียด
ยืนยันความต้องการ ออกแบบระบบภาพรวมและรายละเอียด (HLD/LLD) ตารางสิทธิ์ นโยบายอายุข้อมูล และแผนทดสอบ
ติดตั้งเซิร์ฟเวอร์และแพลตฟอร์ม
ติดตั้งเครื่อง ระบบปฏิบัติการ Linux ตั้งค่าความปลอดภัยตาม CIS Benchmark แล้วติดตั้งองค์ประกอบของแพลตฟอร์ม
เชื่อมข้อมูลและตั้งค่าความปลอดภัย
สร้างเส้นทางส่งข้อมูล (Pipeline) จาก Bronze ถึง Gold กับข้อมูลชุดนำร่อง เชื่อม SSO ตั้งสิทธิ์ การเข้ารหัส และ Audit
ทดสอบและเริ่มใช้งาน
ทดสอบร่วมกับผู้ใช้ (UAT) แก้ข้อบกพร่อง แล้วย้ายขึ้นใช้งานจริง
ดูแลหลังเริ่มใช้งานและถ่ายทอดความรู้
กำหนดช่วงดูแลหลังเริ่มใช้งานและ Workshop ของแต่ละทีมไว้ในขอบเขตงานที่ตกลง
เอกสารส่งมอบทำเป็นภาษาไทย (คงศัพท์เทคนิคภาษาอังกฤษ) ได้แก่ เอกสารออกแบบระบบ คู่มือติดตั้ง คู่มือบริหารระบบ คู่มือปฏิบัติการประจำวัน คู่มือติดตามระบบ เอกสารตั้งค่าการแจ้งเตือน คู่มือแก้ปัญหา เอกสาร UAT เอกสารระบบตามที่ติดตั้งจริง (As-Built) และเอกสารอบรม
ตัวอย่างระยะเวลา
แผนงานในข้อเสนอโครงการล่าสุดของเราระบุแผนประมาณ 22 สัปดาห์ และช่วง Hypercare 60 วันหลังเริ่มใช้งานที่อาจต่อเนื่องเกินแผนดังกล่าว และถ่ายทอดความรู้ไม่น้อยกว่า 30 ชั่วโมง ระยะเวลาจริงขึ้นกับจำนวนแหล่งข้อมูลและความพร้อมของระบบต้นทาง
| ชื่อแพลตฟอร์ม | Enterprise Data Lakehouse Platform (ไม่มีรหัสรุ่น — จัดชุดตามโครงการ) |
|---|---|
| สถาปัตยกรรม | Open Data Lakehouse แบบ Medallion (Bronze–Silver–Gold) แยก Storage กับ Compute |
| รูปแบบตาราง / ไฟล์ | Apache Iceberg (ACID, Time Travel, Schema Evolution) · Parquet |
| พื้นที่เก็บข้อมูล | MinIO (S3-Compatible) พร้อม Erasure Coding และ Object Versioning |
| รับข้อมูล (Ingestion) | Apache Airflow (Batch: JDBC / API / ไฟล์) · Apache Kafka (Streaming, CDC) |
| ประมวลผล | Apache Spark พร้อม Data Quality Framework |
| ค้นข้อมูล (Query) | Trino / Dremio — SQL สำหรับ BI และงานวิเคราะห์ |
| Catalog / Lineage | OpenMetadata — Data Catalog, Business Glossary, Lineage ระดับคอลัมน์ |
| ความปลอดภัย | Apache Ranger (RBAC ถึงแถว/คอลัมน์, Masking) · Keycloak (SSO, MFA) |
| การเข้ารหัส | AES-256 ขณะจัดเก็บ · TLS 1.2 ขึ้นไประหว่างรับส่ง |
| ติดตามระบบ | nimitFlow + Prometheus / Grafana — แจ้งเตือนทาง LINE / อีเมล |
| รูปแบบติดตั้ง | On-Premise บนเซิร์ฟเวอร์ Linux ขององค์กร |
องค์ประกอบตามสถาปัตยกรรมที่ Inspektion เสนอในโครงการล่าสุด (ก.ค. 2569) — ขนาดเครื่องและองค์ประกอบปรับตามปริมาณข้อมูลและขอบเขตงานของแต่ละองค์กร
เส้นทางข้อมูลขององค์กร
อ่านผังตามลำดับ แล้วดูหน้าที่ของแต่ละเทคโนโลยีด้านล่าง ทุกชั้นเชื่อมกันด้วยกฎคุณภาพข้อมูล สิทธิ์การเข้าถึง และการติดตามสถานะ
เชื่อมเวิร์กโฟลว์ · ติดตามสถานะ · แจ้งเตือน
ERP/MES ฐานข้อมูล SQL ไฟล์ API และ IoT
ข้อมูลจากหลายระบบAirflow รับเป็นรอบ ส่วน Kafka รับต่อเนื่องและรองรับข้อมูลที่เปลี่ยนจากต้นทาง
Batch · Streaming · CDCSpark ตรวจและแปลงข้อมูล จัดตาราง Iceberg บนพื้นที่เก็บแบบ S3
Bronze → Silver → Goldค้นด้วย SQL ผ่าน Trino / Dremio ต่อรายงาน BI งานวิเคราะห์ และ AI
รายงาน · วิเคราะห์ · AInimitFlow เชื่อมเวิร์กโฟลว์และติดตามภาพรวมร่วมกับ Prometheus / Grafana ส่วน Airflow, Kafka และ Spark รับผิดชอบงานข้อมูลตามบทบาทของแต่ละระบบ
รักษาข้อมูลตามรูปแบบต้นทาง เพื่อย้อนกลับมาประมวลผลใหม่ได้
ข้อมูลดิบจาก ERP / IoTทำความสะอาด ตัดข้อมูลซ้ำ และจัดโครงสร้างตามกฎคุณภาพ
ข้อมูลที่ตรวจและเชื่อมกันแล้วสรุปข้อมูลตามมุมมองธุรกิจ ให้ทีมใช้ต่อในรายงานและงานวิเคราะห์
ชุดข้อมูลสำหรับ BI / AIสิทธิ์การเข้าถึง · คุณภาพข้อมูล · Catalog · Lineage · Audit Log
องค์ประกอบตามสถาปัตยกรรมที่เสนอ เลือกใช้และกำหนดขนาดตามแหล่งข้อมูล ปริมาณงาน และนโยบายขององค์กร
จัดเวิร์กโฟลว์ ดูสถานะการทำงาน และแจ้งเตือนให้ผู้ดูแล
นำข้อมูลเข้าแบบเป็นรอบหรือต่อเนื่อง แล้วตรวจและแปลงก่อนใช้งาน
แยกพื้นที่เก็บข้อมูลจากเครื่องประมวลผล พร้อมตารางและไฟล์ข้อมูลรูปแบบเปิด
ใช้ SQL ค้นข้อมูล แล้วต่อเข้าหน้ารายงานหรือเครื่องมือของนักวิเคราะห์
ทำบัญชีรายการข้อมูล คำศัพท์ธุรกิจ และเส้นทางที่มาของข้อมูล
เชื่อมบัญชีองค์กร กำหนดสิทธิ์ ปิดบังข้อมูล และตรวจการเข้าถึง
nimitFlow, API และหน้าจอสำหรับทีมงาน
Spark และ Trino แยกทรัพยากรจากพื้นที่เก็บ
พื้นที่ S3-Compatible พร้อมแผนสำรองข้อมูล
เป็นสถาปัตยกรรมที่เสนอสำหรับโครงการ ไม่ใช่ภาพระบบที่ส่งมอบให้ลูกค้าแล้ว ขนาด Server การสำรองข้อมูล และ High Availability ต้องออกแบบและทดสอบตามขอบเขตงานจริง
ซอฟต์แวร์ชั้นข้อมูลเป็น Open Source ส่วน nimitFlow ฮาร์ดแวร์ ระบบปฏิบัติการ และบริการมีค่าใช้จ่ายตามใบเสนอราคา
ซอฟต์แวร์ชั้นข้อมูลเป็น Open Source ส่วน nimitFlow มีสิทธิ์ใช้งานตามใบเสนอราคา ค่าใช้จ่ายรวมฮาร์ดแวร์ ระบบปฏิบัติการ งานติดตั้ง เชื่อมข้อมูล และบริการดูแลตามขอบเขตงาน
เริ่มจากนัดคุยโจทย์กับเรา เราสำรวจระบบต้นทาง รูปแบบข้อมูล และนโยบายความปลอดภัยขององค์กรคุณ แล้วประเมินขนาดระบบจากปริมาณข้อมูล จากนั้นเสนอขอบเขตงานพร้อมใบเสนอราคา
ไม่ต้อง Data Lakehouse ดึงข้อมูลจากระบบเดิมผ่านฐานข้อมูล (JDBC) API ไฟล์ หรือ CDC ระบบ ERP/MES ที่คุณใช้อยู่จึงทำงานต่อได้ตามเดิม
ไม่มีค่า License รายปีของซอฟต์แวร์ชั้นข้อมูล เพราะเป็น Open Source ส่วน nimitFlow ที่ใช้ติดตามระบบเป็นซอฟต์แวร์ของ Inspektion และคิดตามใบเสนอราคา ค่าใช้จ่ายหลักคือฮาร์ดแวร์ ระบบปฏิบัติการ สิทธิ์ใช้ nimitFlow งานติดตั้งและเชื่อมข้อมูล และบริการดูแลระบบ
ข้อมูลไม่ต้องออกนอกองค์กร เพราะสถาปัตยกรรมนี้ออกแบบให้ติดตั้งบนเซิร์ฟเวอร์ในองค์กร (On-Premise) หากนโยบายข้อมูลต้องการใช้ Cloud เราประเมินความเหมาะสมเป็นรายโครงการตามนโยบายและงบประมาณขององค์กร
ละเอียดถึงระดับแถว Apache Ranger กำหนดสิทธิ์ได้ถึงระดับตาราง คอลัมน์ และแถว ปิดบังข้อมูลส่วนบุคคลระดับคอลัมน์ได้ และทุกการเข้าถึงถูกบันทึกเป็น Audit Log
ได้ ซอฟต์แวร์ชั้นข้อมูลเป็น Open Source และข้อมูลเก็บในรูปแบบเปิด คุณกำหนด Workshop ถ่ายทอดความรู้ตามบทบาทพร้อมคู่มือภาษาไทยไว้ในขอบเขตงานได้ เมื่อผ่านการถ่ายทอดความรู้แล้ว ฝ่ายไอทีของคุณบริหารและต่อยอดระบบได้เอง
ขึ้นกับจำนวนแหล่งข้อมูล ปริมาณข้อมูล และฮาร์ดแวร์ที่ต้องใช้ ติดต่อทีมงานเพื่อประเมินขอบเขตงานและขอใบเสนอราคา ตัวอย่างข้อเสนอล่าสุดวางแผนประมาณ 22 สัปดาห์ โดยช่วงดูแลหลังเริ่มใช้งานอาจต่อเนื่องเกินแผนดังกล่าว