Hubungkan aliran kerja dan pantau sistem
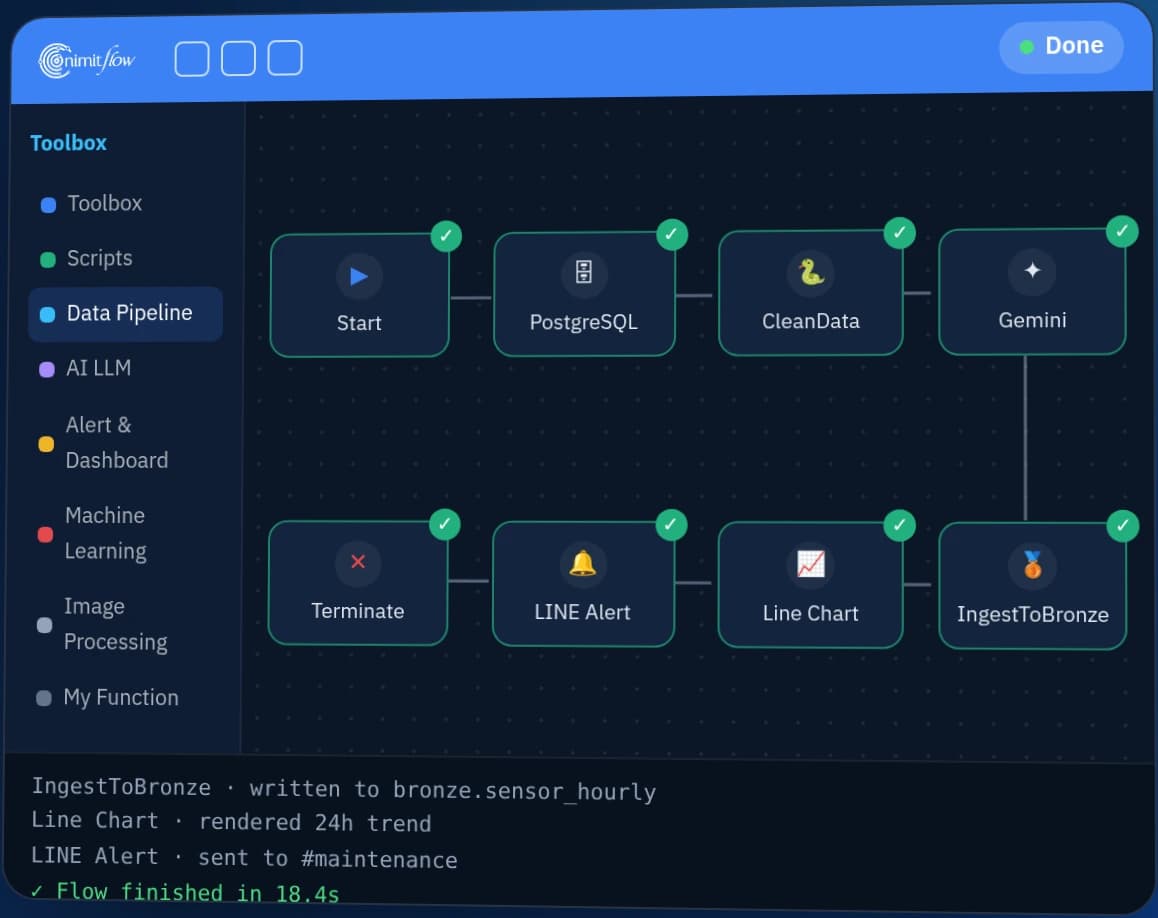
Urus aliran kerja, lihat status operasi dan hantar amaran kepada pentadbir.
- nimitFlow
- Prometheus
- Grafana
Modern Data · Repositori data organisasi
Gabungkan data ERP/MES, pangkalan data, fail dan IoT ke dalam lapisan Bronze–Silver–Gold untuk pelaporan, analitik dan AI, dengan nimitFlow menghubungkan aliran kerja serta memantau sistem.
 Hubungkan aliran kerja · Pantau status · Hantar amaran
Kekalkan data dalam format sumber supaya boleh diproses semula kemudian.
Bersihkan, buang pendua dan susun struktur data mengikut peraturan kualiti.
Ringkaskan data mengikut sudut pandang perniagaan supaya pasukan boleh menggunakannya dalam laporan dan analitik.
Kawalan akses · Kualiti data · Katalog · Asal-usul data · Log audit
Pasukan IT dan pasukan data yang perlu menyepadukan data daripada pelbagai sistem
Senarai sistem sumber, format data dan kebenaran akses yang diperlukan
Data Lakehouse menyimpan data mentah dan data sedia analisis dalam satu sistem. Data Lakehouse & Pipeline kami menyatukan data daripada sistem sedia ada, fail dan peranti pengumpul data ke repositori pusat ini. Data melalui pemeriksaan kualiti mengikut lapisan, aksesnya boleh dikawal dan asalnya boleh dijejaki. Data yang sama kemudian digunakan untuk pelaporan, analitik dan AI, termasuk Predictive Analytics dan Enterprise KM Chatbot.
Banyak organisasi menyimpan data di tempat berasingan: pangkalan data ERP/MES, fail Excel, peranti NAS dan peralatan barisan pengeluaran. Penyepaduan sering bergantung pada skrip berjadual yang sukar diselenggara, menyebabkan laporan lambat dan asal angka sukar dijejaki. Setiap kali memulakan projek AI, data perlu dikumpulkan dan dibersihkan semula.
Apakah perbezaan antara Data Lakehouse, Data Lake dan Data Warehouse?
Data Lakehouse menggabungkan kelebihan Data Lake (data mentah dalam pelbagai format dengan kos storan rendah) dan Data Warehouse (jadual berstruktur serta pertanyaan SQL pantas). Data disimpan dalam format terbuka (Parquet dan Apache Iceberg) pada storan objek S3, supaya tidak bergantung pada satu vendor.
Pendekatan lama
Data Lakehouse
Ringkasan: Data yang sama digunakan untuk pelaporan, analitik dan AI
Data Lakehouse & Pipeline berfungsi dalam 5 langkah: menghubungkan sumber, menyimpan data mentah, mengesahkan dan membersihkan, menyediakan data untuk digunakan serta membolehkan pengguna mencari data. Perisian lapisan data ialah Open Source, manakala nimitFlow bersama Prometheus/Grafana memantau sistem.
Hubungkan sumber data
Terima data daripada pangkalan data SQL (seperti Oracle, PostgreSQL dan MS SQL), API, fail, Google Sheets serta peranti IoT menggunakan Apache Airflow untuk tugas berkala dan Apache Kafka untuk aliran berterusan atau pengambilan perubahan (CDC).
Bronze — simpan data mentah
Simpan data dalam format sumber (Schema-on-read) supaya boleh diproses semula apabila peraturan berubah.
Silver — sahkan dan bersihkan
Apache Spark mengesahkan, membersihkan dan membuang pendua mengikut peraturan kualiti data (Data Quality Rule), kemudian menyimpannya dalam jadual Iceberg.
Gold — data sedia digunakan
Agregatkan dan perkaya data mengikut keperluan perniagaan supaya sedia untuk laporan BI, analitik dan AI/ML.
Gunakan data dan pantau sistem
Pengguna mencari data menggunakan SQL melalui Trino / Dremio dan menghubungkan Tableau, Power BI atau Jupyter Notebook. Pasukan IT memantau semua lapisan dalam satu paparan melalui nimitFlow bersama Prometheus/Grafana serta menerima amaran melalui LINE atau e-mel.
Storan (Storage) diasingkan daripada pengkomputeran (Compute), supaya kapasiti dan sumber pemprosesan boleh ditambah secara berasingan mengikut beban kerja tanpa menghentikan sistem. Jadual Iceberg menyokong kemas kini ACID (transaksi disimpan sepenuhnya atau tidak langsung), Time Travel untuk melihat keadaan data terdahulu dan perubahan skema tanpa membina semula jadual.
Dalam seni bina ini, data berada pada pelayan organisasi anda (On-Premise), dan pengguna hanya boleh mengakses mengikut kebenaran peranan mereka. Data berpusat memerlukan kawalan akses yang lebih ketat, maka pengesahan, pemberian kuasa, penyulitan dan perekodan akses direka sejak awal seperti disenaraikan di bawah.
Contoh kebenaran berasaskan peranan (disesuaikan bersama anda semasa reka bentuk)
| Peranan | Bronze | Silver | Gold |
|---|---|---|---|
| Jurutera data | Baca/tulis | Baca/tulis | Tulis melalui saluran data |
| Penganalisis data / BI | Tiada akses | Baca data jabatan sendiri sahaja | Baca |
| Saintis data | Baca (data peribadi disamarkan) | Baca | Baca |
| Juruaudit / Pematuhan | Baca log audit | Baca log audit | Baca + Asal-usul data |
Data Lakehouse sesuai untuk organisasi yang mempunyai data dalam banyak sistem, memerlukan laporan daripada data yang sama dan perlu menyimpannya secara dalaman. Jika jumlah atau sumber data masih terhad, pangkalan data pusat atau nimitFlow mungkin mencukupi untuk bermula. Jika mesin belum mengumpulkan data, peranti pengumpul atau sistem sumber perlu disediakan dahulu, seperti InSensor untuk data sensor. Kami menilai jumlah data dan bilangan sistem sumber sebelum mencadangkan pendekatan.
Kegunaan yang sesuai dan tidak sesuai untuk Data Lakehouse
| Pekerjaan | Adakah Data Lakehouse sesuai? | Sebab-sebab atau perkara-perkara yang perlu dilakukan |
|---|---|---|
| Data tersebar dalam beberapa sistem (ERP, MES, pangkalan data, fail), dan laporan memerlukan set data yang sama. | Sesuai | Satukan data secara berpusat dan periksa kualiti mengikut lapisan sebelum menghasilkan laporan. |
| Data perlu kekal dalam organisasi dengan kebenaran terperinci dan akses yang boleh diaudit. | Sesuai | Pasang On-Premise, urus kebenaran dengan Ranger dan simpan log audit. |
| Sediakan data pengeluaran, mesin dan kualiti untuk Predictive Analytics atau AI. | Sesuai | Tugas AI menggunakan data lapisan Gold yang telah disahkan. |
| Pasukan IT memerlukan sistem berpiawaian terbuka tanpa bergantung pada satu vendor. | Sesuai | Data disimpan sebagai Parquet / Iceberg menggunakan piawaian S3 API |
| Jumlah data masih kecil atau sumbernya sedikit. | Mungkin belum diperlukan | Mulakan dengan pangkalan data pusat atau nimitFlow, kemudian kembangkan. |
| Dasar data mewajibkan penggunaan Cloud. | Dinilai mengikut projek | Seni bina ini direka untuk pelayan dalam organisasi. |
| Mesin belum mempunyai sistem pengumpulan data. | Peranti pengumpul data atau sistem sumber diperlukan terlebih dahulu. | Data Lakehouse menerima data daripada sistem atau peranti sedia ada; ia tidak membaca isyarat mesin secara langsung. |
Kami pernah menyepadukan data pengeluaran dan pengurusan untuk pengeluar komponen automotif di Thailand serta menyediakan data transaksi untuk melatih model Machine Learning bagi organisasi sektor kewangan Thailand. Belum ada projek dengan seni bina Data Lakehouse pada halaman ini yang diserahkan; seni binanya berasal daripada cadangan terkini kami. Kerja berikut ialah pengalaman data berkaitan, bukan projek Data Lakehouse yang telah diserahkan.
Baca kajian kes projek data kami
Dasar keselamatan IT menentukan lokasi data dan rangkaian yang boleh mengaksesnya. Dalam kedua-dua projek penyepaduan data pengeluar komponen automotif, pasukan IT pelanggan menetapkan rangkaian, kebenaran pemasangan dan pemeriksaan keselamatan sistem awan. Oleh itu, reka bentuk perlu melibatkan pasukan IT sejak awal.
Angka daripada laporan lama perlu dibandingkan dengan sumber asal sebelum digunakan untuk membuat keputusan. Pengesahan data dan perubahan berdasarkan maklum balas pengguna berterusan selepas penyerahan pertama, maka perlu dirancang sejak awal. Kerja AI bermula dengan pembersihan data sebelum latihan model, dan sistem baharu wajar diasingkan daripada operasi utama supaya perkhidmatan tidak terganggu.
Projek Data Lakehouse anda bermula dengan meninjau sistem sumber dan dasar keselamatan bersama pasukan IT. Kami kemudian membina saluran Bronze hingga Gold menggunakan data perintis. Anda membandingkan angka pada lapisan Gold dengan laporan sedia ada, kemudian meluaskan kepada sumber lain selepas angkanya sepadan.
Kami merancang projek Data Lakehouse dalam 5 peringkat: reka bentuk terperinci; pemasangan pelayan dan platform; penyepaduan data serta konfigurasi keselamatan; pengujian dan mula operasi; serta sokongan selepas pelancaran dan pemindahan pengetahuan. Sokongan intensif selepas pelancaran (Hypercare) dan pemindahan pengetahuan boleh dimasukkan dalam skop yang dipersetujui supaya pasukan IT anda boleh mengambil alih operasi.
Reka bentuk terperinci
Sahkan keperluan; sediakan reka bentuk peringkat tinggi dan terperinci (HLD/LLD), matriks kebenaran, dasar pengekalan data dan pelan ujian.
Pasang pelayan dan platform
Pasang perkakasan dan Linux, kukuhkan keselamatan mengikut CIS Benchmark, kemudian pasang komponen platform.
Sepadukan data dan konfigurasikan keselamatan
Bina saluran Bronze hingga Gold dengan data perintis, hubungkan SSO dan tetapkan kebenaran, penyulitan serta audit.
Uji dan mulakan operasi
Jalankan ujian penerimaan pengguna (UAT), baiki kecacatan, kemudian laksanakan dalam persekitaran produksi.
Sokongan selepas pelancaran dan pemindahan pengetahuan
Tetapkan tempoh sokongan selepas pelancaran dan bengkel untuk setiap pasukan dalam skop yang dipersetujui.
Dokumen penyerahan disediakan dalam bahasa Thai dengan istilah teknikal bahasa Inggeris: reka bentuk sistem, panduan pemasangan, manual pentadbiran, panduan operasi harian, manual pemantauan, dokumen konfigurasi amaran, panduan penyelesaian masalah, dokumen UAT, dokumentasi As-Built dan bahan latihan.
Contoh jadual masa
Cadangan terkini kami merancang kira-kira 22 minggu, dengan Hypercare selama 60 hari selepas pelancaran yang mungkin melangkaui jadual tersebut, serta pemindahan pengetahuan sekurang-kurangnya 30 jam. Tempoh sebenar bergantung pada bilangan sumber data dan kesediaan sistem sumber.
| Nama platform | Enterprise Data Lakehouse Platform (tiada kod model — dikonfigurasi mengikut projek) |
|---|---|
| Seni bina | Open Data Lakehouse dengan lapisan Medallion (Bronze–Silver–Gold), mengasingkan Storage dan Compute |
| Format jadual / fail | Apache Iceberg (ACID, penelusuran versi terdahulu, evolusi skema) · Parquet |
| Storan | MinIO (S3-Compatible) dengan Erasure Coding dan Object Versioning |
| Kemasukan data | Apache Airflow (Batch: JDBC / API / fail) · Apache Kafka (Streaming, CDC) |
| Pemprosesan | Apache Spark dengan rangka kerja kualiti data |
| Pertanyaan data | Trino / Dremio — SQL untuk BI dan analitik |
| Katalog / Asal-usul data | OpenMetadata — katalog data, glosari perniagaan dan asal-usul data peringkat lajur |
| keselamatan | Apache Ranger (RBAC baris/lajur, Masking) · Keycloak (SSO, MFA) |
| Penyulitan | AES-256 semasa disimpan · TLS 1.2 atau lebih baharu semasa pemindahan |
| Pemantauan sistem | nimitFlow + Prometheus / Grafana — amaran LINE / e-mel |
| Format Pemasangan | On-Premise pada pelayan Linux organisasi |
Komponen mengikut seni bina dalam cadangan projek terkini Inspektion (Julai 2569 BE). Kapasiti perkakasan dan komponen disesuaikan dengan jumlah data serta skop setiap organisasi.
Perjalanan data organisasi
Ikuti aliran mengikut turutan, kemudian lihat peranan setiap teknologi di bawah. Peraturan kualiti data, kawalan akses dan pemantauan status menghubungkan setiap lapisan.
Hubungkan aliran kerja · Pantau status · Hantar amaran
ERP/MES, pangkalan data SQL, fail, API dan IoT
Data daripada pelbagai sistemAirflow mengendalikan kemasukan data berkala, manakala Kafka mengendalikan aliran berterusan dan perubahan daripada sistem sumber.
Berkala · Penstriman · CDCSpark mengesahkan dan mentransformasikan data, kemudian menyusunnya sebagai jadual Iceberg pada storan S3.
Bronze → Silver → GoldCari data menggunakan SQL melalui Trino / Dremio, kemudian sambungkan kepada laporan BI, analitik dan AI.
Pelaporan · Analitik · AInimitFlow menghubungkan aliran kerja dan memantau keseluruhan sistem bersama Prometheus / Grafana, manakala Airflow, Kafka dan Spark mengendalikan tugas data mengikut peranan masing-masing.
Kekalkan data dalam format sumber supaya boleh diproses semula kemudian.
Data mentah ERP / IoTBersihkan, buang pendua dan susun struktur data mengikut peraturan kualiti.
Data yang telah disahkan dan dihubungkanRingkaskan data mengikut sudut pandang perniagaan supaya pasukan boleh menggunakannya dalam laporan dan analitik.
Set data untuk BI / AIKawalan akses · Kualiti data · Katalog · Asal-usul data · Log audit
Komponen mengikut seni bina yang dicadangkan. Pemilihan dan kapasiti disesuaikan dengan sumber data, beban kerja dan dasar organisasi.
Urus aliran kerja, lihat status operasi dan hantar amaran kepada pentadbir.
Masukkan data secara berkala atau berterusan, kemudian sahkan dan transformasikan sebelum digunakan.
Asingkan storan daripada pengkomputeran dengan format jadual dan fail data terbuka.
Cari data menggunakan SQL dan sambungkan kepada paparan laporan atau alat penganalisis.
Bina katalog data, glosari perniagaan dan jejak asal-usul data.
Hubungkan akaun organisasi, tetapkan kebenaran, samarkan data dan audit akses.
nimitFlow, API dan antara muka untuk pasukan
Sumber Spark dan Trino diasingkan daripada storan
Storan serasi S3 berserta pelan sandaran
Ini ialah seni bina yang dicadangkan untuk projek, bukan gambaran sistem yang telah diserahkan kepada pelanggan. Kapasiti Server, sandaran dan High Availability perlu direka serta diuji mengikut skop sebenar.
Perisian lapisan data ialah Open Source; kos nimitFlow, perkakasan, sistem pengendalian dan perkhidmatan mengikut sebut harga.
Perisian lapisan data ialah Open Source; lesen nimitFlow mengikut sebut harga. Kos merangkumi perkakasan, sistem pengendalian, pemasangan, penyepaduan data dan sokongan mengikut skop.
Mulakan dengan perbincangan keperluan. Kami meninjau sistem sumber, format data dan dasar keselamatan organisasi, menentukan kapasiti sistem berdasarkan jumlah data, kemudian mencadangkan skop kerja berserta sebut harga.
Tidak. Data Lakehouse mengambil data melalui pangkalan data (JDBC), API, fail atau CDC, supaya ERP/MES sedia ada boleh terus beroperasi seperti biasa.
Perisian lapisan data tiada yuran lesen tahunan kerana ialah Open Source. nimitFlow untuk pemantauan ialah perisian Inspektion dan harganya berdasarkan sebut harga. Kos utama meliputi perkakasan, sistem pengendalian, lesen nimitFlow, pemasangan, penyepaduan data dan sokongan sistem.
Tidak. Seni bina ini direka untuk pelayan dalam organisasi (On-Premise). Jika dasar data memerlukan Cloud, kami menilai setiap projek berdasarkan dasar dan belanjawan organisasi.
Hingga peringkat baris. Apache Ranger menyokong kebenaran peringkat jadual, lajur dan baris, penyamaran data peribadi per lajur serta log audit setiap akses.
Ya. Perisian lapisan data ialah Open Source dan data menggunakan format terbuka. Bengkel pemindahan pengetahuan mengikut peranan berserta manual bahasa Thai boleh dimasukkan dalam skop. Selepas pemindahan pengetahuan, pasukan IT anda boleh mengurus dan mengembangkan sistem sendiri.
Bergantung pada bilangan sumber data, jumlah data dan perkakasan yang diperlukan. Hubungi pasukan kami untuk menentukan skop dan mendapatkan sebut harga. Contoh cadangan terkini merancang kira-kira 22 minggu, dengan sokongan selepas pelancaran yang mungkin berterusan melebihi jadual tersebut.